
 脚本プランナー▸
 AIアプリ
 AIニュース
DeepSeekオープンソース週6日目:DeepSeek-V3/R1推論システム、コスト利益率545%
小编 ·

DeepSeekオープンソース週6日目:DeepSeek-V3/R1推論システム、コスト利益率545%
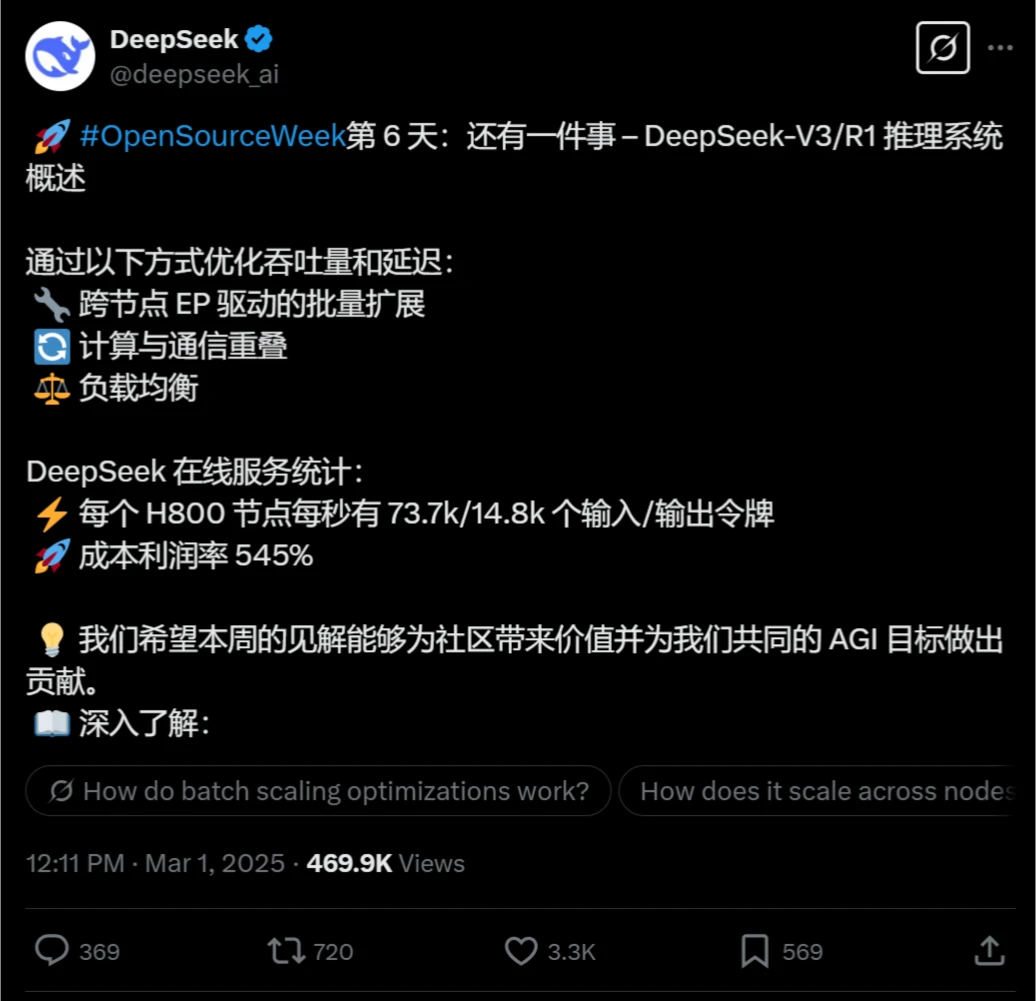
約束通り5日間のオープンソース週のはずが、土曜日にもまさかのサプライズがあり、DeepSeek-V3/R1推論システムが公開されました。
DeepSeek-V3/R1推論システムとは?
DeepSeek-V3/R1推論システムは、DeepSeekが新たに発表した高性能推論システムで、スループットとレイテンシーを最適化することで推論効率の向上を目指しています。このシステムは大規模なノード間エキスパート並列(Expert Parallelism, EP)技術を採用し、GPUマトリクス計算の効率を大幅に向上させるとともに、エキスパートモジュールを異なるGPUに分散することでレイテンシーを低減しています。
主な特徴
高スループットと低レイテンシーの最適化:
ノード間エキスパート並列(Expert Parallelism, EP)技術を採用し、バッチ処理規模を大幅に拡大し、GPUマトリクス計算の効率を向上させています。
プリフィル・デコード分離アーキテクチャにより、プリフィル段階とデコード段階でそれぞれ異なる程度の並列戦略を採用しています。
インテリジェントな負荷分散:
プリフィル段階とデコード段階でそれぞれコア注意計算と配布送信負荷の均衡を実現しています。
混合エキスパートモデル(MoE)において、各GPU上のエキスパート計算ワークロードをバランスさせています。
計算と通信のオーバーラップ処理:
デュアルバッチオーバーラップ戦略を採用し、同じバッチのリクエストを2つのマイクロバッチに分割することで、通信コストを隠蔽し全体的なスループットを向上させています。
デコード段階では、5段階パイプライン技術を採用し、計算と通信のシームレスなオーバーラップを実現しています。
大規模なノード間エキスパート並列(EP):
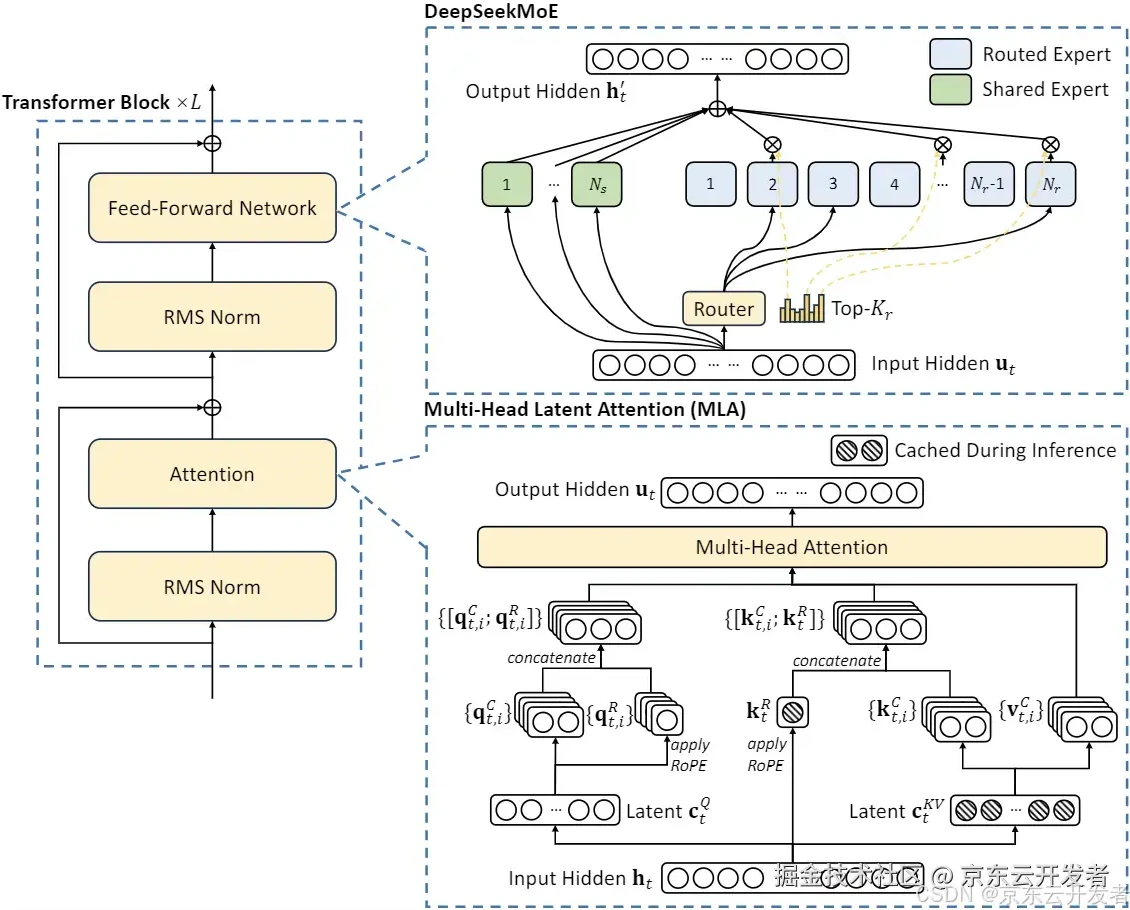
各層の256個のエキスパートのうち活性化されるのはわずか8個であり、モデルの高いスパース性という特点から、きわめて大きなバッチ処理規模が必要となります。
プリフィル段階ではルーティングエキスパートEP32およびMLA/共有エキスパートDP32を使用し、デコード段階ではルーティングエキスパートEP144およびMLA/共有エキスパートDP144を使用します。
効率的なリソース活用:
昼間のピーク時間帯にはすべてのノードに推論サービスを展開し、夜間の低負荷時間帯には推論ノードを減らしてリソースを研究やトレーニングに割り当てます。
主要技術
ノード間エキスパート並列(EP):DeepSeek-V3/R1モデルは多数のエキスパートネットワークを活性化できますが、各層で256個のエキスパートのうち8個のみを活性化し、高度にスパースな計算構造を生成します。
負荷分散:システム設計により、各ノード間の計算負荷が均等になり、すべてのリソースを効果的に活用できます。
コストと利益率:最新のモデル評価によれば、GPUレンタルコストが1時間あたり2ドルと仮定すると、総コストは1日あたり87,072ドルですが、理論上の1日の総収入は562,027ドルに達し、コスト利益率はなんと545%にも上ります
アプリケーション
オンライン推論サービス:
すべてのDeepSeek-V3/R1推論サービスはH800 GPU上で稼働し、精度はトレーニング時と一貫しています。
高スループットと低レイテンシーのオンライン推論サービスを提供し、ウェブ、APP、APIのすべてのユーザーリクエストに対応します。
商用サービスと非商用サービス:
一部のサービスは商用化を実現しており、ウェブやAPPからのアクセスは引き続き無料です。
オフピーク時間帯には自動的に夜間割引が適用され、リソース活用とコスト効率が最適化されます。
統計データ
過去24時間において、V3とR1推論サービスの合計ピークノード占有数は278ノードに達し、平均占有数は226.75ノード(各ノードには8個のH800 GPUが搭載)でした。
各H800ノードは、プリフィル段階で平均約7.37万token/秒の入力スループットを、あるいはデコード段階で約1.48万token/秒の出力スループットを提供します。
すべてのtokenがDeepSeek-R1の料金体系に基づいて課金された場合、1日の総収入は562,027ドルに達し、利益率は545%となります。
最初の5日間のオープンソースプロジェクトの振り返り
1日目:FlashMLA。NVIDIA Hopper GPU向けの効率的なデコードカーネルで、多頭潜在注意(MLA)の性能を最適化し、コンテンツ制作におけるaiツールの応答速度を大幅に向上させます。
2日目:DeepeEP。混合エキスパートモデル(MoE)のトレーニングおよび推論のための初のオープンソース通信ライブラリで、大規模分散トレーニングの通信効率を最適化し、レイテンシーを低減します。
3日目:DeepGEMM。稠密モデルおよびMoEモデルに対応するFP8計算ライブラリで、NVIDIA HopperアーキテクチャGPU専用に設計され、計算効率とハードウェア利用率を大幅に向上させます。
4日目:DualPipe。双方向パイプライン並列アルゴリズムで、V3/R1モデルのトレーニングにおける計算と通信のオーバーラップを最適化することを目的としています。EPLBは、大規模AIモデルにおけるエキスパート並列タスクの負荷不均衡問題を解決するためのエキスパート並列負荷均衡器です。
5日目:3FS。高性能分散ファイルシステムです。









