
 脚本プランナー▸
 AIアプリ
 AIニュース
DeepSeekオープンソースウィーク2日目——DeepEPを公開
小编 ·

DeepSeekオープンソースウィーク2日目——DeepEPを公開
昨日はDeepSeekのaiオープンソース週の初日で、オープンソース化されたプロジェクトはFlashMLAでした。公開から30分も経たないうちに、Githubで300以上のStarを獲得し、わずか1時間で10万ビューを超え、大きな話題となりました。本日はDeepSeekオープンソース週の2日目で、DeepSeekは2番目のプロジェクト「Deepep」をオープンソース化しました。
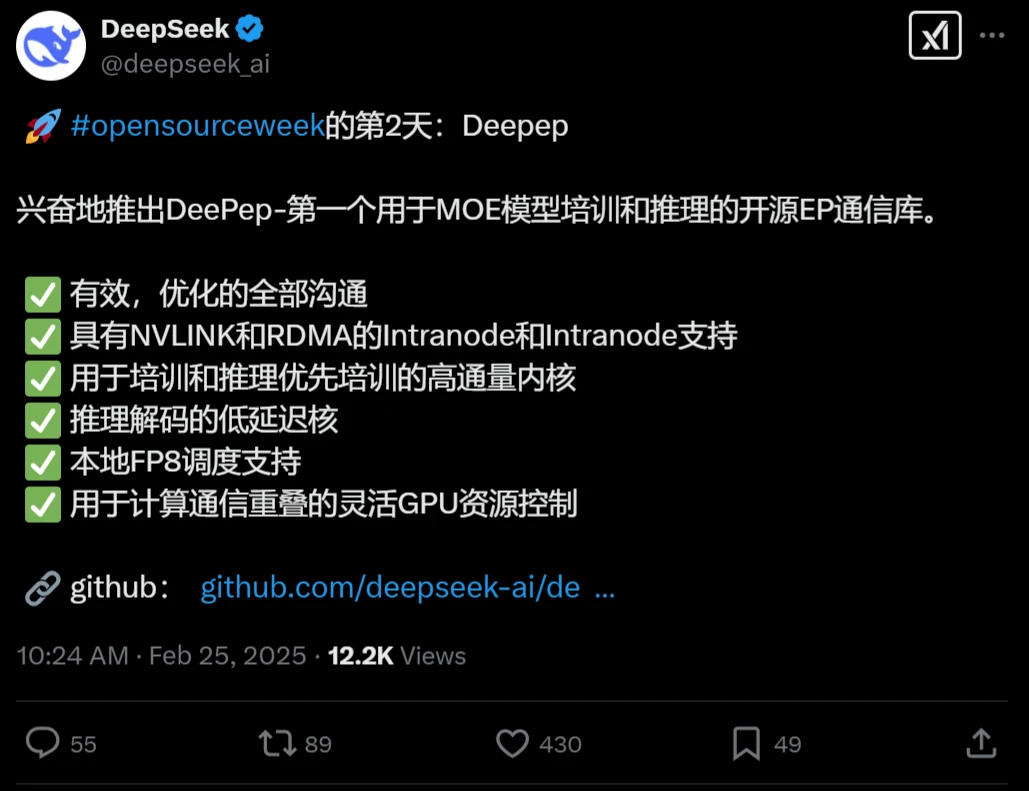
Deepepとは?
Deepepは、MOEモデルの学習および推論のためのオープンソースEP通信ライブラリです。高度な混合专家アーキテクチャに基づき、大規模データセットを活用して事前学習とファインチューニングの効率を高めます。DeepEPの設計目的は、計算負荷とメモリ使用量を削減し、ユーザーが通常のハードウェア上で大規模モデルを効率的に実行できるようにすることです。
Deepepの機能と特徴
MoEアーキテクチャの最適化:
DeepEPはMixture-of-Experts (MoE) およびExpert Parallel (EP) 専用に設計されており、学習および推論タスクに効率的なall-to-all GPUカーネルを提供します。
FP8やBF16などの低精度演算をサポートし、計算効率を向上させ、VRAM使用量を削減します。
高性能通信:
高スループットかつ低遅延の通信カーネルを提供し、NVLinkとRDMAネットワークをサポートします。H800 GPUでのテストでは、最大帯域幅はNVLinkで153 GB/s、RDMAで46 GB/sに達します。
NVLinkからRDMAへの非対称帯域幅のフォワーディングシナリオに最適化されており、高スループットを保証します。
低遅延通信:
純粋なRDMAによる低遅延カーネルを提供し、特に推論のデコード段階に適しており、遅延は163マイクロ秒まで低減されます。
hookベースの通信と計算のオーバーラップ手法を導入し、GPU SMリソースを占有せず、計算効率を最大化します。
ハードウェア最適化:
未公開のPTX命令を活用してHopperアーキテクチャのパフォーマンスを向上させます。
InfiniBandネットワークをサポートし、理論的にはRoCEとも互換性があり、柔軟なネットワーク構成オプションを提供します。
Deepepの応用シナリオ
大規模モデル学習:
Mixture-of-Experts (MoE) モデルの学習に適しており、高効率な並列通信サポートを提供し、学習効率を大幅に向上させます。
推論タスク:
遅延に敏感な推論のデコードシナリオに特に適しており、効率を大幅に向上させ、遅延を低減し、推論スループットを高めます。
高性能コンピューティングのニーズ:
現代の高性能コンピューティングのニーズに完璧に対応し、Hopper GPUアーキテクチャを含む複数のハードウェアプラットフォームをサポートし、今後さらに多くのデバイスに拡張される可能性があります。
Deepepの使用と統合
使いやすさ:
Hopper GPUアーキテクチャをサポートし、Python 3.8+、CUDA 12.3+、PyTorch 2.1+環境が必要です。
インストール時はチームが改変したバージョンのNVSHMEMと組み合わせる必要があり、詳細なインストールガイドが用意されています。
統合方法:
オープンソースで統合が容易で、数行のコマンドでビルドしてテストを実行できます。
インストール後、deep_epモジュールをインポートするだけで直接使用でき、サンプルコードとテストスクリプトが提供されています。
DeepEPはGitHubでオープンソース化されています。アドレス:https://github.com/deepseek-ai/DeepEP
1. DeepSeekオープンソース週初日のオープンソースプロジェクト:DeepSeek FlashMLA









