
 脚本プランナー▸
 AIアプリ
 AIニュース
DeepSeekオープンソースウィーク5日目:高性能分散ファイルシステム3FS
小编 ·

DeepSeekオープンソースウィーク5日目:高性能分散ファイルシステム3FS
こちらはGPT4.5が刚刚リリースされたばかりですが、DeepSeekのオープンソース週間は5日目に突入し、最終日のオープンソースプロジェクトは3FS(Fire-Flyer File System)です。
3FS(Fire-Flyer File System)とは?
3FS(Fire-Flyer File System)は、DeepSeekが自社開発した高性能分散ファイルシステムで、aiのトレーニングおよび推論ワークロードの課題を解決するために設計されています。
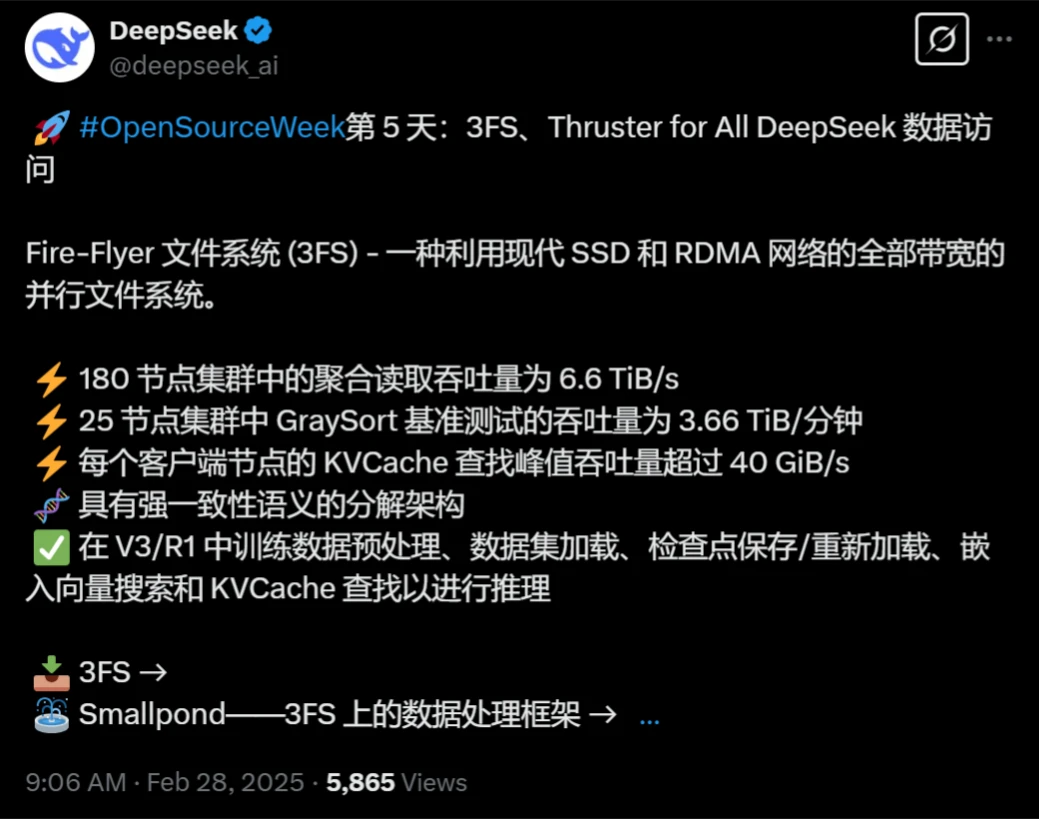
3FSの特徴
高性能:
最新のSSDとRDMAネットワークを活用し、高スループットと低遅延のデータアクセスを実現します。
数千個のSSDのスループットと数百個のストレージノードのネットワーク帯域幅を組み合わせ、アプリケーションが地域に依存しない方法でストレージリソースにアクセスできるようにします。
強い一貫性:
チェーンレプリケーションと分散クエリ(CRAQ)を実装することで強い一貫性を確保し、アプリケーションコードをより簡潔で推論しやすくします。
ファイルインターフェース:
ステートレスなメタデータサービスを採用し、背後にはトランザクション型キーバリューストア(FoundationDBなど)が支えられています。
使い慣れたファイルインターフェースにより、新しいストレージAPIを学ぶ必要がありません。
多様なワークロードサポート:
データ準備:数据分析パイプラインの出力を階層的なディレクトリ構造に整理し、大量の中間出力を効率的に管理します。
データローダー:計算ノードを跨いだトレーニングサンプルのランダムアクセスをサポートすることで、先読みやデータシャッフルの必要性を排除します。
チェックポイント:大規模トレーニング向けの高スループット並列チェックポイントをサポートします。
推論KVキャッシュ:DRAMキャッシュに代わるコスト効率の高い代替手段を提供し、より高いスループットと大幅に向上した容量を実現します。
ストレージとコンピュートの分離:
データストレージサービスとコンピュートノードを分離し、モデルトレーニングに必要なサンプルデータの保存に特化しています。
各ストレージサービスノードには15TBのSSDが16枚と高速ネットワークカードが2枚搭載されており、読み取り性能が強力、ネットワーク帯域幅が優れており、読み書き帯域幅は7.0TB/秒です。
自社開発の通信ツール:
hfreduceのように、複数GPU間の並列通信を最適化し、NVIDIAのNCCLを代替することで、PCIeのトラフィックと計算オーバーヘッドを削減します。
専用データ形式FFRecord:
複数の小ファイルを統合することで、トレーニング時に多数の小ファイルを開くオーバーヘッドを削減します。
サンプルファイルのオフセットを通じてランダムバッチ読み取り性能を向上させます。
3FSの応用
AIトレーニングおよび推論:
3FSはAIトレーニングおよび推論ワークロード専用に設計されており、これらのタスクの効率を大幅に向上させることができます。
高性能と強い一貫性により、3FSは大規模モデルのトレーニングと高スループットの推論をサポートします。
データ準備とロード:
3FSのデータ準備およびローダー機能により、大量のデータの処理がより効率的になり、先読みやデータシャッフルの必要性を削減します。
チェックポイントと推論キャッシュ:
3FSは高スループットの並列チェックポイントをサポートし、トレーニングプロセスの安定性と耐障害性を確保します。
推論KVキャッシュはコスト効率の高い代替手段を提供し、推論のスループットと容量を向上させます。
3FSの使用
インストールと設定:
3FSはGitHubのオープンソースプロジェクトを通じてインストールと設定が可能です。
データ形式の変換:
FFRecord形式を使用してデータを保存およびロードするには、サンプルデータをFFRecord形式に変換する必要があります。
FFRecord変換ツールが提供されており、ユーザーがデータ形式を簡単に行えます。
PyTorchとの統合:
3FSはPyTorchのDatasetおよびDataloaderインターフェースに適合しており、データのロードとトレーニングの開始を非常に簡単に行えます。
GitHubプロジェクトアドレス:https://github.com/deepseek-ai/3FS
これまでの4日間のオープンソースプロジェクトの振り返り
1日目:FlashMLA、NVIDIA Hopper GPU向けの効率的なデコードカーネルで、マルチヘッド潜在注意(MLA)のパフォーマンスを最適化し、コンテンツ制作におけるAIツールの応答速度を大幅に向上させます。
2日目:DeepeEP、混合エキスパートモデル(MoE)のトレーニングおよび推論向けの初のオープンソース通信ライブラリで、大規模分散トレーニングの通信効率を最適化し、遅延を低減します。
3日目:DeepGEMM、密およびMoEモデルをサポートするFP8計算ライブラリで、NVIDIA HopperアーキテクチャGPU専用に設計されており、計算効率とハードウェア利用率を大幅に向上させます。
4日目:DualPipe、V3/R1モデルのトレーニングにおける計算と通信のオーバーラップを最適化することを目的とした双方向パイプラインパラレルアルゴリズム。EPLBは、大規模AIモデルにおけるエキスパート並列タスクの負荷不均衡の問題を解決するために特別に設計されたエキスパート並列ロードバランサーです。









