
 脚本プランナー▸
 AIアプリ
 AIニュース
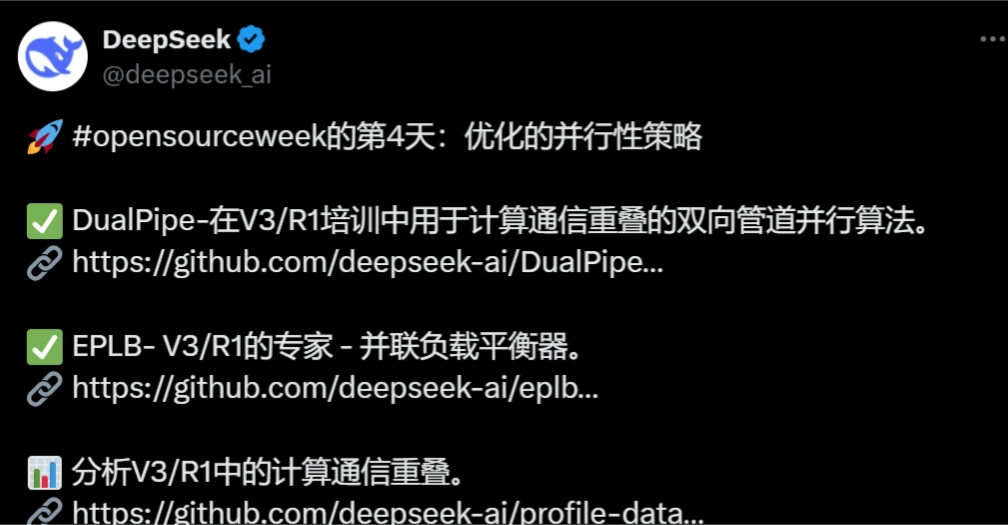
DeepSeekオープンソースウィーク4日目:DualPipe
小编 ·

DeepSeekオープンソースウィーク4日目:DualPipe
DualPipeとは?
DualPipeは、DeepSeek-V3技術レポートで初めて提案された、革新的な双方向パイプラインパラレルアルゴリズムです。前向き計算と後向き計算、通信フェーズを完全にオーバーラップさせることで、大規模モデル学習の効率とリソース利用率を大幅に向上させ、パイプライン内の「バブル」現象を効果的に削減します。
DualPipeの概要
DualPipeは、DeepSeek-V3技術レポートで初めて提案された、革新的な双方向パイプラインパラレルアルゴリズムです。前向き計算と後向き計算、通信フェーズを完全にオーバーラップさせることで、大規模モデル学習の効率とリソース利用率を大幅に向上させ、パイプライン内の「バブル」現象を効果的に削減します。
DualPipeの核心的イノベーション
計算と通信のオーバーラップ
DualPipeの核心は、双方向スケジューリングによってマイクロバッチデータを処理し、前向き計算と後向き計算、通信を完全にオーバーラップさせる点にあります。この設計により、通信の完了を待つ間に計算リソースがアイドル状態になることがなくなり、GPUの利用率が大幅に向上します。
パイプラインバブルの削減
従来のパイプラインパラレル手法(1F1BやZB1Pなど)は、大規模モデルを扱う際、計算フェーズと通信フェーズの分離により効率のボトルネックが生じることがよくあります。DualPipeは、機能モジュールの配置最適化とGPUリソース配分の精密制御により、パイプライン内のバブル現象を効果的に削減します。
メモリ使用の最適化
DualPipeはモデルのパラメータコピー2セットを保持する必要がありますが、学習プロセスでは大規模な勾配累積(EP)が採用されているため、この冗長性が顕著なメモリオーバーヘッドの増加にはつながっていません。さらに、ピーク時のアクティブメモリはわずか2倍の増加にとどまり、従来手法 비해서는。
DualPipeの実装詳細
機能モジュールの分割
各計算ブロックは4つの機能モジュール( Attention機構、全ノードデータ分散、MLP処理、全ノードデータ統合)に分割されます。後向き計算ブロックでは、AttentionとMLPモジュールはさらに入力勾配計算と重み勾配計算の2つの部分に細分化されます。
スケジューリング機構
DualPipeは、革新的な双方向パイプラインスケジューリング戦略を採用し、パイプラインの两端から同時にマイクロバッチデータを入力します。この設計により、モデル規模がさらに拡大した場合でも、適切な計算・通信比率を維持する限り、ノード間で細粒度の専門家分配を実現しつつ、全ノード通信のオーバーヘッドをほぼゼロに抑えることが可能です。
性能比較
従来の1F1BやZB1P手法と比べ、DualPipeはパイプラインの blocking削減とメモリ使用量の点で優れた性能を発揮します。「バブル」時間は大幅に短縮され、ピーク時のアクティブメモリの増加はわずかにとどまっています。この効率的なスケジューリング方式により、DualPipeは大規模並列環境下で顕著な性能優位性を持ちます。
DualPipeの応用展望
DualPipeの登場は、大規模モデル学習に効率的かつ実用的な並列学習ツールを提供します。学術研究から産業応用に至るまで、この技術がai学習分野の一層の発展を促進することが期待されます。
DualPipe GitHubアドレス:https://github.com/deepseek-ai/DualPipe
ここ3日間のオープンソースプロジェクトの振り返り
FlashMLA:NVIDIA Hopper GPU向けの高効率デコーディングカーネルで、マルチヘッド潜在アテンション(MLA)の性能を最適化し、コンテンツ制作におけるAIツールの応答速度を大幅に向上させます。
DeepeEP:混合専門家モデル(MoE)の学習と推論のための初のオープンソース通信ライブラリで、大規模分散学習の通信効率を最適化し、遅延を低減します。
DeepGEMM:高密度モデルとMoEモデルのFP8計算をサポートするライブラリで、NVIDIA HopperアーキテクチャGPU専用に設計され、計算効率とハードウェア利用率を大幅に向上させます。









