
 脚本プランナー▸
 AIアプリ
 AIニュース
FlashMLA:DeepSeekが発表した、可変長シーケンス処理に最適化した高性能MLAデコードカーネル
小编 ·

FlashMLA:DeepSeekが発表した、可変長シーケンス処理に最適化した高性能MLAデコードカーネル
FlashMLAとは?
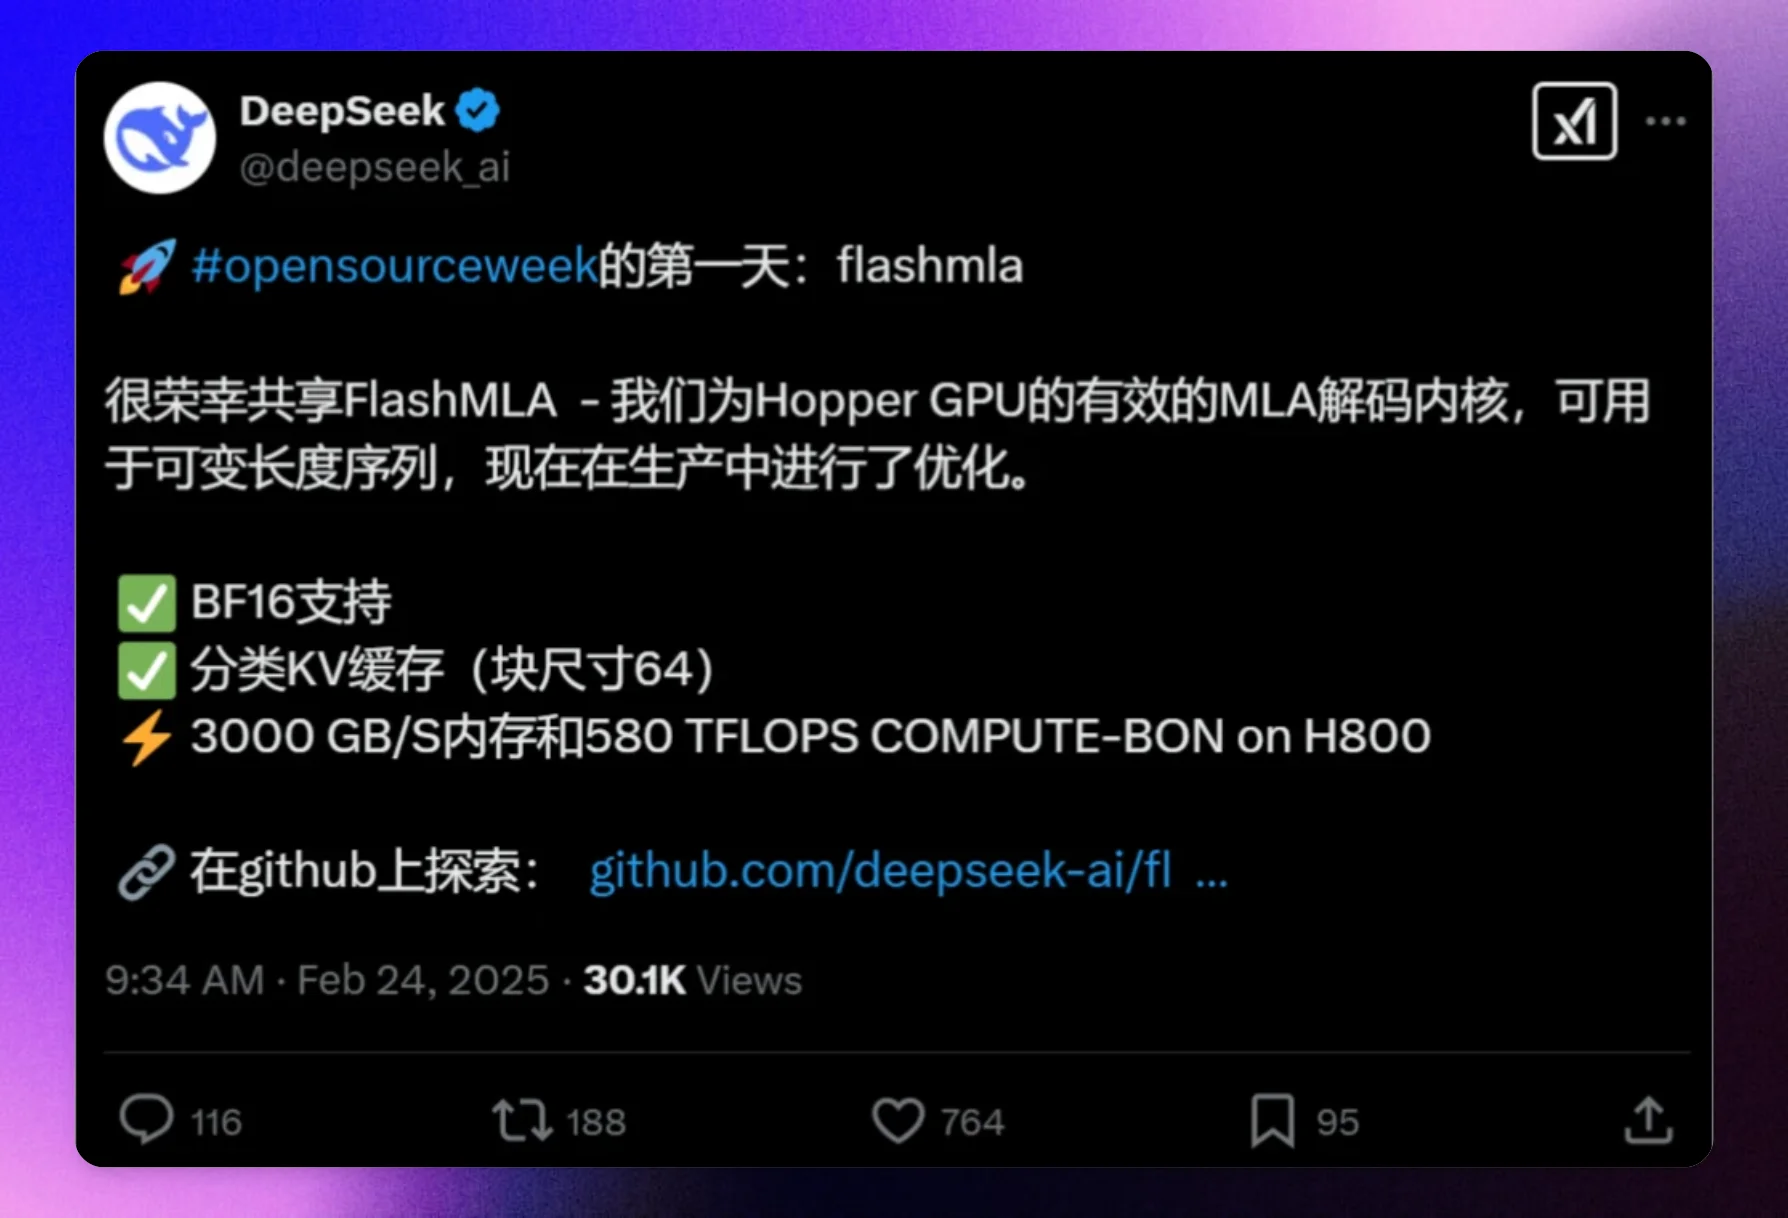
FlashMLAは、DeepSeekが2025年2月24日に発表した、NVIDIA HopperアーキテクチャGPU(H800など)向けに最適化されたMLA(Multi-Head Latent Attention)デカーネルであり、可変長シーケンスの処理サービスに特に最適化されています。
FlashMLAの主な特徴:
BF16サポート:FlashMLAはBF16(Bfloat16)データ型をサポートしており、計算とメモリ使用においてより効率的です。
ページングKVキャッシュ:ページング機構でKVキャッシュを管理し、ブロックサイズは64であるため、大規模シーケンスを効率的に処理できます。
高性能:FlashMLAのメモリ帯域は3000 GB/s(メモリボトルネック時)に達し、計算性能は580 TFLOPS(計算ボトルネック時、BF16データ型に基づく)に達します。
FlashMLAの技術的背景:
FlashMLAの登場は、大規模言語モデルが推論プロセスで直面する計算とメモリのボトルネック問題を解決するためでした。従来のマルチヘッド注意機構(MHA)は、長いシーケンスを処理する際に、KVキャッシュを保存するために大量のメモリを必要とし、限られたハードウェアリソース上でのモデル展開を制限していました。MLAは潜在的注意機構を導入することで、KVキャッシュのサイズを削減しながらモデルの性能を維持しています。
FlashMLAの応用シナリオ:
FlashMLAは、大規模言語モデル(LLM)の推論など、高効率なデコードが必要な自然言語処理(NLP)タスクに特に適しています。可変長シーケンスに最適化されており、実際の本番環境で検証されているため、高性能コンピューティングのニーズに特に適しています。
FlashMLAの技術実装
低ランク圧縮:MLAは低ランク行列分解によりKVキャッシュを効果的に圧縮し、メモリ使用量を削減します。
KVキャッシュ最適化:KVキャッシュ機構を最適化し、ハードウェアリソースの要件を大幅に低減することで、推論コストを削減します。
並列デコード:並列デコード機構を導入し、複数のトークンを同時に処理できるようにすることで、推論速度を大幅に向上させます。
FlashMLAによる性能向上
FlashMLAを採用した後、DeepSeekは自然言語処理タスクにおける精度が約5%向上し、推論速度が20%向上し、計算リソース消費が15%削減されました。これらの改善により、DeepSeekは対話型aiやリアルタイム翻訳などのリアルタイムインタラクションのシナリオで優れたパフォーマンスを発揮します。
FlashMLAのインストールと使用
動作環境要件:
HopperアーキテクチャGPU(NVIDIA A100など)
CUDA 12.3以上
PyTorch 2.0以上
1. まず、FlashMLAライブラリをインストールする必要があります。以下のコマンドでインストールできます:
git clone https://github.com/deepseek-ai/FlashMLA.git
cd FlashMLA
python setup.py install
または、すでにリポジトリをクローン済みで再ビルドしたい場合は:
python setup.py clean --all && python setup.py build_ext --inplace
2. MLAメタデータの取得
FlashMLAを使用する前に、MLAのメタデータを取得する必要があります。これには通常、入力テンソルやその他必要なパラメータの準備が含まれます。
from flash_mla import get_mla_metadata, flash_mla_with_kvcache

# すでに cache_seqlens やその他の関連変数があると仮定
cache_seqlens = [...]  # 各シーケンスの長さのリスト
s_q = ...              # クエリ次元
h_q = ...              # ヘッド数
h_kv = ...             # KVヘッド数

tile_scheduler_metadata, num_splits = get_mla_metadata(cache_seqlens, s_q * h_q // h_kv, h_kv)
3. MLAデコードの実行
次に、MLAデコード操作を実行します。クエリ行列q_i、KVキャッシュkvcache_i、ブロックテーブルblock_tableなど、必要なコンポーネントがすでに揃っているものと仮定します。
dv = ...               # 出力次元

for i in range(num_layers):  # 各層をループ
    o_i, lse_i = flash_mla_with_kvcache(
        q_i[i],                # 現在の層のクエリ行列
        kvcache_i[i],           # 現在の層のKVキャッシュ
        block_table,            # ブロックテーブル
        cache_seqlens,          # キャッシュシーケンス長
        dv,                     # 出力次元
        tile_scheduler_metadata,# MLAメタデータ
        num_splits,             # 分割数
        causal=True             # 因果マスクを使用するか
    )
    # 出力結果 o_i と lse_i の処理を続ける
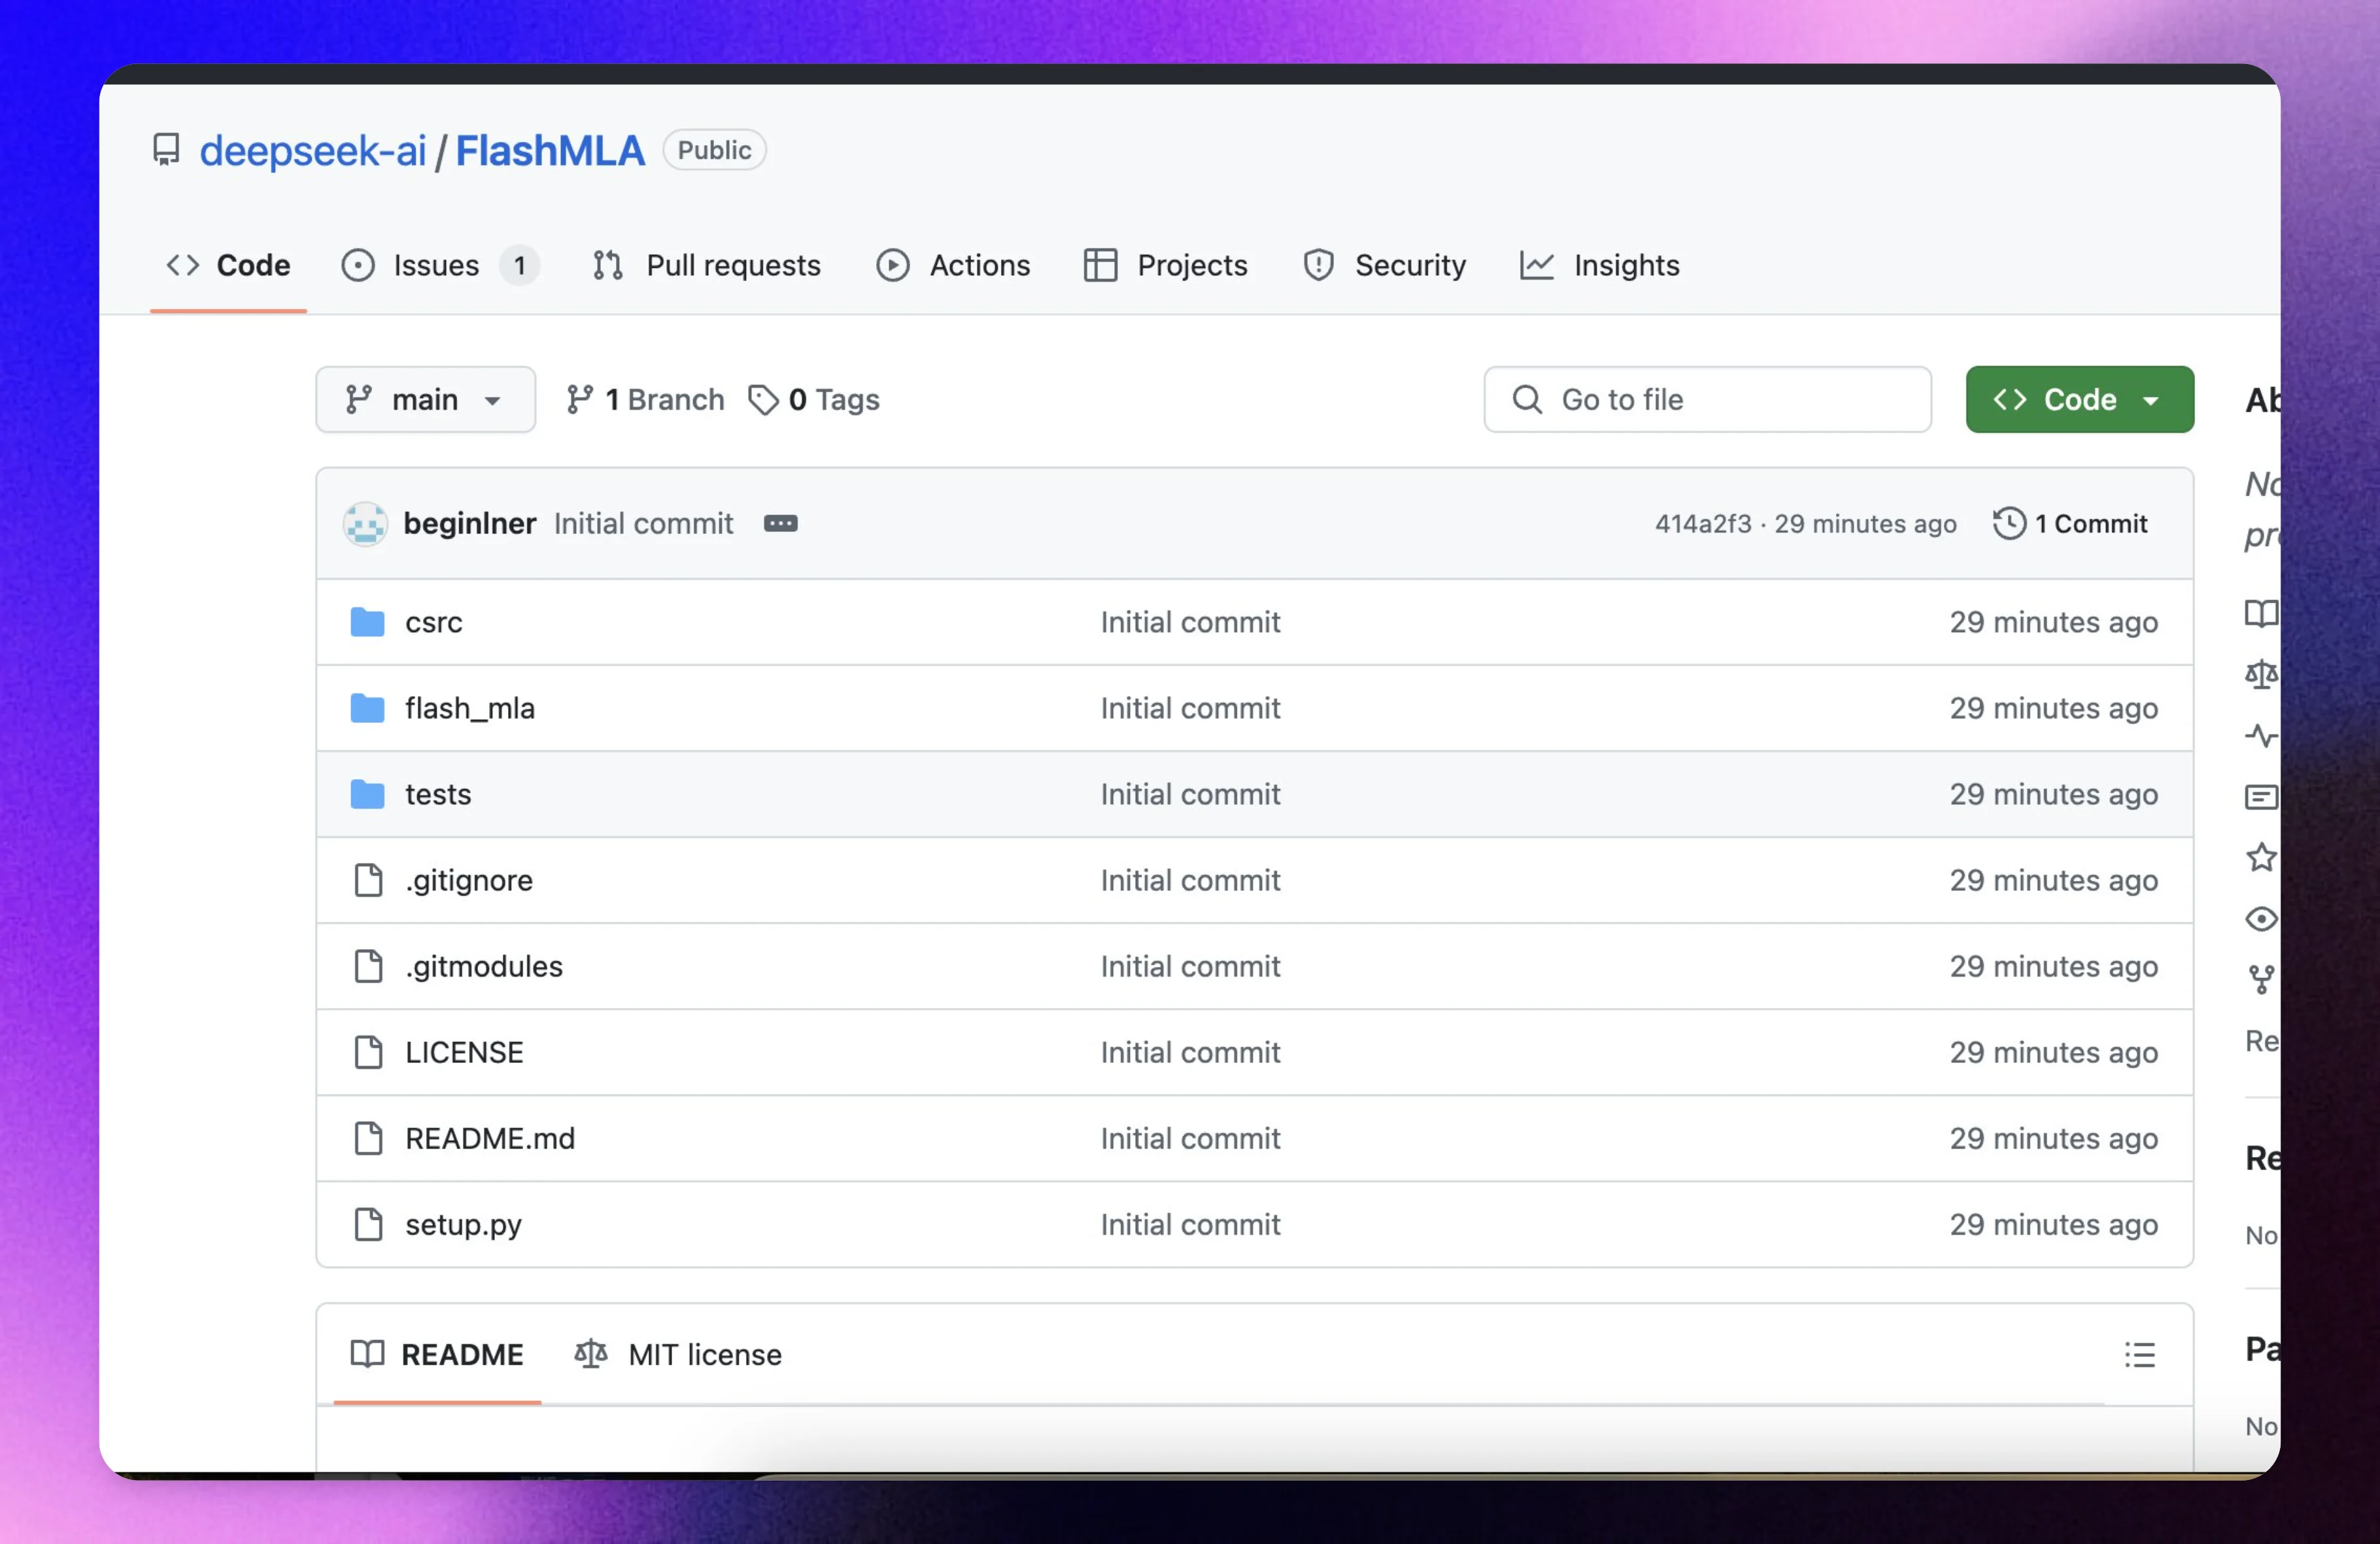
FlashMLA github:https://github.com/deepseek-ai/FlashMLA









