
 Помощник сценариста▸
 AI Приложения
 AI Новости
Шестой день Open Source Week DeepSeek: система инференса DeepSeek-V3/R1 с маржой прибыли 545%
小编 ·

Шестой день Open Source Week DeepSeek: система инференса DeepSeek-V3/R1 с маржой прибыли 545%
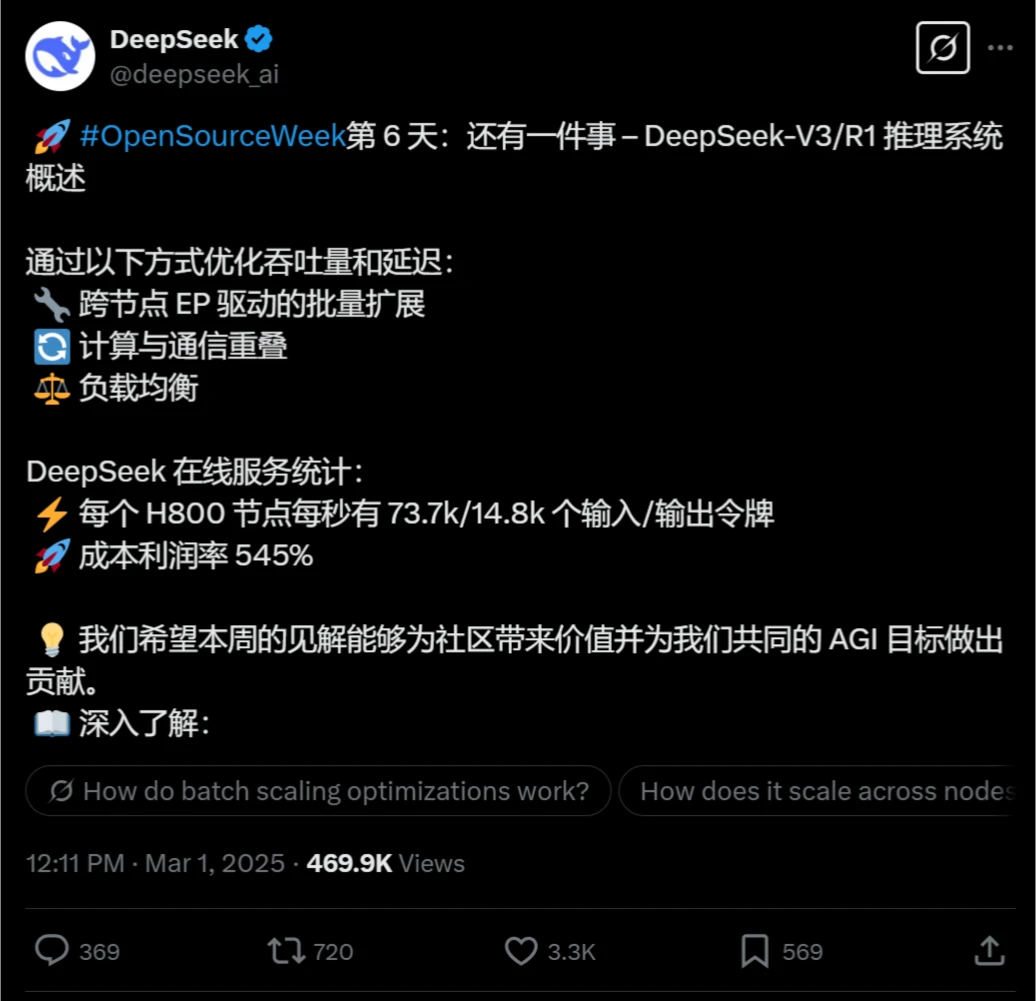
Обещали пять дней открытого кода в течение недели, но кто бы мог подумать — в субботу вышел ещё и «пасхальное яйцо»: была представлена система инференса DeepSeek-V3/R1.
Что такое система инференса DeepSeek-V3/R1?
Система инференса DeepSeek-V3/R1 — это новейшая высокопроизводительная система инференса от DeepSeek, призванная повысить эффективность инференса за счёт оптимизации пропускной способности и задержки. Система использует технологию масштабного межузлового экспертного параллелизма (Expert Parallelism, EP), что значительно повышает эффективность матричных вычислений на GPU и снижает задержку благодаря распределению экспертных модулей между разными GPU.
Основные особенности
Оптимизация высокой пропускной способности и низкой задержки:
Применяется технология межузлового экспертного параллелизма (Expert Parallelism, EP), что значительно увеличивает размер пакета и повышает эффективность матричных вычислений на GPU.
Благодаря архитектуре с разделением предзаполнения и декодирования, на этих двух этапах используются разные стратегии параллелизма.
Интеллектуальная балансировка нагрузки:
На этапах предзаполнения и декодирования достигается балансировка основных вычислений внимания и нагрузки по рассылке.
В моделях со смесью экспертов (MoE) балансируется вычислительная нагрузка экспертов на каждом GPU.
Перекрытие вычислений и обмена данными:
Применяется стратегия двойного пакета (dual-batch), при которой один и тот же пакет запросов разбивается на два микропакета, чтобы скрыть расходы на обмен данными и повысить общую пропускную способность.
На этапе декодирования применяется пятиэтапный конвейер, обеспечивающий бесшовное перекрытие вычислений и обмена данными.
Масштабный межузловой экспертный параллелизм (EP):
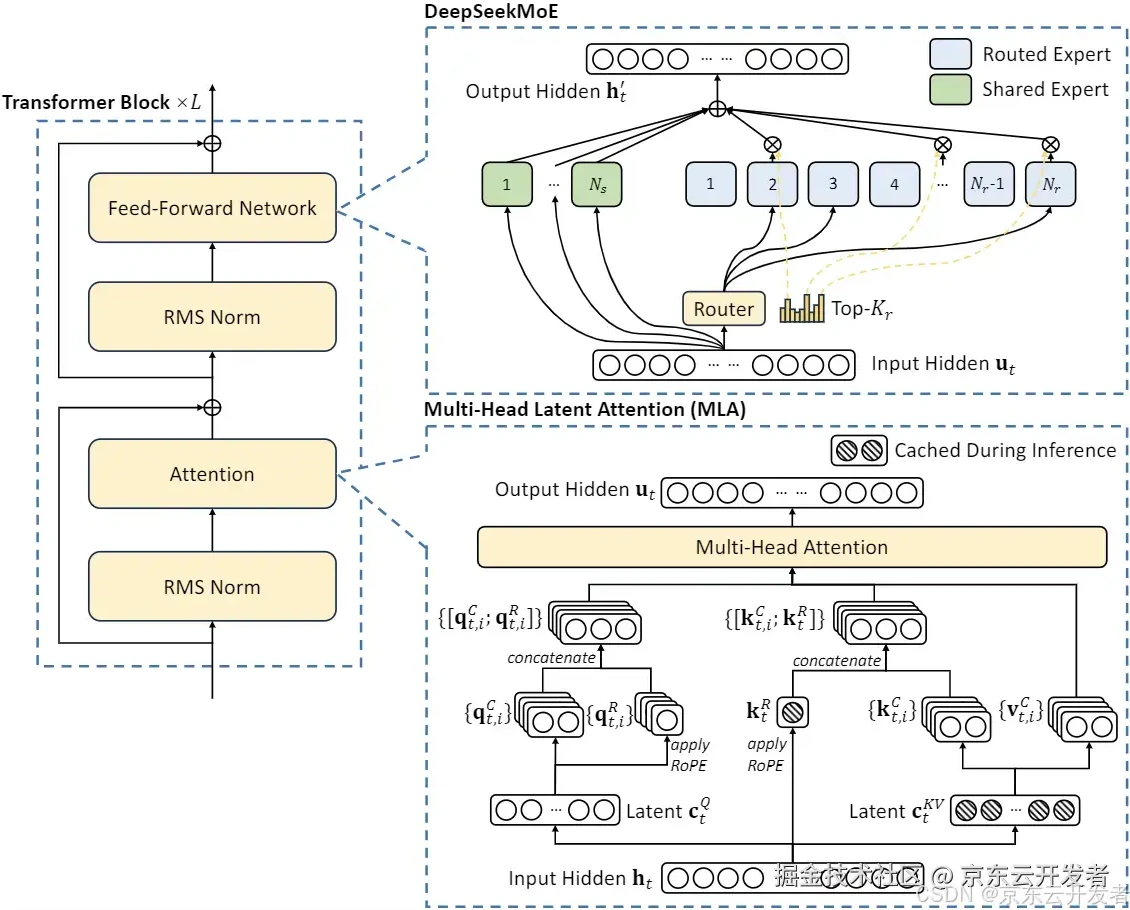
Из 256 экспертов каждого слоя активируются лишь 8, поэтому высокая разреженность модели требует очень большого общего размера пакета.
На этапе предзаполнения используются маршрутный эксперт EP32 и MLA/общий эксперт DP32, а на этапе декодирования — маршрутный эксперт EP144 и MLA/общий эксперт DP144.
Эффективное использование ресурсов:
В дневные часы пиковой нагрузки все узлы задействованы для обслуживания инференса; в ночные часы малой нагрузки число узлов инференса сокращается, а ресурсы направляются на исследования и обучение.
Ключевые технологии
Межузловой экспертный параллелизм (EP): модели DeepSeek-V3/R1 способны активировать большое число экспертных сетей, но из 256 экспертов каждого слоя активируется лишь 8, что формирует высокоразреженную вычислительную структуру.
Балансировка нагрузки: архитектура системы обеспечивает равномерное распределение вычислительной нагрузки между узлами, что позволяет эффективно задействовать все ресурсы.
Стоимость и рентабельность: согласно последней оценке модели, при стоимости аренды GPU 2 доллара в час общие затраты составляют 87 072 доллара в день, тогда как теоретический дневной доход может достигать 562 027 долларов, а рентабельность — до 545%.
Применение
Сервис онлайн-инференса:
Все сервисы инференса DeepSeek-V3/R1 работают на GPU H800, с точностью, идентичной обучению.
Обеспечивается онлайн-инференс с высокой пропускной способностью и низкой задержкой для всех пользовательских запросов через веб-интерфейс, приложение и API.
Коммерческие и некоммерческие сервисы:
Часть сервисов монетизирована, при этом доступ через веб-интерфейс и приложение остаётся бесплатным.
В непиковые часы автоматически применяются ночные скидки, что оптимизирует использование ресурсов и экономическую эффективность.
Статистические данные
За последние 24 часа суммарное пиковое число занятых узлов для сервисов инференса V3 и R1 достигло 278, а среднее занятие составило 226,75 узла (каждый узел содержит 8 GPU H800).
Каждый узел H800 обеспечивает среднюю пропускную способность примерно 73 700 токенов в секунду на входе на этапе предзаполнения или около 14 800 токенов в секунду на выходе на этапе декодирования.
Если все токены тарифицировать по ценам DeepSeek-R1, ежедневный доход достигнет 562 027 долларов при рентабельности 545%.
Обзор проектов открытого кода за первые пять дней
Первый день: FlashMLA — эффективное ядро декодирования для GPU NVIDIA Hopper, оптимизирующее производительность многоголового латентного внимания (MLA) и значительно повышающее скорость отклика AI-инструментов при создании контента.
Второй день: DeepeEP — первая открытая библиотека коммуникаций для обучения и инференса моделей со смесью экспертов (MoE), оптимизирующая эффективность обмена данными при масштабном распределённом обучении и снижающая задержку.
Третий день: DeepGEMM — библиотека FP8-вычислений для плотных моделей и MoE, разработанная специально для GPU архитектуры NVIDIA Hopper, значительно повышающая вычислительную эффективность и использование оборудования.
Четвёртый день: DualPipe — алгоритм двунаправленного конвейерного параллелизма, предназначенный для оптимизации перекрытия вычислений и обмена данными при обучении моделей V3/R1. EPLB — балансировщик нагрузки экспертного параллелизма, специально созданный для решения проблемы дисбаланса нагрузки задач экспертного параллелизма в крупномасштабных моделях ИИ.
Пятый день: 3FS — высокопроизводительная распределённая файловая система.









