
 Помощник сценариста▸
 AI Приложения
 AI Новости
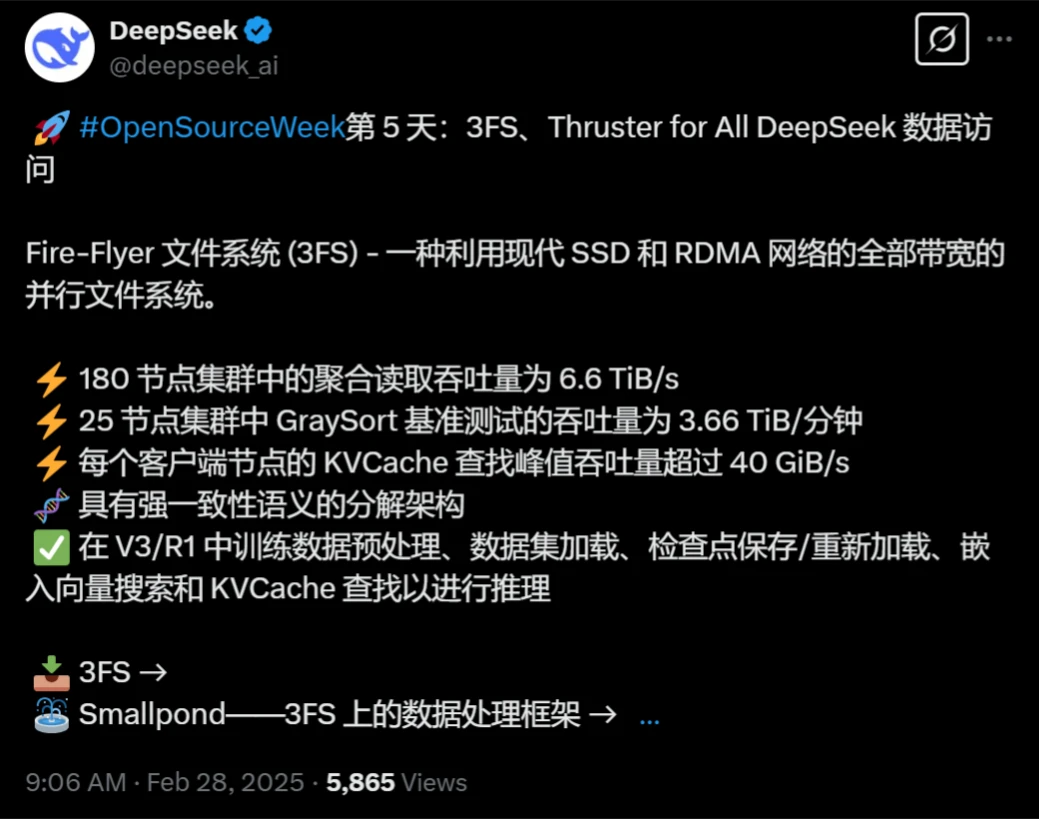
DeepSeek Open Source Week, день 5: 3FS — высокопроизводительная распределённая файловая система
小编 ·

DeepSeek Open Source Week, день 5: 3FS — высокопроизводительная распределённая файловая система
Только что вышел GPT4.5, а у DeepSeek продолжается неделя открытого исходного кода, и на пятый день представлен проект с открытым исходным кодом: 3FS (Fire-Flyer File System).
Что такое 3FS (Fire-Flyer File System)?
3FS (Fire-Flyer File System) — это высокопроизводительная распределённая файловая система, разработанная DeepSeek самостоятельно, специально созданная для решения задач рабочих нагрузок при обучении и инференсе ИИ.
Особенности 3FS
Высокая производительность:
Использует современные SSD и сети RDMA, обеспечивая высокую пропускную способность и низкую задержку доступа к данным.
Объединяет пропускную способность тысяч SSD и сетевую пропускную способность сотен узлов хранения, позволяя приложениям получать доступ к ресурсам хранения без учёта их расположения.
Строгая согласованность:
Реализует цепочную репликацию с распределёнными запросами (CRAQ), обеспечивая строгую согласованность, что делает код приложений проще и удобнее для анализа.
Файловый интерфейс:
Использует stateless-сервис метаданных, в основе которого лежит транзакционное хранилище «ключ-значение» (например, FoundationDB).
Знакомый файловый интерфейс, не нужно изучать новые API хранения.
Подготовка данных: организация выходных данных конвейера анализа данных в иерархическую структуру каталогов для эффективного управления большим количеством промежуточных результатов.
Загрузчики данных: поддержка произвольного доступа к обучающим выборкам между вычислительными узлами устраняет необходимость предварительного чтения и перемешивания данных.
Контрольные точки: поддержка параллельных контрольных точек с высокой пропускной способностью для крупномасштабного обучения.
KV-кэш для инференса: экономически эффективная альтернатива DRAM-кэшу с более высокой пропускной способностью и значительно увеличенной ёмкостью.
Разделение хранения и вычислений:
Сервис хранения данных отделён от вычислительных узлов и предназначен для хранения выборок данных, необходимых для обучения моделей.
Каждый узел сервиса хранения оснащён 16 SSD-дисками по 15 ТБ и 2 высокоскоростными сетевыми картами, обеспечивая мощные возможности чтения и высокую пропускную способность сети: пропускная способность чтения/записи — 7,0 ТБ/с.
Собственные коммуникационные инструменты:
Например, hfreduce, оптимизирующий многоGPU-параллельную коммуникацию и заменяющий NCCL от NVIDIA, что снижает трафик PCIe и вычислительные издержки.
Специализированный формат данных FFRecord:
Объединение множества мелких файлов сокращает накладные расходы на открытие большого количества мелких файлов при обучении.
Использование смещений в файлах выборок повышает производительность случайного пакетного чтения.
Применение 3FS
Обучение и инференс ИИ:
3FS специально разработан для рабочих нагрузок обучения и инференса ИИ и способен значительно повысить эффективность этих задач.
Благодаря высокой производительности и строгой согласованности 3FS поддерживает крупномасштабное обучение моделей и инференс с высокой пропускной способностью.
Подготовка и загрузка данных:
Функции подготовки и загрузки данных в 3FS делают обработку больших объёмов данных более эффективной и сокращают необходимость предварительного чтения и перемешивания данных.
Контрольные точки и кэш для инференса:
3FS поддерживает параллельные контрольные точки с высокой пропускной способностью, обеспечивая стабильность и отказоустойчивость процесса обучения.
KV-кэш для инференса предлагает экономически эффективную альтернативу, повышая пропускную способность и ёмкость инференса.
Использование 3FS
Установка и настройка:
3FS можно установить и настроить через проект с открытым исходным кодом на GitHub.
Преобразование формата данных:
Для хранения и загрузки данных используется формат FFRecord, поэтому выборки данных необходимо преобразовать в формат FFRecord.
Предоставляется инструмент преобразования FFRecord для удобства пользователей.
Интеграция с PyTorch:
3FS адаптирован под интерфейсы Dataset и Dataloader PyTorch, что позволяет очень удобно загружать данные и запускать обучение.
Адрес проекта на GitHub:https://github.com/deepseek-ai/3FS
Обзор проектов первых четырёх дней
День первый: FlashMLA — эффективное ядро декодирования для GPU NVIDIA Hopper, оптимизирующее производительность многоголового латентного внимания (MLA) и значительно повышающее скорость отклика ИИ-инструментов при создании контента.
День второй: DeepeEP — первая коммуникационная библиотека с открытым исходным кодом для обучения и инференса моделей со смесью экспертов (MoE), оптимизирующая эффективность коммуникаций при крупномасштабном распределённом обучении и снижающая задержку.
День третий: DeepGEMM — библиотека вычислений FP8 для плотных моделей и моделей MoE, специально разработанная для GPU архитектуры NVIDIA Hopper, значительно повышающая эффективность вычислений и использование оборудования.
День четвёртый: DualPipe — алгоритм двунаправленного конвейерного параллелизма, предназначенный для оптимизации перекрытия вычислений и коммуникаций при обучении моделей V3/R1. EPLB — балансировщик нагрузки экспертного параллелизма, специально созданный для решения проблемы дисбаланса нагрузки задач экспертного параллелизма в крупномасштабных моделях ИИ.









