
 Помощник сценариста▸
 AI Приложения
 AI Новости
FlashMLA: эффективное ядро декодирования MLA от DeepSeek, оптимизированное для последовательностей переменной длины
小编 ·

FlashMLA: эффективное ядро декодирования MLA от DeepSeek, оптимизированное для последовательностей переменной длины
Что такое FlashMLA?
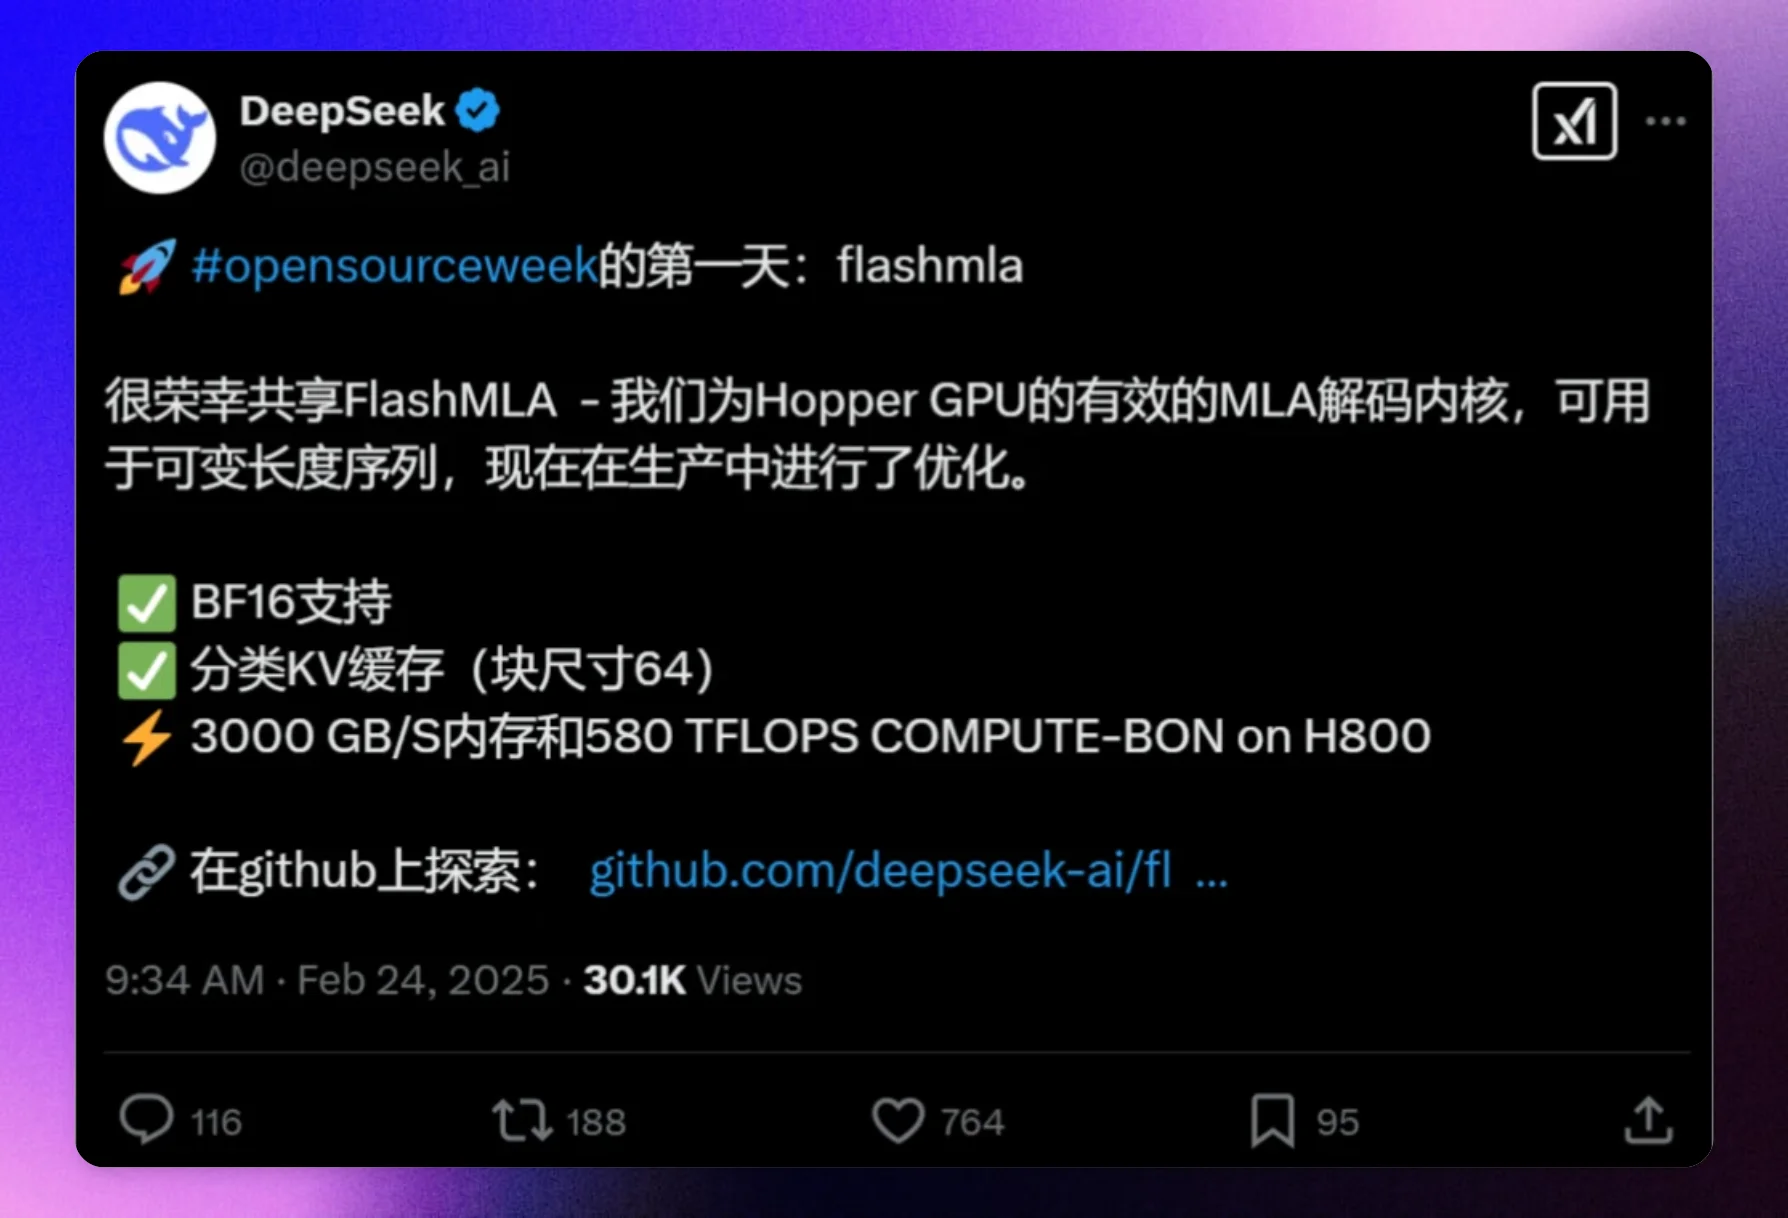
FlashMLA — это ядро декодирования MLA (Multi-Head Latent Attention), выпущенное DeepSeek 24 февраля 2025 года и оптимизированное для GPU архитектуры NVIDIA Hopper (например, H800). Оно специально оптимизировано для обработки сервисов с последовательностями переменной длины.
Основные особенности FlashMLA:
Поддержка BF16: FlashMLA поддерживает тип данных BF16 (Bfloat16), что делает его более эффективным с точки зрения вычислений и использования памяти.
Страничный KV-кэш: управление ключ-значение (KV) кэшем осуществляется с помощью механизма пейджинга с размером блока 64, что позволяет эффективно обрабатывать крупномасштабные последовательности.
Высокая производительность: пропускная способность памяти FlashMLA может достигать 3000 ГБ/с (в сценариях, ограниченных памятью), а вычислительная производительность — 580 TFLOPS (в сценариях, ограниченных вычислениями, на основе типа данных BF16).
Технический контекст FlashMLA:
Появление FlashMLA обусловлено необходимостью решения проблем узких мест в вычислениях и памяти, с которыми сталкиваются большие языковые модели в процессе инференса. Традиционный механизм многоголового внимания (MHA) при обработке длинных последовательностей требует большого объёма памяти для хранения пар ключ-значение (KV) в кэше, что ограничивает развёртывание модели на оборудовании с ограниченными ресурсами. MLA за счёт введения механизма латентного внимания уменьшает размер KV-кэша, сохраняя при этом производительность модели.
Сценарии применения FlashMLA:
FlashMLA особенно подходит для задач обработки естественного языка (NLP), требующих эффективного декодирования, таких как инференс больших языковых моделей (LLM). Он оптимизирован для последовательностей переменной длины и прошёл проверку в реальных производственных средах, что делает его идеальным для задач с высокими требованиями к вычислительной производительности.
Техническая реализация FlashMLA
Низкоранговое сжатие: MLA обеспечивает эффективное сжатие KV-кэша с помощью низкоранговой матричной декомпозиции, что снижает потребление памяти.
Оптимизация KV-кэша: оптимизация механизма KV-кэша значительно снижает требования к аппаратным ресурсам и, как следствие, уменьшает стоимость инференса.
Параллельное декодирование: введён механизм параллельного декодирования, позволяющий одновременно обрабатывать несколько токенов, что значительно повышает скорость инференса.
Повышение производительности FlashMLA
После внедрения FlashMLA компания DeepSeek добилась повышения точности в задачах обработки естественного языка примерно на 5%, увеличения скорости инференса на 20% и снижения потребления вычислительных ресурсов на 15%. Эти улучшения позволили DeepSeek показывать лучшие результаты в сценариях взаимодействия в реальном времени (таких как диалоговый ai, перевод в реальном времени).
Установка и использование FlashMLA
Системные требования:
GPU архитектуры Hopper (например, NVIDIA A100)
CUDA 12.3 и выше
PyTorch 2.0 и выше
1. Прежде всего, необходимо установить библиотеку FlashMLA. Это можно сделать с помощью следующей команды:
git clone https://github.com/deepseek-ai/FlashMLA.git
cd FlashMLA
python setup.py install
Или, если репозиторий уже клонирован и требуется пересборка:
python setup.py clean --all && python setup.py build_ext --inplace
2. Получение метаданных MLA
Перед использованием FlashMLA необходимо получить метаданные MLA. Обычно это включает подготовку входных тензоров и других необходимых параметров.
from flash_mla import get_mla_metadata, flash_mla_with_kvcache

# Предполагается, что у вас уже есть cache_seqlens и другие необходимые переменные
cache_seqlens = [...]  # список длин каждой последовательности
s_q = ...              # размерность запроса
h_q = ...              # количество голов
h_kv = ...             # количество голов ключ-значение

tile_scheduler_metadata, num_splits = get_mla_metadata(cache_seqlens, s_q * h_q // h_kv, h_kv)
3. Выполнение декодирования MLA
Далее можно выполнить операцию декодирования MLA. Предполагается, что у вас уже есть необходимые компоненты: матрица запросов q_i, кэш ключ-значение kvcache_i, таблица блоков block_table и т.д.
dv = ...               # размерность выхода

for i in range(num_layers):  # цикл по каждому слою
    o_i, lse_i = flash_mla_with_kvcache(
        q_i[i],                # матрица запросов текущего слоя
        kvcache_i[i],           # кэш ключ-значение текущего слоя
        block_table,            # таблица блоков
        cache_seqlens,          # длины кэшированных последовательностей
        dv,                     # размерность выхода
        tile_scheduler_metadata,# метаданные MLA
        num_splits,             # количество разбиений
        causal=True             # использовать ли причинно-следственную маску
    )
    # Продолжайте обработку выходных результатов o_i и lse_i
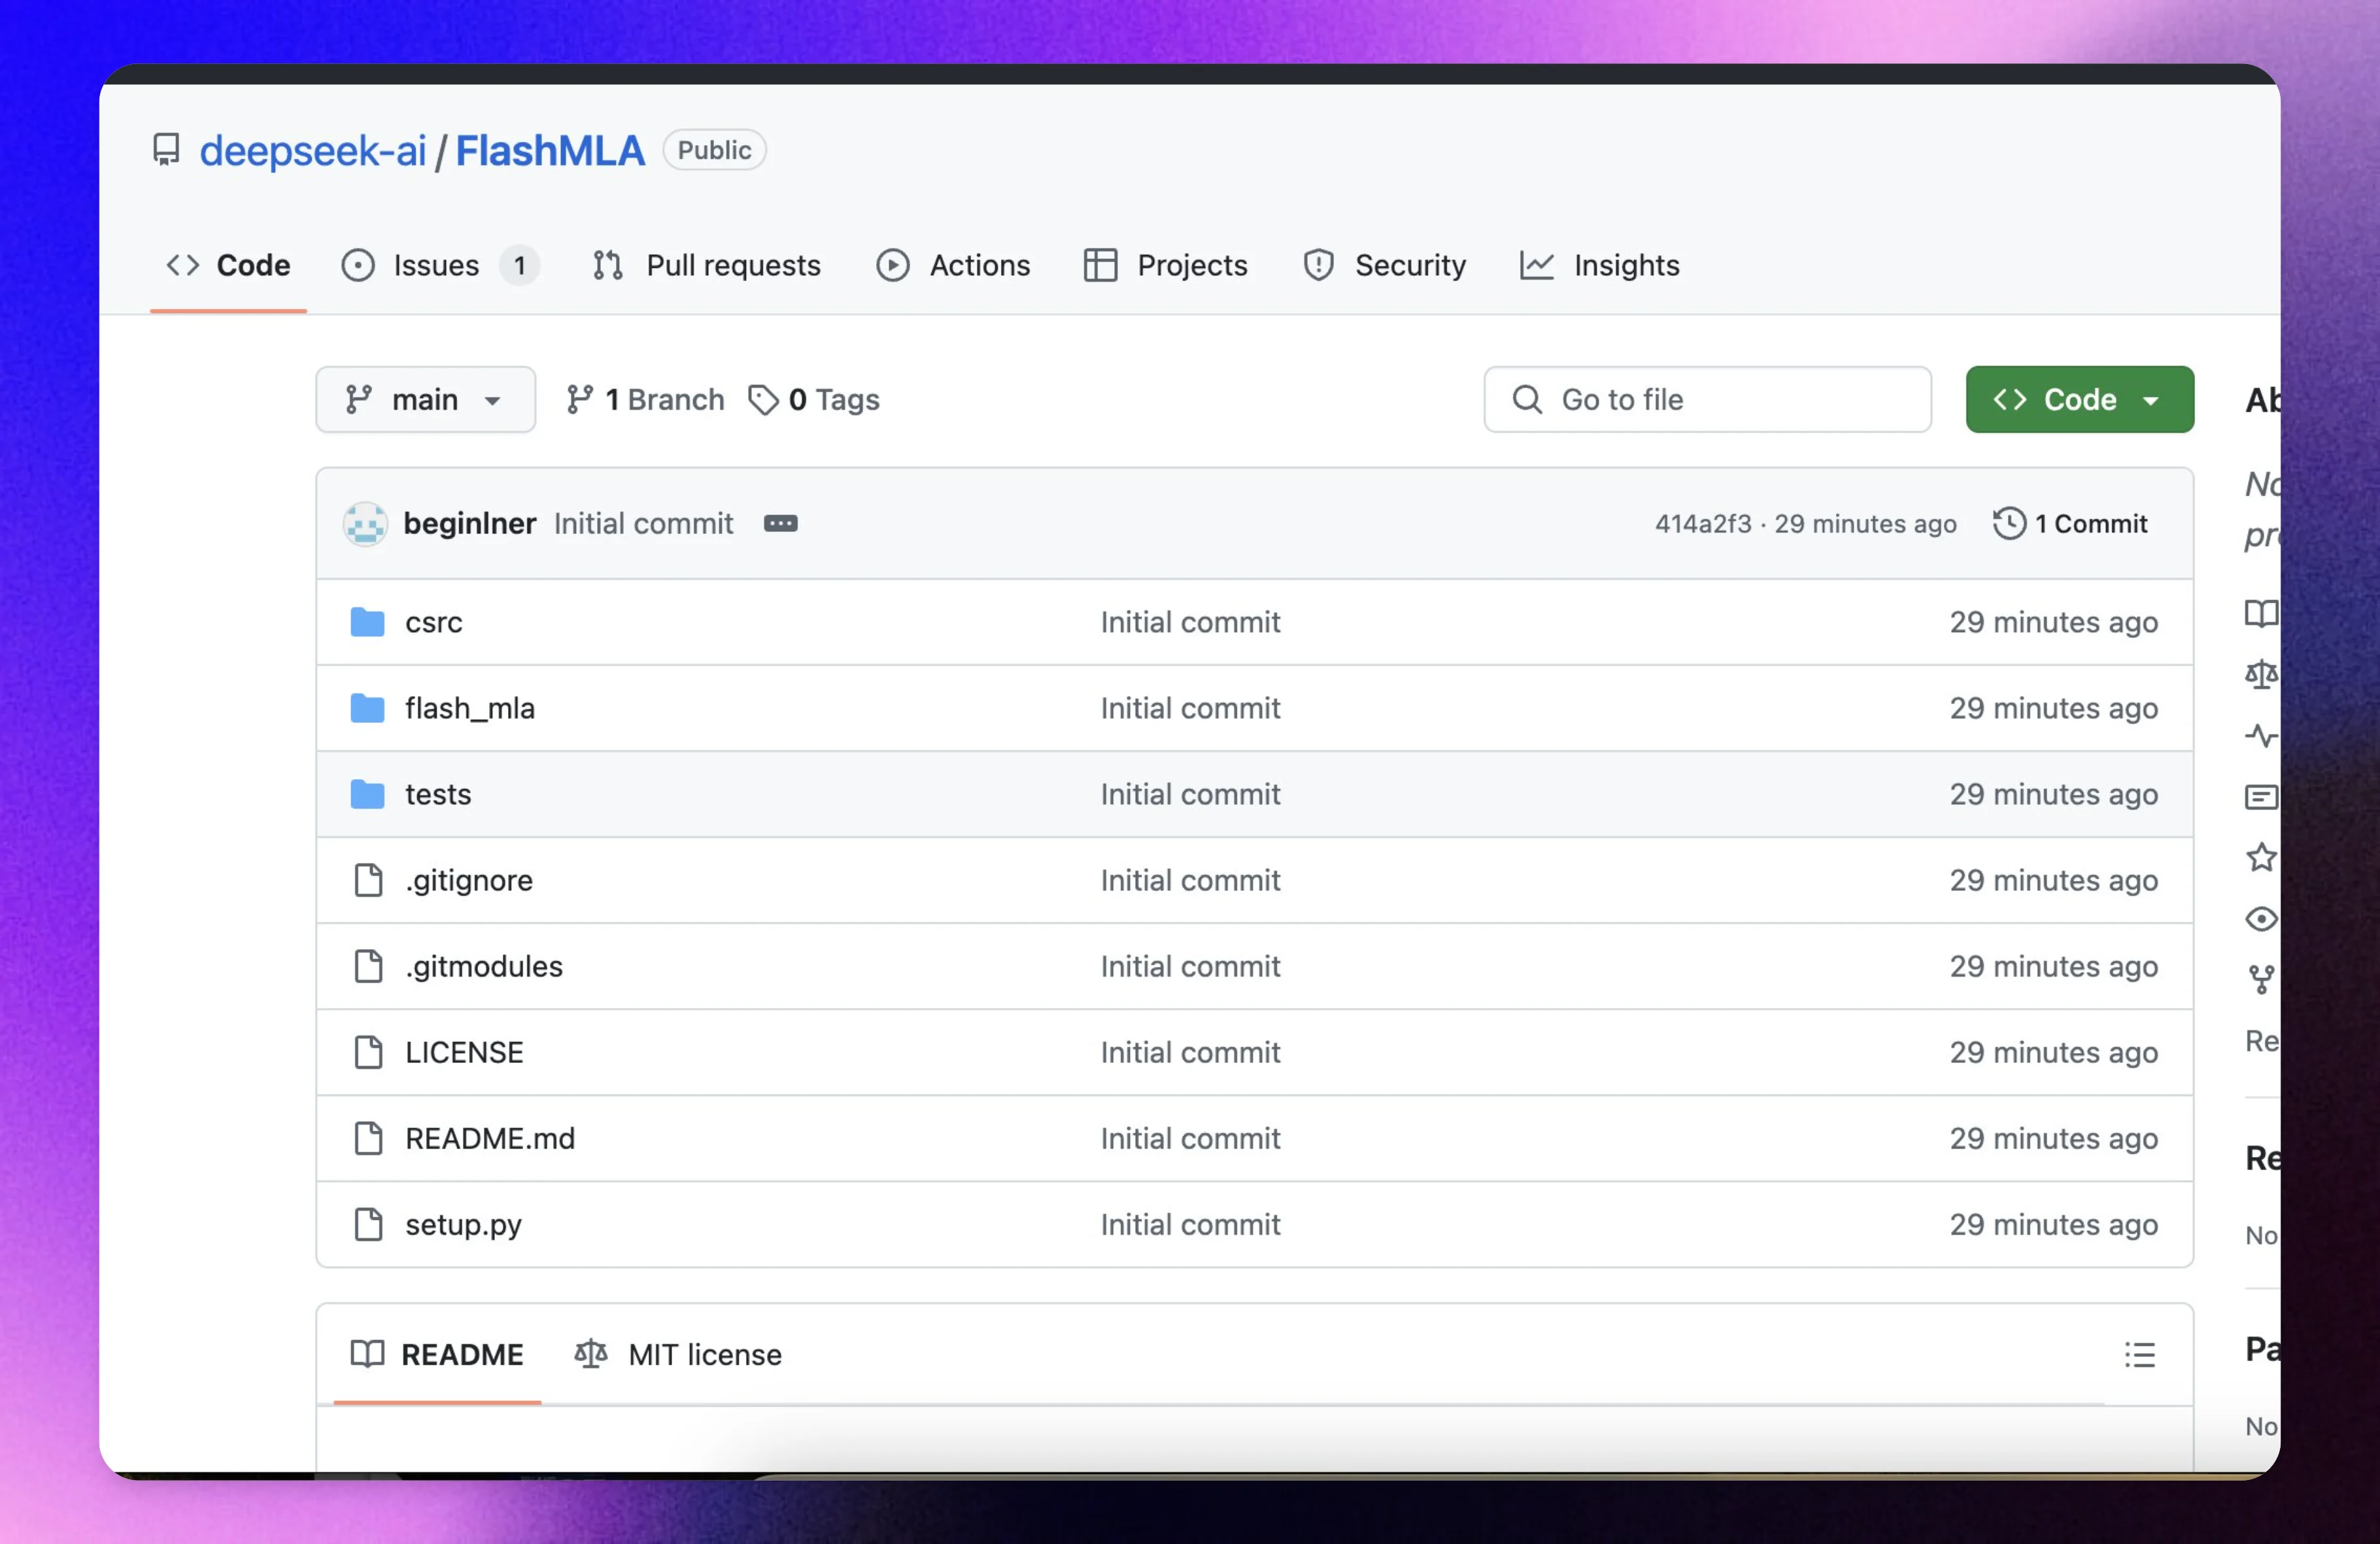
FlashMLA на GitHub:https://github.com/deepseek-ai/FlashMLA









