
 Помощник сценариста▸
 AI Приложения
 AI Новости
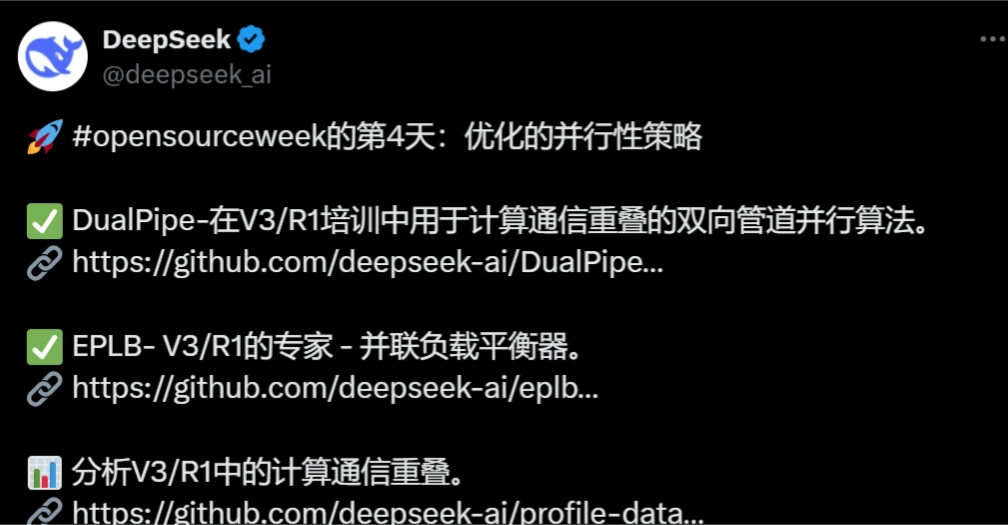
DeepSeek Open Source Week, день 4: DualPipe
小编 ·

DeepSeek Open Source Week, день 4: DualPipe
Что такое DualPipe?
DualPipe — это инновационный двунаправленный алгоритм параллелизма конвейера, впервые представленный в техническом отчёте DeepSeek-V3. Благодаря полному перекрытию фаз прямого и обратного вычислений с фазами коммуникации он значительно повышает эффективность и коэффициент использования ресурсов при обучении крупномасштабных моделей, одновременно эффективно сокращая явление «пузырей» в конвейере.
Обзор DualPipe
DualPipe — это инновационный двунаправленный алгоритм параллелизма конвейера, впервые представленный в техническом отчёте DeepSeek-V3. Благодаря полному перекрытию фаз прямого и обратного вычислений с фазами коммуникации он значительно повышает эффективность и коэффициент использования ресурсов при обучении крупномасштабных моделей, одновременно эффективно сокращая явление «пузырей» в конвейере.
Ключевые инновации DualPipe
Перекрытие вычислений и коммуникации
Суть DualPipe заключается в двунаправленном планировании микропакетов данных, что обеспечивает полное перекрытие прямых и обратных вычислений с коммуникацией. Такая конструкция исключает простои вычислительных ресурсов в ожидании завершения коммуникации, существенно повышая коэффициент использования GPU.
Сокращение пузырей в конвейере
Традиционные методы параллелизма конвейера (такие как 1F1B и ZB1P) при работе с крупномасштабными моделями часто создают узкие места в эффективности из-за разделения фаз вычислений и коммуникации. DualPipe оптимизирует расположение функциональных модулей и точно регулирует пропорции распределения ресурсов GPU, эффективно сокращая явление пузырей в конвейере.
Оптимизация использования памяти
Несмотря на то что DualPipe требует поддержания двух копий параметров модели, благодаря использованию крупномасштабного накопления градиентов (EP) в процессе обучения эта избыточность не приводит к значительному увеличению расхода памяти. Кроме того, пиковый объём активной памяти увеличивается лишь в 2 раза, что эффективнее по сравнению с традиционными методами.
Детали реализации DualPipe
Разделение функциональных модулей
Каждый вычислительный блок разделён на четыре функциональных модуля: механизм внимания, распределение данных по всем узлам, обработка MLP и объединение данных со всех узлов. В блоках обратного вычисления модули внимания и MLP дополнительно разделяются на две части: вычисление градиентов входных данных и вычисление градиентов весов.
Механизм планирования
DualPipe использует инновационную стратегию двунаправленного планирования конвейера, при которой ввод микропакетов данных осуществляется одновременно с обоих концов конвейера. Такая конструкция обеспечивает возможность тонкого распределения экспертов между узлами даже при дальнейшем масштабировании модели — при условии поддержания надлежащего соотношения вычислений и коммуникации — и снижает накладные расходы на коммуникацию между всеми узлами практически до нуля.
Сравнение производительности
По сравнению с традиционными методами 1F1B и ZB1P, DualPipe демонстрирует превосходные результаты в сокращении блокировок конвейера и снижении использования памяти. Время «пузырей» значительно уменьшается, тогда как пиковый объём активной памяти увеличивается лишь незначительно. Такой эффективный механизм планирования обеспечивает DualPipe значительное преимущество в производительности в сценариях крупномасштабного параллелизма.
Перспективы применения DualPipe
Появление DualPipe предоставляет эффективный и практически применимый инструмент для параллельного обучения крупномасштабных моделей. Как в академических исследованиях, так и в промышленных приложениях эта технология, как ожидается, будет способствовать дальнейшему развитию области обучения ai.
Адрес DualPipe на GitHub:https://github.com/deepseek-ai/DualPipe
Обзор проектов первых трёх дней открытого кода
FlashMLA: высокоэффективное ядро декодирования для GPU NVIDIA Hopper, оптимизирующее производительность многоголового латентного внимания (MLA) и значительно повышающее скорость отклика AI-инструментов при создании контента.
DeepeEP: первая открытая коммуникационная библиотека для обучения и инференса моделей со смесью экспертов (MoE), оптимизирующая эффективность коммуникации при крупномасштабном распределённом обучении и снижающая задержки.
DeepGEMM: вычислительная библиотека FP8, поддерживающая плотные модели и модели MoE, разработанная специально для GPU архитектуры NVIDIA Hopper, значительно повышающая вычислительную эффективность и коэффициент использования оборудования.









