
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
DeepSeek 오픈소스 주간 6일차: DeepSeek-V3/R1 추론 시스템, 비용 이익률 545%
小编 ·

DeepSeek 오픈소스 주간 6일차: DeepSeek-V3/R1 추론 시스템, 비용 이익률 545%
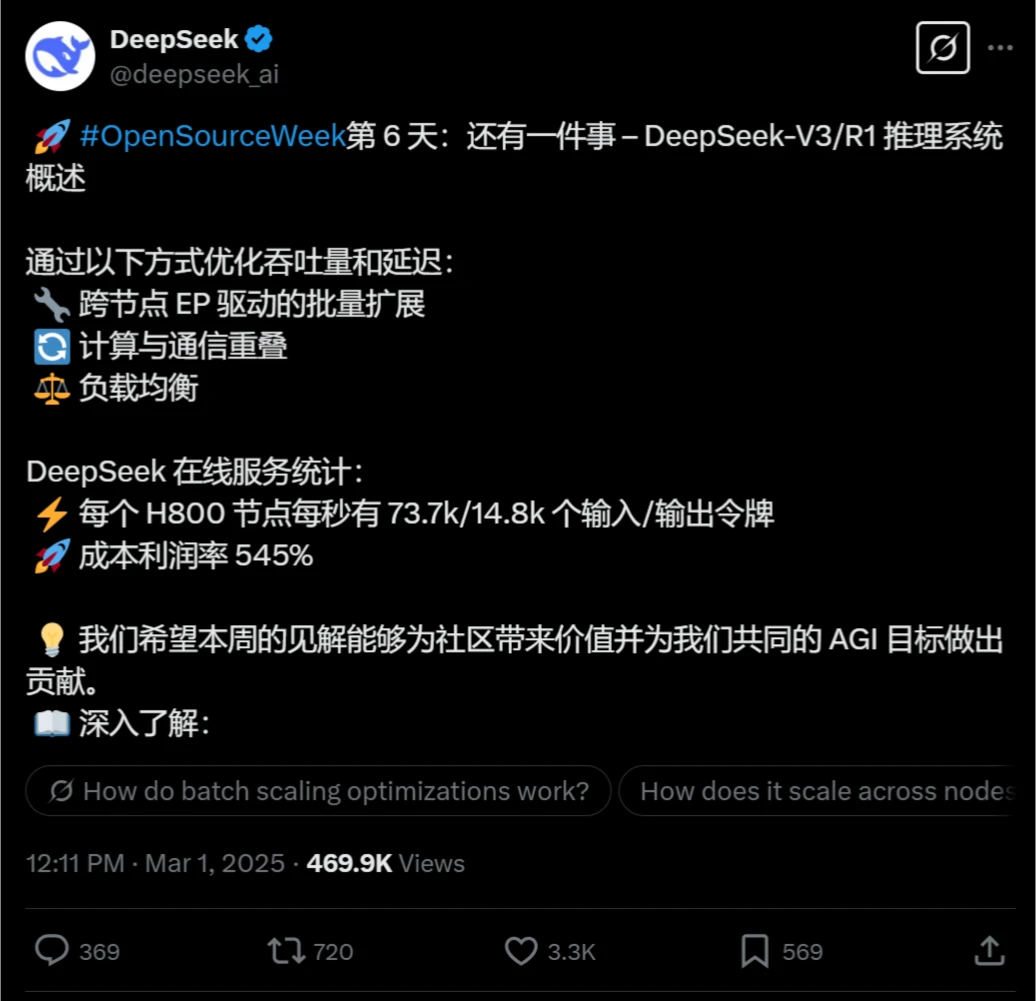
5일간의 오픈소스 주간이라고 해놓고, 의외로 토요일에도 깜짝 이벤트가 등장해 DeepSeek-V3/R1 추론 시스템을 출시했습니다.
DeepSeek-V3/R1 추론 시스템이란 무엇인가요?
DeepSeek-V3/R1 추론 시스템은 DeepSeek가 최신 출시한 고성능 추론 시스템으로, 처리량과 지연 시간을 개선하여 추론 효율을 높이는 것을 목표로 합니다. 이 시스템은 대규모 크로스 노드 전문가 병렬(Expert Parallelism, EP) 기술을 채택하여 GPU 행렬 계산의 효율을 크게 높이고, 전문가 모듈을 여러 GPU에 분산하여 지연 시간을 낮추었습니다.
주요 특징
높은 처리량과 낮은 지연 시간 최적화:
크로스 노드 전문가 병렬(Expert Parallelism, EP) 기술을 채택하여 배치 규모를 크게 확대하고, GPU 행렬 계산 효율을 향상시켰습니다.
프리필-디코딩 분리 아키텍처를 통해 프리필과 디코딩 단계에서 서로 다른 수준의 병렬 전략을 적용합니다.
지능형 부하 분산:
프리필 및 디코딩 단계에서 각각 핵심 어텐션 계산과 배포 전송 부하의 균형을 구현합니다.
혼합 전문가 모델(MoE)에서 각 GPU의 전문가 계산 작업량을 균형 있게 분배합니다.
계산-통신 오버랩 처리:
dual-batch 오버랩 전략을 채택하여同一 배치 요청을 두 개의 마이크로배치로 분할하여, 통신 비용을 숨기고 전체 처리량을 높입니다.
디코딩 단계에서는 5단계 파이프라인 기술을 채택하여 계산과 통신의 원활한 오버랩을 실현합니다.
대규모 크로스 노드 전문가 병렬(EP):
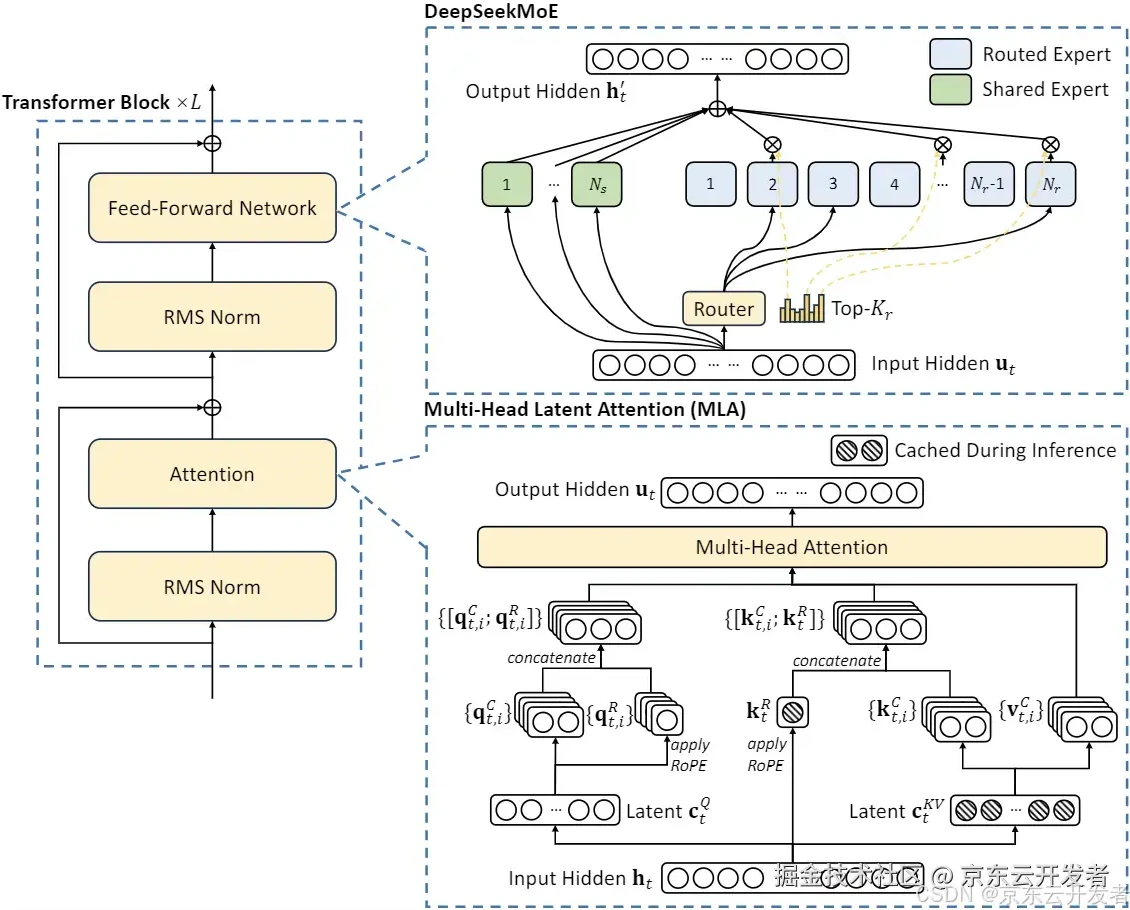
각 계층의 256개 전문가 중 8개만 활성화되며, 모델의 높은 희소성 특성으로 인해 매우 큰 전체 배치 규모가 요구됩니다.
프리필 단계에서는 라우팅 전문가 EP32와 MLA/공유 전문가 DP32를 사용하고, 디코딩 단계에서는 라우팅 전문가 EP144와 MLA/공유 전문가 DP144를 사용합니다.
효율적인 자원 활용:
낮 시간대의 피크 시간에는 모든 노드에 추론 서비스를 배포하고, 야간 저부하 시간에는 추론 노드를 줄이고 자원을 연구 및 훈련에 할당합니다.
핵심 기술
크로스 노드 전문가 병렬(EP): DeepSeek-V3/R1 모델은 대규모 전문가 네트워크를 활성화할 수 있지만, 각 계층에서는 256개 전문가 중 8개만 활성화되어 고도로 희소한 계산 구조를 생성합니다.
부하 분산: 시스템 설계는 각 노드 간의 계산 부하가 균등하도록 보장하여 모든 자원을 효과적으로 활용할 수 있게 합니다.
비용과 수익률: 모델의 최신 평가에 따르면, GPU 임대 비용을 시간당 2달러로 가정할 때 총 비용은 하루 87,072달러이며, 이론상 하루 총 수입은 562,027달러에 달해 비용 대비 수익률은 무려 545%에 달합니다.
활용 분야
온라인 추론 서비스:
모든 DeepSeek-V3/R1 추론 서비스는 H800 GPU에서 실행되며, 정밀도는 훈련과 일치합니다.
높은 처리량과 낮은 지연 시간을 가진 온라인 추론 서비스를 제공하여, 웹페이지, APP 및 API의 모든 사용자 요청에 적합합니다.
상업화 및 비상업화 서비스:
일부 서비스는 상업화되었으며, 웹페이지 및 APP 접근은 여전히 무료입니다.
비피크 시간에는 자동으로 야간 할인을 적용하여 자원 활용과 비용 효율을 최적화합니다.
통계 데이터
지난 24시간 동안 V3 및 R1 추론 서비스의 합계 피크 노드 점유는 278개에 달했으며, 평균 점유는 226.75개 노드였습니다(각 노드에는 8개의 H800 GPU가 포함됨).
각 H800 노드는 프리필 단계에서 평균 약 7.37만 token/초의 입력 처리량을 제공하거나, 디코딩 단계에서 약 1.48만 token/초의 출력 처리량을 제공합니다.
모든 token이 DeepSeek-R1의 가격 정책에 따라 청구된다면, 하루 총 수입은 562,027달러에 달하며 수익률은 545%입니다.
앞선 5일간의 오픈소스 프로젝트回顾
첫째 날: FlashMLA, NVIDIA Hopper GPU를 위한 고효율 디코딩 커널로, 다중 헤드 잠재 어텐션(MLA) 성능을 최적화하여 ai도구의 콘텐츠 제작 응답 속도를 크게 향상시켰습니다.
둘째 날: DeepeEP, 혼합 전문가 모델(MoE) 훈련 및 추론을 위한 최초의 오픈소스 통신 라이브러리로, 대규모 분산 훈련의 통신 효율을 최적화하고 지연 시간을 줄였습니다.
셋째 날: DeepGEMM,稠密 및 MoE 모델을 지원하는 FP8 계산 라이브러리로, NVIDIA Hopper 아키텍처 GPU 전용으로 설계되어 계산 효율과 하드웨어 활용률을 크게 향상시켰습니다.
넷째 날: DualPipe, V3/R1 모델 훈련에서 계산과 통신 오버랩을 최적화하는 양방향 파이프라인 병렬 알고리즘입니다. EPLB는 대규모 AI 모델에서 전문가 병렬 작업의 부하 불균형 문제를 해결하기 위한 전문가 병렬 부하 분산기입니다.
다섯째 날: 3FS, 고성능 분산 파일 시스템입니다.









