
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
DeepSeek 오픈소스 위크 2일차: DeepEP 공개
小编 ·

DeepSeek 오픈소스 위크 2일차: DeepEP 공개
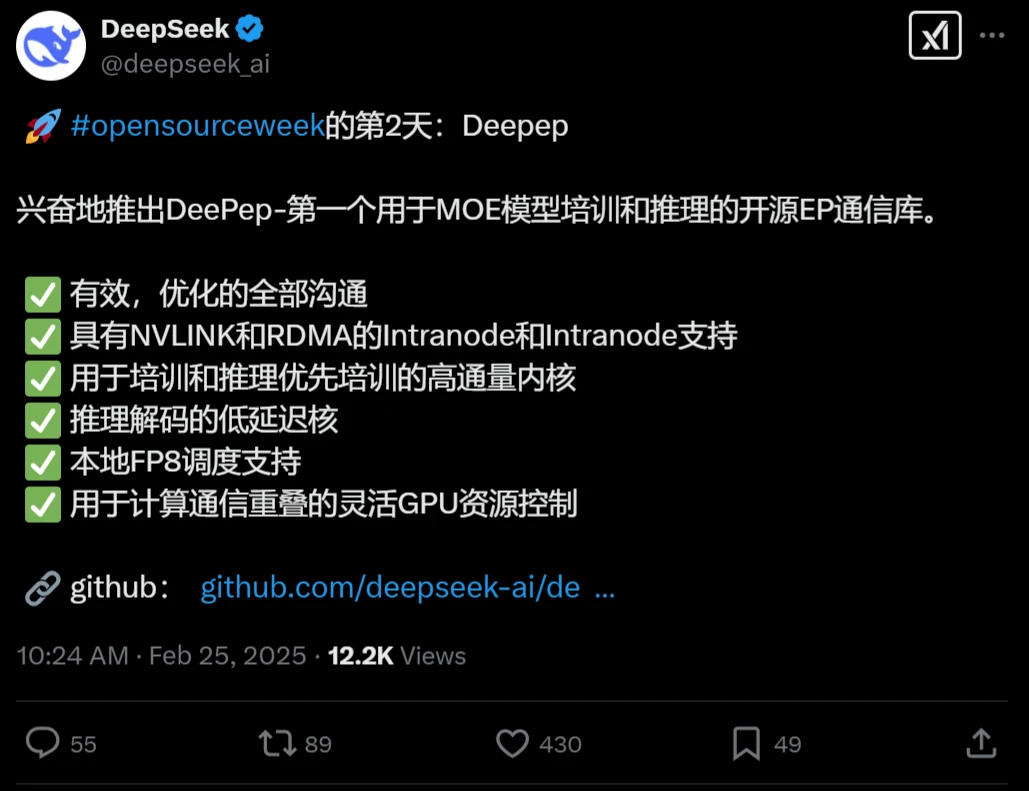
어제는 DeepSeek ai 오픈소스 주의 첫째 날이었으며, 오픈소스로 공개된 프로젝트는 FlashMLA였습니다. 공개된 지 한 시간이 채 되지 않아 GitHub에서 Star 300개 이상을 기록했고, 단 1시간 만에 조회수 10만을 돌파하여 엄청난 화제를 모았습니다. 오늘은 DeepSeek 오픈소스 주의 둘째 날로, DeepSeek가 두 번째 프로젝트인 Deepep를 오픈소스로 공개했습니다.
Deepep이란 무엇인가요?
Deepep는 MOE 모델 학습 및 추론을 위한 오픈소스 EP 통신 라이브러리입니다. 최첨단 혼합 전문가(Mixture-of-Experts) 아키텍처를 기반으로 하며, 대규모 데이터셋을 충분히 활용하여 사전 학습 및 미세 조정의 효율성을 높입니다. DeepEP의 설계 목표는 계산 부담과 메모리 사용량을 줄여, 사용자가 일반적인 하드웨어에서도 대규모 모델을 효율적으로 실행할 수 있도록 하는 것입니다.
Deepep의 기능 및 특징
MoE 아키텍처 최적화:
DeepEP는 Mixture-of-Experts (MoE) 및 Expert Parallel (EP) 전용으로 설계되어, 학습 및 추론 작업에 고성능의 all-to-all GPU 커널을 제공합니다.
FP8 및 BF16을 포함한 저정밀 연산을 지원하여 계산 효율을 높이고 비디오 메모리를 절약합니다.
고성능 통신:
NVLink 및 RDMA 네트워크를 지원하는 고처리량 및 저지연 통신 커널을 제공합니다. H800 GPU에서의 테스트 결과, 최대 대역폭은 NVLink에서 153 GB/s, RDMA에서 46 GB/s에 달합니다.
NVLink에서 RDMA로의 비대칭 대역폭 포워딩 시나리오에 최적화되어 높은 처리량 성능을 보장합니다.
저지연 통신:
순수 RDMA 기반의 저지연 커널을 제공하며, 특히 추론 디코딩 단계에 적합하여 지연 시간을 163마이크로초까지 낮출 수 있습니다.
Hook 기반의 통신-계산 오버랩 방식을 도입하여 GPU SM 자원을 점유하지 않으며, 계산 효율을 극대화합니다.
하드웨어 최적화:
공개되지 않은 PTX 명령을 활용하여 Hopper 아키텍처의 성능을 향상시킵니다.
InfiniBand 네트워크를 지원하며, 이론적으로 RoCE와도 호환되어 유연한 네트워크 구성 옵션을 제공합니다.
Deepep의 활용 시나리오
대규모 모델 학습:
Mixture-of-Experts (MoE) 모델 학습에 적합하며, 효율적인 병렬 통신 지원을 제공하여 학습 효율을 크게 향상시킵니다.
추론 작업:
지연에 민감한 추론 디코딩 시나리오에 특히 적합하며, 효율성을 크게 높이고 지연 시간을 줄여 추론 처리량을 향상시킵니다.
고성능 컴퓨팅 요구 사항:
현대적인 고성능 컴퓨팅 요구 사항에 완벽하게 부합하며, Hopper GPU 아키텍처를 포함한 다양한 하드웨어 플랫폼을 지원하고, 향후 더 많은 장치로 확장될 가능성이 있습니다.
Deepep의 사용 및 통합
사용 편의성:
Hopper GPU 아키텍처를 지원하며, Python 3.8+, CUDA 12.3+ 및 PyTorch 2.1+ 환경이 필요합니다.
설치 시 팀이 수정한 버전의 NVSHMEM이 함께 필요하며, 자세한 설치 가이드가 제공됩니다.
통합 방식:
오픈소스이며 통합이 용이하여, 몇 줄의 명령만으로 빌드 및 테스트를 실행할 수 있습니다.
설치 후 deep_ep 모듈을 import하여 바로 사용할 수 있으며, 예제 코드와 테스트 스크립트가 제공됩니다.
DeepEP은 GitHub에 오픈소스로 공개되어 있으며, 주소는 https://github.com/deepseek-ai/DeepEP 입니다.
1. DeepSeek 오픈소스 주의 첫째 날 오픈소스 프로젝트: DeepSeek FlashMLA









