
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
DeepSeek 오픈소스 위크 5일차: 고성능 분산 파일 시스템 3FS
小编 ·

DeepSeek 오픈소스 위크 5일차: 고성능 분산 파일 시스템 3FS
여기서GPT4.5가 방금 출시되었고, 동시에 DeepSeek 오픈소스 주간이 다섯째 날 오픈소스 프로젝트에 진입했습니다. 마지막 날의 오픈소스 프로젝트는 3FS(Fire-Flyer File System)입니다.
3FS(Fire-Flyer File System)란 무엇인가요?
3FS(Fire-Flyer File System)는 DeepSeek이 자체 개발한 고성능 분산 파일 시스템으로, ai 훈련 및 추론 워크로드의 과제를 해결하기 위해 설계되었습니다.
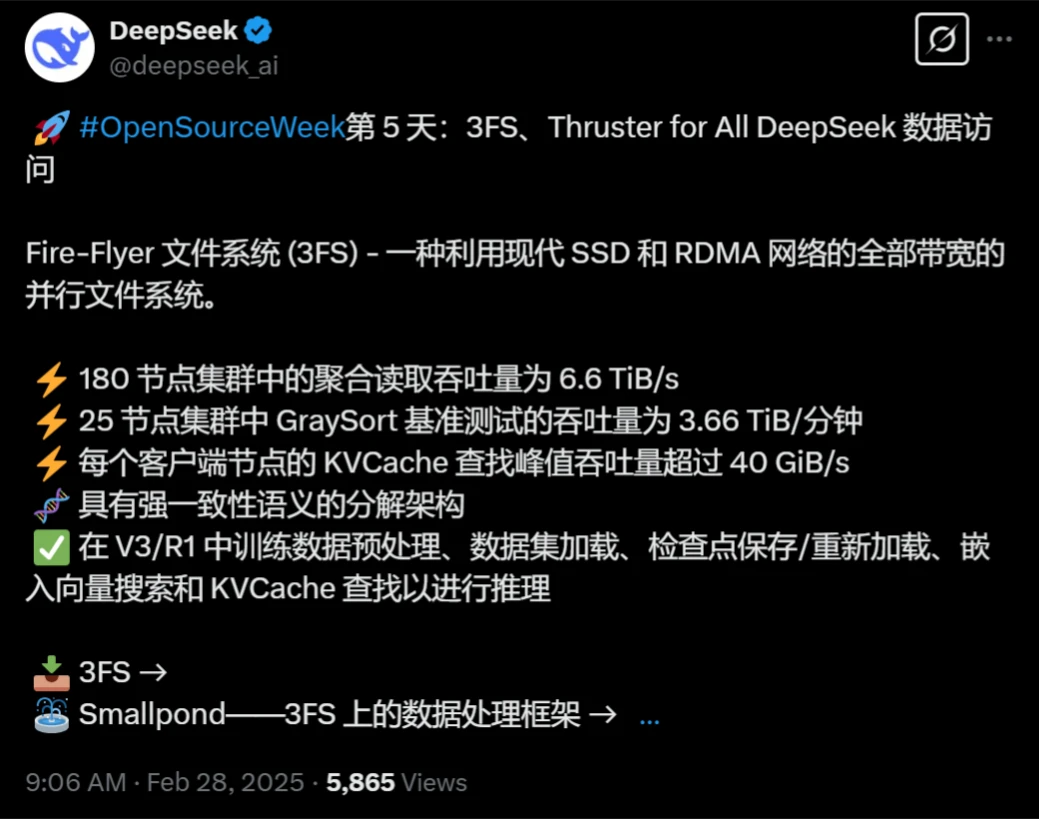
3FS의 특징
고성능:
최신 SSD와 RDMA 네트워크를 활용하여 높은 처리량과 낮은 지연 시간의 데이터 액세스를 제공합니다.
수천 개의 SSD 처리량과 수백 개의 스토리지 노드 네트워크 대역폭을 결합하여 애플리케이션이 지역에 구애받지 않는 방식으로 스토리지 리소스에 액세스할 수 있게 합니다.
강력한 일관성:
체인 복제와 할당 쿼리(CRAQ)를 구현하여 강력한 일관성을 보장하며, 애플리케이션 코드를 더 간결하고 추론하기 쉽게 만듭니다.
파일 인터페이스:
무상태 메타데이터 서비스를 채택하고,背后에 트랜잭션형 키-값 저장소(예: FoundationDB)를 지원합니다.
익숙한 파일 인터페이스로 새로운 스토리지 API를 배울 필요가 없습니다.
다양한 워크로드 지원:
데이터 준비: 데이터 분석 파이프라인의 출력을 계층적 디렉터리 구조로 구성하여 대량의 중간 출력을 효과적으로 관리합니다.
데이터 로더: 컴퓨팅 노드 간 훈련 샘플의 무작위 액세스를 지원하여 프리페치나 데이터 셔플의 필요성을 제거합니다.
체크포인트: 대규모 훈련을 위한 고처리량 병렬 체크포인트를 지원합니다.
추론 KV 캐시: DRAM 캐시를 대체하는 비용 효율적인 대안을 제공하여 더 높은 처리량과 용량을 크게 향상시킵니다.
스토리지-컴퓨트 분리:
데이터 스토리지 서비스가 컴퓨팅 노드와 분리되어 모델 훈련에 필요한 샘플 데이터를专门 저장합니다.
각 스토리지 서비스 노드에는 15TB짜리 SSD 16개와 고속 네트워크 카드 2개가 장착되어 강력한 읽기 성능과 네트워크 대역폭을 갖추고 있으며, 읽기/쓰기 대역폭은 7.0TB/초입니다.
자체 개발 통신 도구:
hfreduce와 같이 다중 카드 병렬 통신을 최적화하여 NVIDIA의 NCCL을 대체하고 PCIe 트래픽과 컴퓨팅 오버헤드를 줄입니다.
전용 데이터 형식 FFRecord:
여러 개의 작은 파일을 병합하여 훈련 시 대량의 작은 파일을 여는 데 따른 오버헤드를 줄입니다.
샘플 파일의 오프셋을 통해 무작위 배치 읽기 성능을 향상시킵니다.
3FS의 응용
AI 훈련 및 추론:
3FS는 AI 훈련 및 추론 워크로드를 위해 설계되어 이러한 작업의 효율성을 크게 향상시킬 수 있습니다.
고성능과 강력한 일관성을 통해 3FS는 대규모 모델 훈련과 고처리량 추론을 지원합니다.
데이터 준비 및 로딩:
3FS의 데이터 준비 및 로더 기능을 통해 대량의 데이터를 보다 효율적으로 처리할 수 있으며, 프리페치와 데이터 셔플의 필요성을 줄여줍니다.
체크포인트 및 추론 캐시:
3FS는 고처리량의 병렬 체크포인트를 지원하여 훈련 과정의 안정성과 내결함성을 보장합니다.
추론 KV 캐시는 비용 효율적인 대안을 제공하여 추론 처리량과 용량을 향상시킵니다.
3FS 사용 방법
설치 및 구성:
3FS는 GitHub의 오픈소스 프로젝트를 통해 설치 및 구성할 수 있습니다.
데이터 형식 변환:
FFRecord 형식을 사용하여 데이터를 저장 및 로드하려면 샘플 데이터를 FFRecord 형식으로 변환해야 합니다.
사용자가 데이터 형식 변환을 쉽게 할 수 있도록 FFRecord 변환 도구를 제공합니다.
PyTorch와의 통합:
3FS는 PyTorch의 Dataset 및 Dataloader 인터페이스에 적응하여 데이터를 매우 편리하게 로드하고 훈련을 시작할 수 있습니다.
GitHub 프로젝트 주소:https://github.com/deepseek-ai/3FS
전 4일간의 오픈소스 프로젝트回顾
첫째 날: FlashMLA, NVIDIA Hopper GPU용 고효율 디코딩 커널로, 다중 헤드 잠재 어텐션(MLA) 성능을 최적화하여 콘텐츠 제작에서 AI 도구의 응답 속도를 크게 향상시켰습니다.
둘째 날: DeepeEP, 혼합 전문가 모델(MoE) 훈련 및 추론을 위한 최초의 오픈소스 통신 라이브러리로, 대규모 분산 훈련의 통신 효율을 최적화하고 지연 시간을 줄였습니다.
셋째 날: DeepGEMM, Dense 및 MoE 모델을 지원하는 FP8 계산 라이브러리로, NVIDIA Hopper 아키텍처 GPU 전용으로 설계되어 컴퓨팅 효율성과 하드웨어 활용률을 크게 향상시켰습니다.
넷째 날: DualPipe, V3/R1 모델 훈련에서 컴퓨팅과 통신의 오버랩을 최적화하기 위한 양방향 파이프라인 병렬 알고리즘입니다. EPLB는 대규모 AI 모델에서 전문가 병렬 작업의 부하 불균형 문제를 해결하기 위한 전문가 병렬 부하 분산 장치입니다.









