
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
FlashMLA: DeepSeek가 공개한 가변 길이 시퀀스 처리에 최적화된 효율적인 MLA 디코딩 커널
小编 ·

FlashMLA: DeepSeek가 공개한 가변 길이 시퀀스 처리에 최적화된 효율적인 MLA 디코딩 커널
FlashMLA란 무엇인가?
FlashMLA는 DeepSeek이 2025년 2월 24일에 출시한 MLA(Multi-Head Latent Attention) 디코딩 커널로, NVIDIA Hopper 아키텍처 GPU(예: H800)에 최적화되어 있으며 가변 길이 시퀀스 처리 서비스에 특별히 최적화되었습니다.
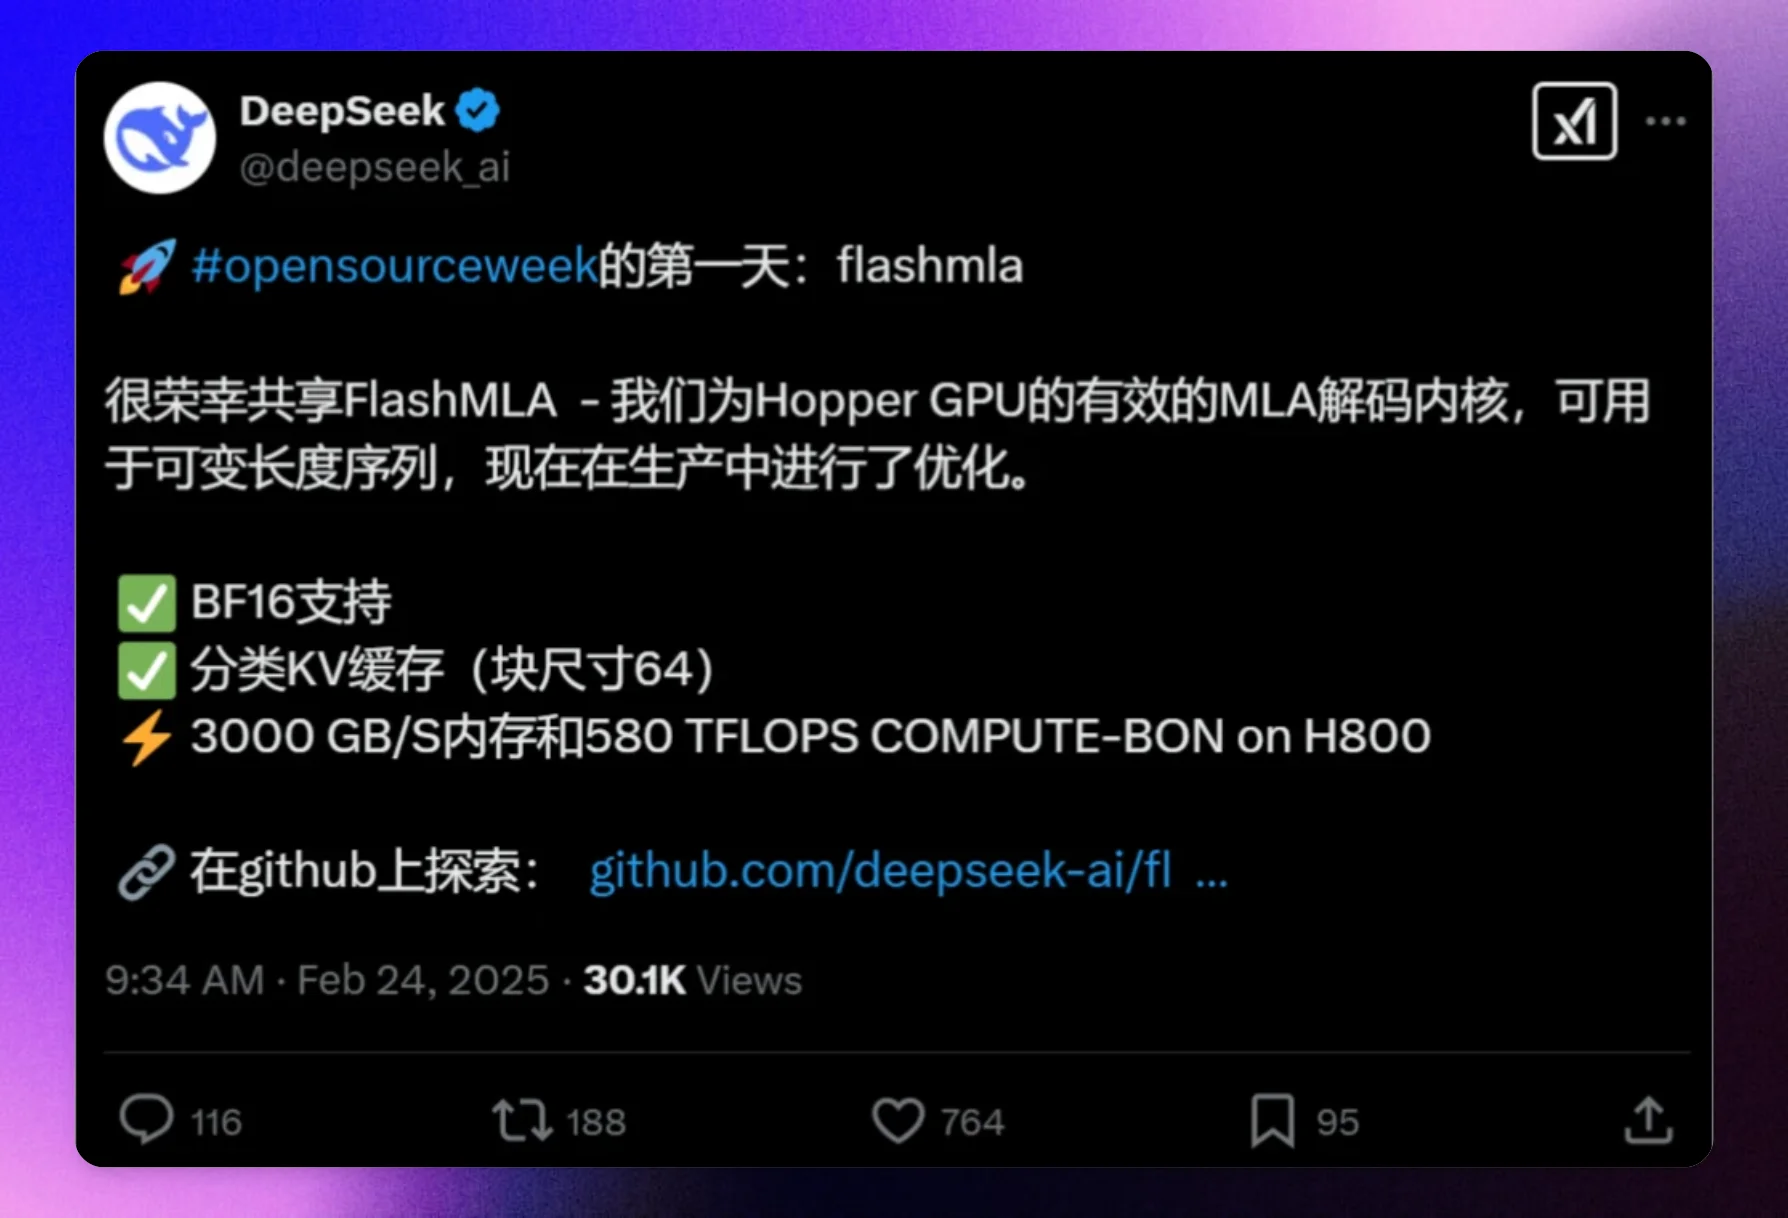
FlashMLA의 주요 특성:
BF16 지원: FlashMLA는 BF16(Bfloat16) 데이터 타입을 지원하여 계산과 메모리 사용 측면에서 더 효율적입니다.
페이지화된 KV 캐시: 키-값(KV) 캐시를 페이지 메커니즘으로 관리하며 블록 크기는 64으로, 대규모 시퀀스를 효율적으로 처리할 수 있습니다.
고성능: FlashMLA의 메모리 대역폭은 3000 GB/s에 달하며(메모리 병목 시나리오에서), 컴퓨팅 성능은 580 TFLOPS에 달합니다(컴퓨팅 병목 시나리오에서, BF16 데이터 타입 기반).
FlashMLA의 기술적 배경:
FlashMLA는 대규모 언어 모델의 추론 과정에서 발생하는 컴퓨팅 및 메모리 병목 문제를 해결하기 위해 등장했습니다. 전통적인 멀티 헤드 어텐션(MHA) 메커니즘은 긴 시퀀스를 처리할 때 키-값 쌍(KV) 캐시를 저장하기 위해 대량의 메모리를 필요로 하며, 이는 제한된 하드웨어 리소스에서의 모델 배포를 제한합니다. MLA는 잠재(latent) 어텐션 메커니즘을 도입하여 모델 성능을 유지하면서 KV 캐시의 크기를 줄입니다.
FlashMLA의 적용 시나리오:
FlashMLA는 특히 대규모 언어 모델(LLM) 추론과 같이 효율적인 디코딩이 필요한 자연어 처리(NLP) 작업에 적합합니다. 가변 길이 시퀀스에 최적화되어 있으며 실제 프로덕션 환경에서 검증되어 고성능 컴퓨팅 요구 사항에 특히 적합합니다.
FlashMLA의 기술 구현
저랭크 압축: MLA는 저랭크 행렬 분해를 통해 KV 캐시를 효과적으로 압축하여 메모리 사용량을 줄입니다.
KV 캐시 최적화: KV 캐시 메커니즘을 최적화하여 하드웨어 리소스 요구 사항을 크게 낮추어 추론 비용을 절감합니다.
병렬 디코딩: 병렬 디코딩 메커니즘을 도입하여 여러 토큰을 동시에 처리할 수 있게 하여 추론 속도를 크게 향상시킵니다.
FlashMLA의 성능 향상
FlashMLA를 채택한 후 DeepSeek은 자연어 처리 작업에서 정확도가 약 5% 향상되었으며, 추론 속도는 20% 빨라지고 컴퓨팅 리소스 소비는 15% 감소했습니다. 이러한 개선으로 DeepSeek은 대화형 ai, 실시간 번역과 같은 실시간 상호작용 시나리오에서 더 뛰어난 성능을 보입니다.
FlashMLA 설치 및 사용
환경 요구 사항:
Hopper 아키텍처 GPU(예: NVIDIA A100)
CUDA 12.3 이상 버전
PyTorch 2.0 이상 버전
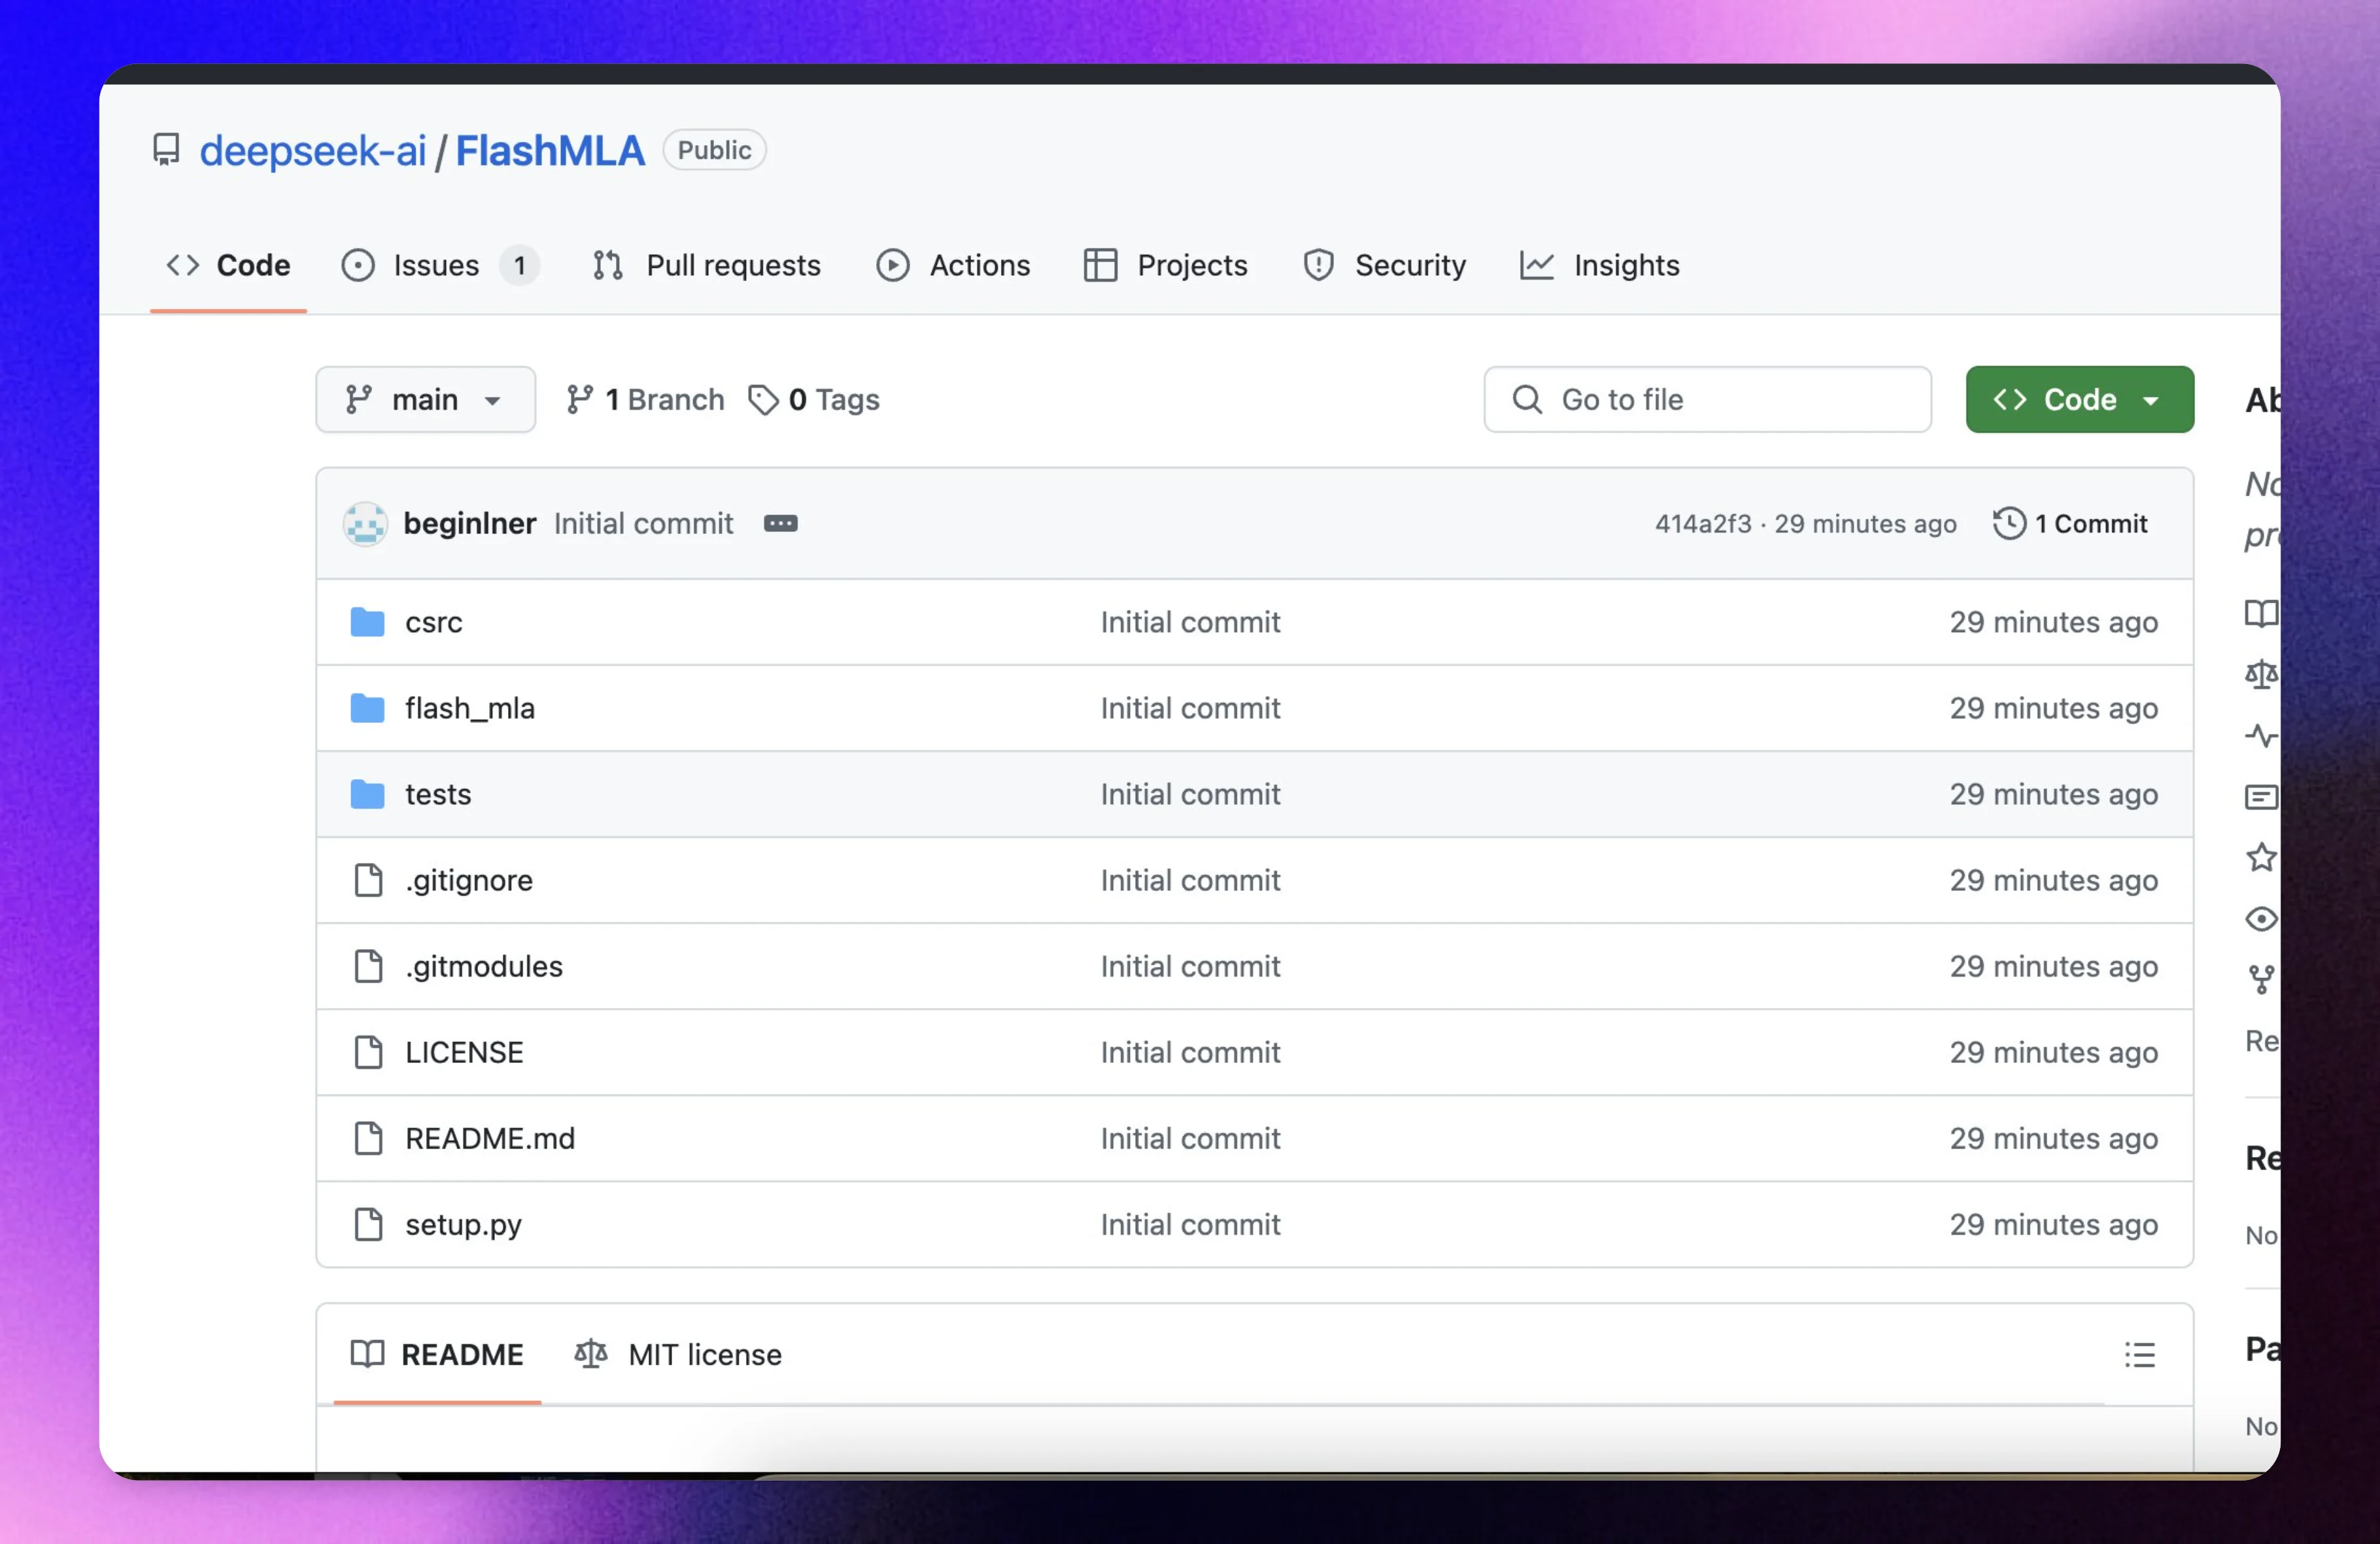
1. 먼저 FlashMLA 라이브러리를 설치해야 합니다. 다음 명령으로 설치할 수 있습니다:
git clone https://github.com/deepseek-ai/FlashMLA.git
cd FlashMLA
python setup.py install
또는 이미 저장소를 클론한 상태에서 다시 빌드하려는 경우:
python setup.py clean --all && python setup.py build_ext --inplace
2. MLA 메타데이터 가져오기
FlashMLA를 사용하기 전에 MLA의 메타데이터를 가져와야 합니다. 이는 일반적으로 입력 텐서와 기타 필요한 매개변수를 준비하는 작업을 포함합니다.
from flash_mla import get_mla_metadata, flash_mla_with_kvcache

# 이미 cache_seqlens 및 기타 관련 변수가 있다고 가정합니다
cache_seqlens = [...]  # 각 시퀀스의 길이 리스트
s_q = ...              # 쿼리 차원
h_q = ...              # 헤드 수
h_kv = ...             # 키-값 헤드 수

tile_scheduler_metadata, num_splits = get_mla_metadata(cache_seqlens, s_q * h_q // h_kv, h_kv)
3. MLA 디코딩 실행
다음으로 MLA 디코딩 작업을 수행할 수 있습니다. 쿼리 행렬 q_i, 키-값 캐시 kvcache_i, 블록 테이블 block_table 등 필요한 구성 요소가 이미 있다고 가정합니다.
dv = ...               # 출력 차원

for i in range(num_layers):  # 각 레이어를 순회
    o_i, lse_i = flash_mla_with_kvcache(
        q_i[i],                # 현재 레이어의 쿼리 행렬
        kvcache_i[i],           # 현재 레이어의 키-값 캐시
        block_table,            # 블록 테이블
        cache_seqlens,          # 캐시된 시퀀스 길이
        dv,                     # 출력 차원
        tile_scheduler_metadata,# MLA 메타데이터
        num_splits,             # 분할 수
        causal=True             # 인과적(causal) 마스크 사용 여부
    )
    # 출력 결과 o_i 및 lse_i에 대한 처리 계속
FlashMLA github:https://github.com/deepseek-ai/FlashMLA









