
 Assistant scénario▸
 Apps AI
 Actualités AI
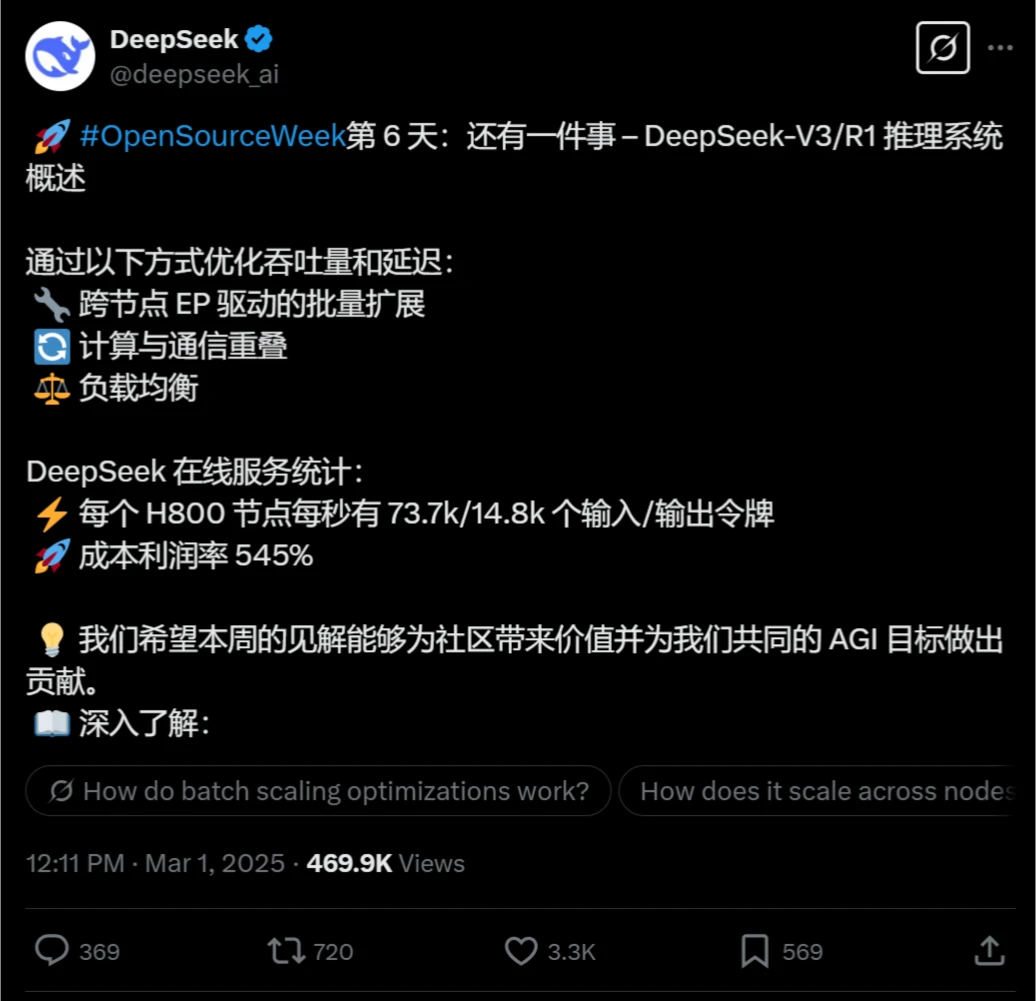
Jour 6 de la Semaine Open Source de DeepSeek : système d'inférence DeepSeek-V3/R1 avec une marge sur coût de 545 %
小编 ·

Jour 6 de la Semaine Open Source de DeepSeek : système d'inférence DeepSeek-V3/R1 avec une marge sur coût de 545 %
La semaine open source promise de 5 jours a réservé une surprise le samedi avec le lancement du système d'inférence DeepSeek-V3/R1.
Qu'est-ce que le système d'inférence DeepSeek-V3/R1 ?
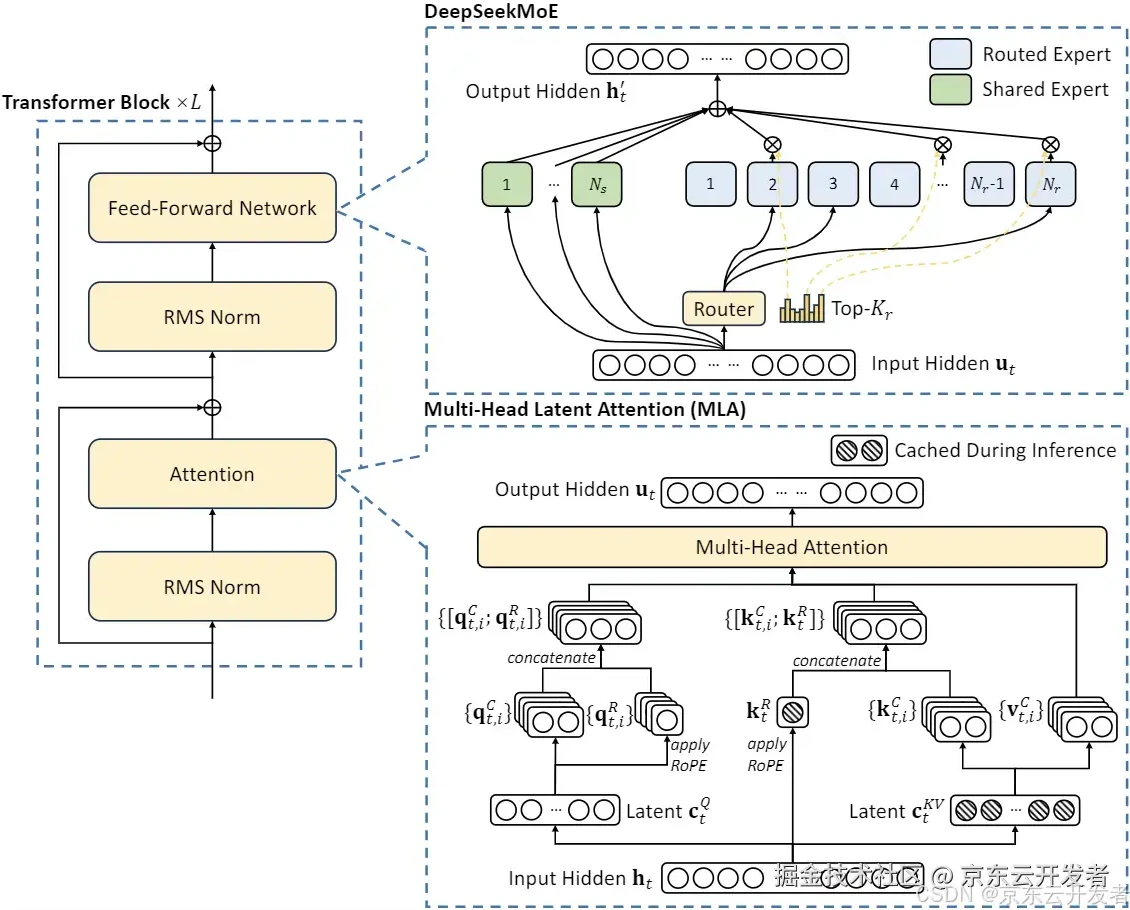
Le système d'inférence DeepSeek-V3/R1 est un système d'inférence haute performance récemment lancé par DeepSeek, conçu pour améliorer l'efficacité de l'inférence en optimisant le débit et la latence. Ce système adopte la technique de parallélisme d'experts à grande échelle entre nœuds (Expert Parallelism, EP), améliorant significativement l'efficacité des calculs matriciels sur GPU et réduisant la latence en répartissant les modules experts sur différents GPU.
Caractéristiques principales
Haut débit et faible latence :
Adopte la technique de parallélisme d'experts entre nœuds (Expert Parallelism, EP), augmentant considérablement la taille des lots et améliorant l'efficacité des calculs matriciels sur GPU.
Grâce à une architecture de découplage préfill-décodage, applique différentes stratégies de parallélisme aux étapes de préfill et de décodage.
Équilibrage intelligent de la charge :
Réalise l'équilibrage des charges du calcul d'attention central et de l'envoi distribué respectivement dans les étapes de préfill et de décodage.
Dans les modèles Mixture of Experts (MoE), équilibre la charge de calcul des experts sur chaque GPU.
Recouvrement calcul-communication :
Adopte une stratégie de recouvrement dual-batch, divisant un même lot de requêtes en deux micro-batchs pour masquer les coûts de communication et augmenter le débit global.
À l'étape de décodage, utilise une technique de pipeline en cinq étapes pour un recouvrement fluide entre calcul et communication.
Parallélisme d'experts à grande échelle entre nœuds (EP) :
Sur 256 experts par couche, seuls 8 sont activés. La haute sparsité du modèle exige une taille de lot globale très importante.
L'étape de préfill utilise EP32 pour les experts de routage et DP32 pour MLA/experts partagés ; l'étape de décodage utilise EP144 pour les experts de routage et DP144 pour MLA/experts partagés.
Utilisation efficace des ressources :
Pendant les heures de pointe en journée, tous les nœuds sont déployés pour les services d'inférence ; pendant les heures creuses nocturnes, le nombre de nœuds d'inférence est réduit et les ressources sont réaffectées à la recherche et à l'entraînement.
Technologies clés
Parallélisme d'experts entre nœuds (EP) : les modèles DeepSeek-V3/R1 peuvent activer un grand nombre de réseaux d'experts, mais seulement 8 experts sur 256 par couche sont activés, générant une structure de calcul hautement sparse.
Équilibrage de charge : la conception du système garantit une répartition uniforme de la charge de calcul entre les différents nœuds, permettant ainsi d'utiliser efficacement toutes les ressources.
Coûts et marge : selon la dernière évaluation du modèle, en supposant un coût de location GPU de 2 $ par heure, le coût total s'élève à 87 072 $ par jour, tandis que le revenu journalier théorique peut atteindre 562 027 $, avec un taux de marge sur coûts atteignant 545 %.
Applications
Service d'inférence en ligne :
Tous les services d'inférence DeepSeek-V3/R1 fonctionnent sur des GPU H800, avec une précision identique à celle de l'entraînement.
Fournit un service d'inférence en ligne à haut débit et faible latence, adapté à toutes les requêtes des utilisateurs via le web, les applications et l'API.
Services commerciaux et non commerciaux :
Certains services ont été commercialisés, tandis que l'accès via le web et les applications reste gratuit.
Des remises nocturnes sont automatiquement appliquées pendant les heures creuses, optimisant l'utilisation des ressources et la rentabilité.
Statistiques
Au cours des dernières 24 heures, l'occupation combinée en pic des nœuds pour les services d'inférence V3 et R1 a atteint 278 nœuds, avec une occupation moyenne de 226,75 nœuds (chaque nœud contient 8 GPU H800).
Chaque nœud H800 offre un débit d'entrée moyen d'environ 73 700 tokens/s à l'étape de préfill, ou un débit de sortie d'environ 14 800 tokens/s à l'étape de décodage.
Si tous les tokens étaient facturés au tarif de DeepSeek-R1, le revenu journalier total atteindrait 562 027 $, avec une marge bénéficiaire de 545 %.
Rétrospective des projets open source des cinq premiers jours
Jour 1 : FlashMLA, un noyau de décodage efficace pour les GPU NVIDIA Hopper, optimisant les performances de l'attention latente multi-tête (MLA) et améliorant significativement la vitesse de réponse des outils ia dans la création de contenu.
Jour 2 : DeepeEP, la première bibliothèque de communication open source dédiée à l'entraînement et à l'inférence des modèles Mixture of Experts (MoE), optimisant l'efficacité de communication dans l'entraînement distribué à grande échelle et réduisant la latence.
Jour 3 : DeepGEMM, une bibliothèque de calcul FP8 prenant en charge les modèles denses et MoE, spécialement conçue pour les GPU à architecture NVIDIA Hopper, améliorant significativement l'efficacité de calcul et l'utilisation du matériel.
Jour 4 : DualPipe, un algorithme de parallélisme de pipeline bidirectionnel visant à optimiser le recouvrement calcul-communication dans l'entraînement des modèles V3/R1. EPLB, un équilibreur de charge pour le parallélisme d'experts, spécialement conçu pour résoudre les problèmes de déséquilibre de charge des tâches d'experts dans les modèles d'IA à grande échelle.
Jour 5 : 3FS, un système de fichiers distribué haute performance.









