
 Assistant scénario▸
 Apps AI
 Actualités AI
FlashMLA : le noyau de décodage MLA performant de DeepSeek, optimisé pour les séquences de longueur variable
小编 ·

FlashMLA : le noyau de décodage MLA performant de DeepSeek, optimisé pour les séquences de longueur variable
Qu'est-ce que FlashMLA ?
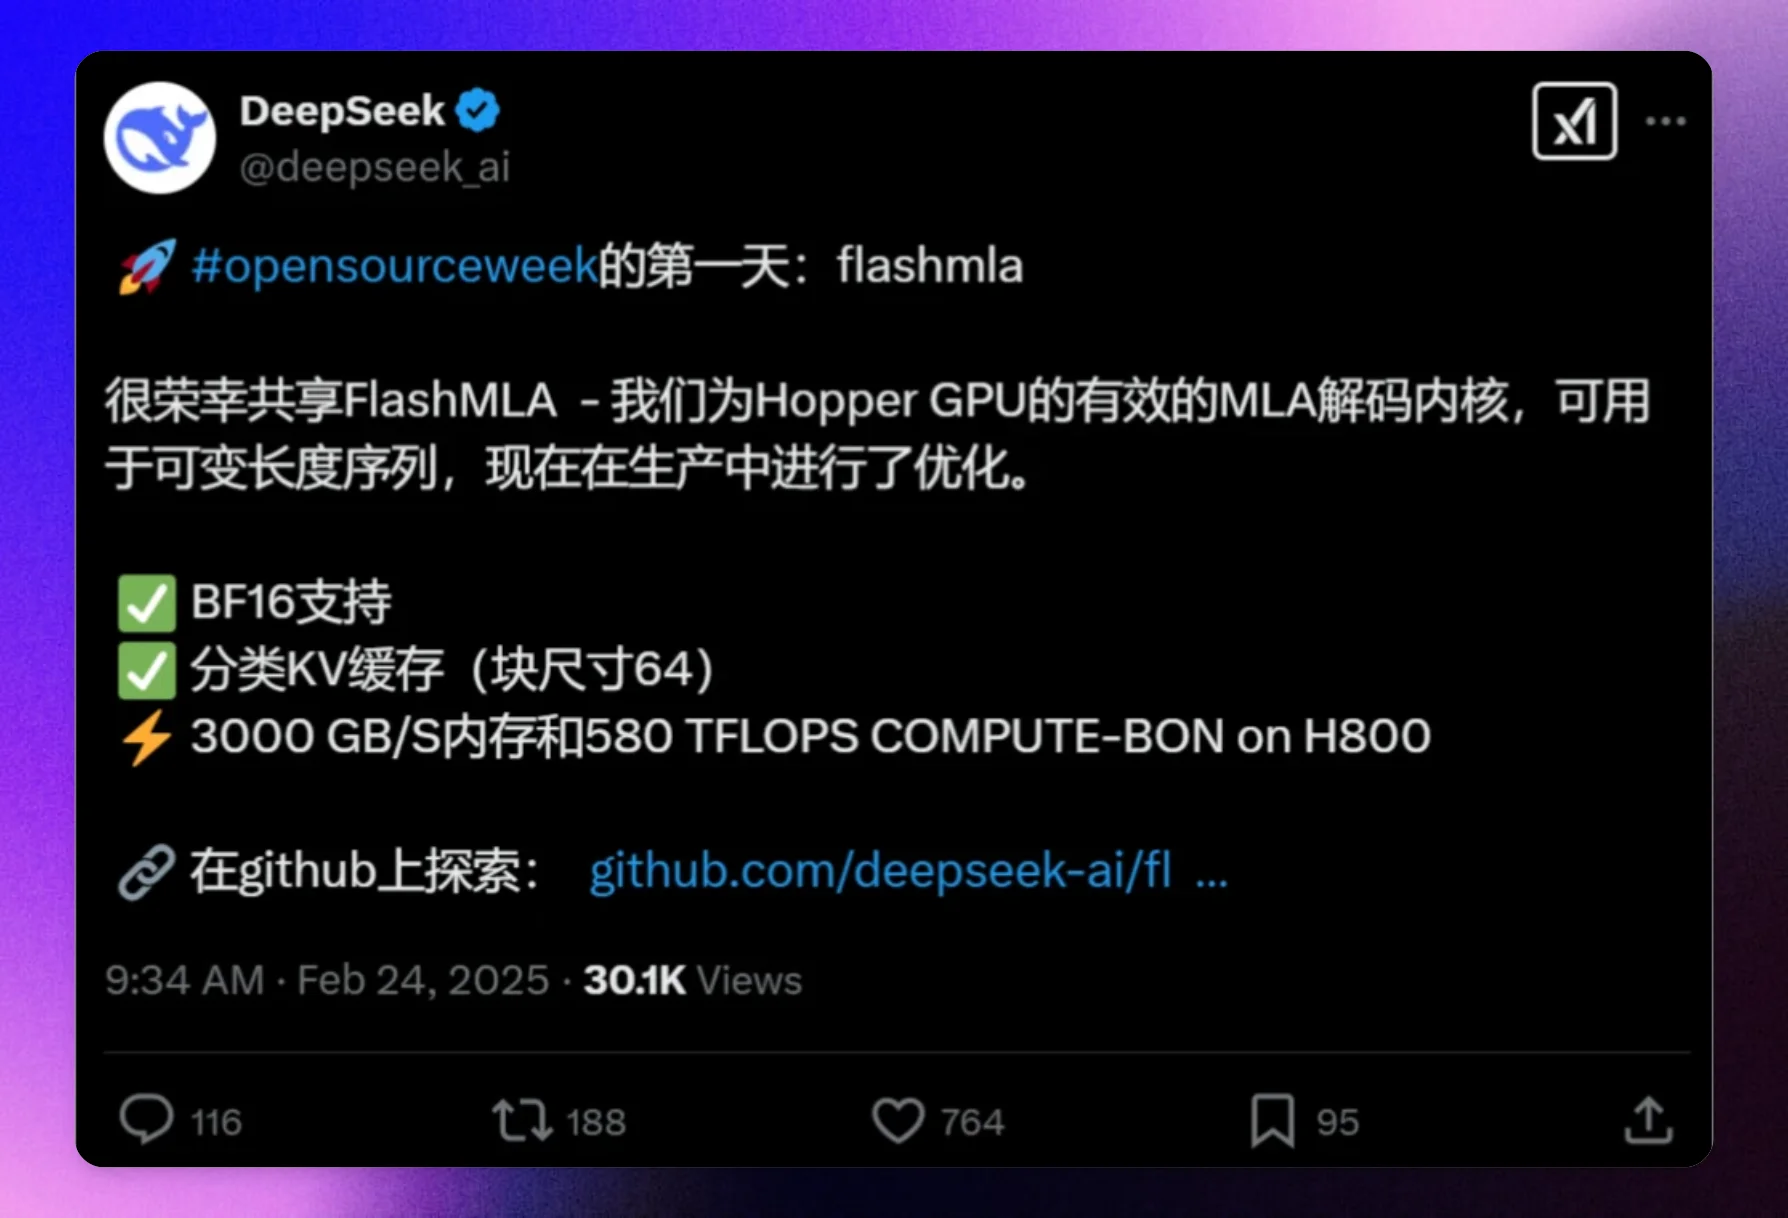
FlashMLA est un noyau de décodage MLA (Multi-Head Latent Attention) lancé par DeepSeek le 24 février 2025, optimisé pour les GPU à architecture NVIDIA Hopper (comme le H800), et particulièrement optimisé pour le traitement de séquences de longueur variable.
Principales caractéristiques de FlashMLA :
Prise en charge de BF16 : FlashMLA prend en charge le type de données BF16 (Bfloat16), ce qui le rend plus efficace en termes de calcul et d'utilisation de la mémoire.
Cache KV paginé : la gestion du cache clé-valeur (KV) se fait via un mécanisme de pagination avec une taille de bloc de 64, ce qui permet de traiter efficacement des séquences à grande échelle.
Haute performance : FlashMLA peut atteindre une bande passante mémoire de 3000 Go/s (dans des scénarios limités par la mémoire) et une performance de calcul de 580 TFLOPS (dans des scénarios limités par le calcul, basée sur le type de données BF16).
Contexte technique de FlashMLA :
FlashMLA a été conçu pour résoudre les goulets d'étranglement de calcul et de mémoire auxquels les grands modèles de langage sont confrontés pendant l'inférence. Le mécanisme traditionnel d'attention multi-têtes (MHA) nécessite une grande quantité de mémoire pour stocker le cache clé-valeur (KV) lors du traitement de longues séquences, ce qui limite le déploiement du modèle sur des ressources matérielles limitées. MLA réduit la taille du cache KV en introduisant un mécanisme d'attention latente, tout en maintenant les performances du modèle.
Scénarios d'application de FlashMLA :
FlashMLA est particulièrement adapté aux tâches de traitement du langage naturel (NLP) nécessitant un décodage efficace, comme l'inférence de grands modèles de langage (LLM). Il est optimisé pour les séquences de longueur variable et a été validé dans des environnements de production réels, ce qui le rend idéal pour les besoins de calcul haute performance.
Implémentation technique de FlashMLA
Compression de bas rang : MLA réalise une compression efficace du cache KV grâce à la décomposition matricielle de bas rang, réduisant ainsi l'occupation mémoire.
Optimisation du cache KV : optimisation du mécanisme de cache KV, réduisant considérablement les besoins en ressources matérielles et donc les coûts d'inférence.
Décodage parallèle : introduction d'un mécanisme de décodage parallèle permettant de traiter simultanément plusieurs tokens, améliorant ainsi significativement la vitesse d'inférence.
Amélioration des performances de FlashMLA
Après avoir adopté FlashMLA, DeepSeek a constaté une amélioration d'environ 5 % de la précision dans les tâches de traitement du langage naturel, une augmentation de 20 % de la vitesse d'inférence et une réduction de 15 % de la consommation de ressources de calcul. Ces améliorations permettent à DeepSeek de mieux performer dans les scénarios d'interaction en temps réel (comme la conversation ai et la traduction en temps réel).
Installation et utilisation de FlashMLA
Configuration requise :
GPU à architecture Hopper (comme NVIDIA A100)
CUDA 12.3 ou version ultérieure
PyTorch 2.0 ou version ultérieure
1. Tout d'abord, vous devez installer la bibliothèque FlashMLA. Vous pouvez l'installer via la commande suivante :
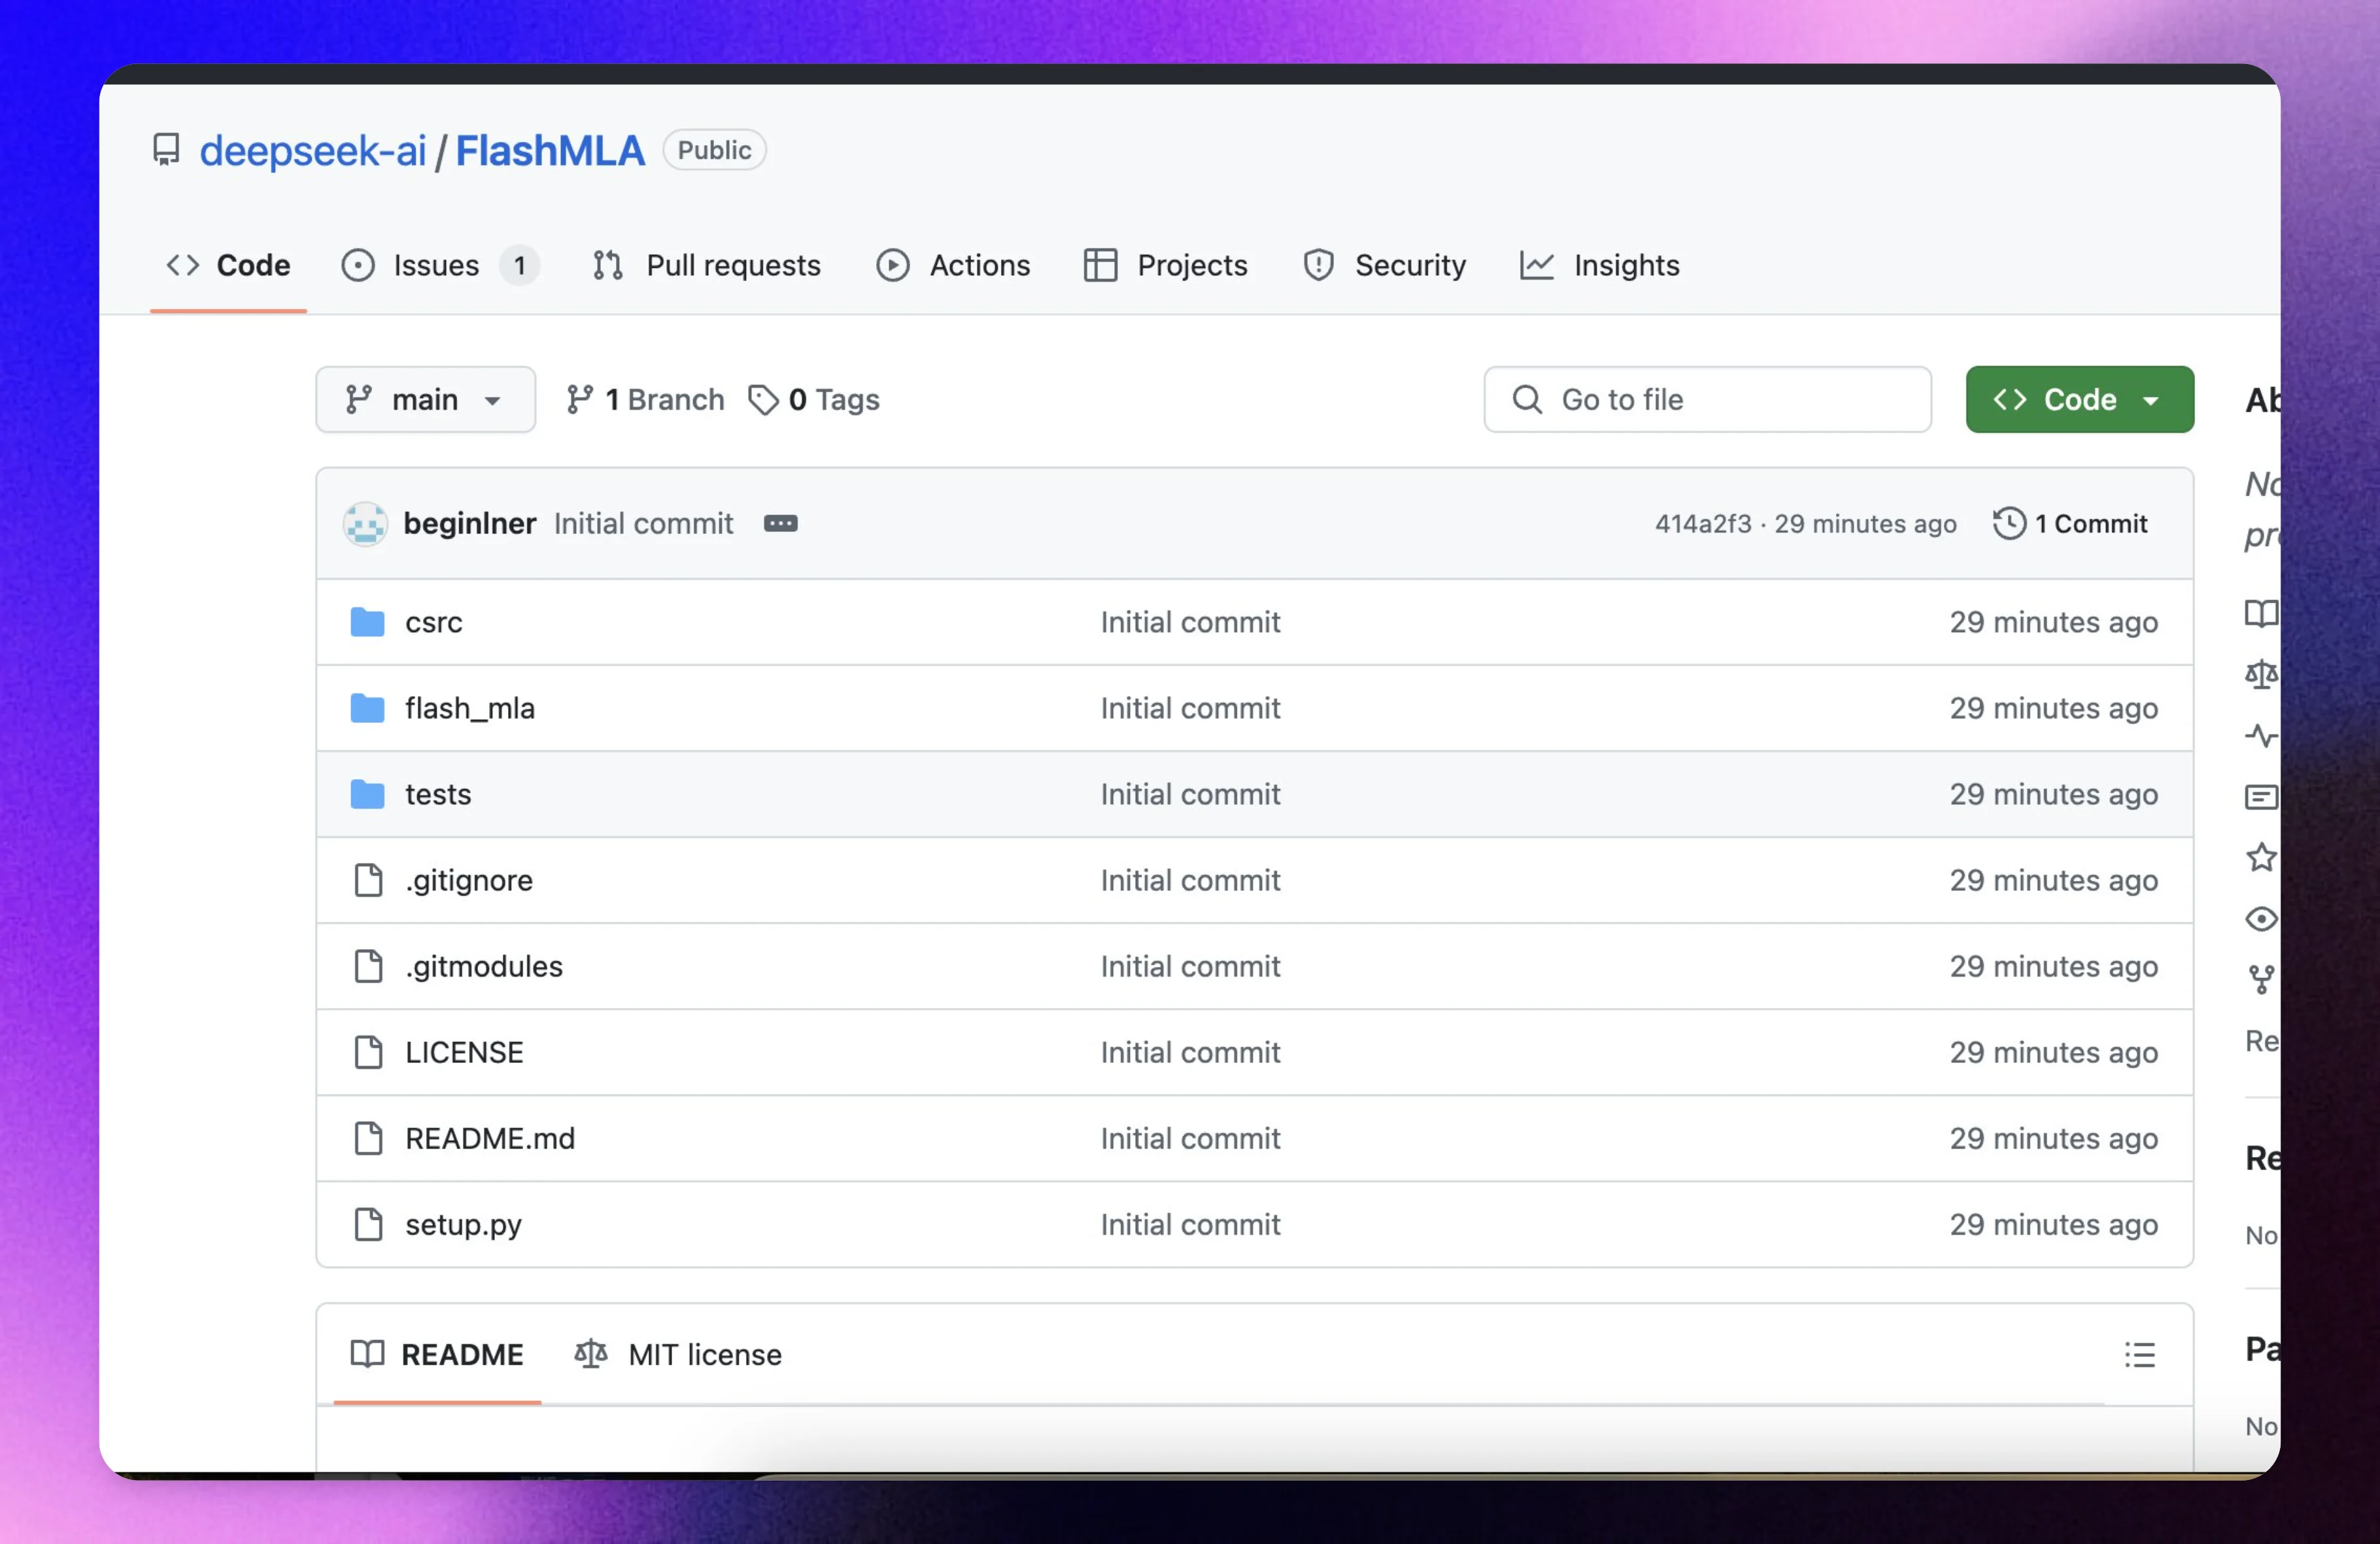
git clone https://github.com/deepseek-ai/FlashMLA.git
cd FlashMLA
python setup.py install
Ou, si vous avez déjà cloné le dépôt et souhaitez le reconstruire :
python setup.py clean --all && python setup.py build_ext --inplace
2. Obtenir les métadonnées MLA
Avant d'utiliser FlashMLA, vous devez obtenir les métadonnées de MLA. Cela implique généralement de préparer les tenseurs d'entrée et les autres paramètres nécessaires.
from flash_mla import get_mla_metadata, flash_mla_with_kvcache

# Supposons que vous disposez déjà de cache_seqlens et des autres variables pertinentes
cache_seqlens = [...]  # liste des longueurs de chaque séquence
s_q = ...              # dimension de la requête
h_q = ...              # nombre de têtes
h_kv = ...             # nombre de têtes clé-valeur

tile_scheduler_metadata, num_splits = get_mla_metadata(cache_seqlens, s_q * h_q // h_kv, h_kv)
3. Exécuter le décodage MLA
Ensuite, vous pouvez effectuer l'opération de décodage MLA. Supposons que vous disposez déjà des composants nécessaires tels que la matrice de requête q_i, le cache clé-valeur kvcache_i, la table de blocs block_table, etc.
dv = ...               # dimension de sortie

for i in range(num_layers):  # parcours de chaque couche
    o_i, lse_i = flash_mla_with_kvcache(
        q_i[i],                # matrice de requête de la couche courante
        kvcache_i[i],           # cache clé-valeur de la couche courante
        block_table,            # table de blocs
        cache_seqlens,          # longueurs des séquences en cache
        dv,                     # dimension de sortie
        tile_scheduler_metadata,# métadonnées MLA
        num_splits,             # nombre de divisions
        causal=True             # masque causal ou non
    )
    # Continuer le traitement des résultats o_i et lse_i
FlashMLA github :https://github.com/deepseek-ai/FlashMLA









