
 Assistant scénario▸
 Apps AI
 Actualités AI
DeepSeek Open-Source Week, jour 2 : DeepEP est disponible
小编 ·

DeepSeek Open-Source Week, jour 2 : DeepEP est disponible
Hier, c'était le premier jour de la semaine open source de DeepSeek ai, et le projet open source était FlashMLA. En moins d'une demi-heure, le dépôt GitHub avait déjà obtenu plus de 300 étoiles, et en seulement 1 heure, il a dépassé les 100 000 lectures, devenant extrêmement populaire. Aujourd'hui, c'est le deuxième jour de la semaine open source de DeepSeek, et DeepSeek a publié son deuxième projet open source : Deepep.
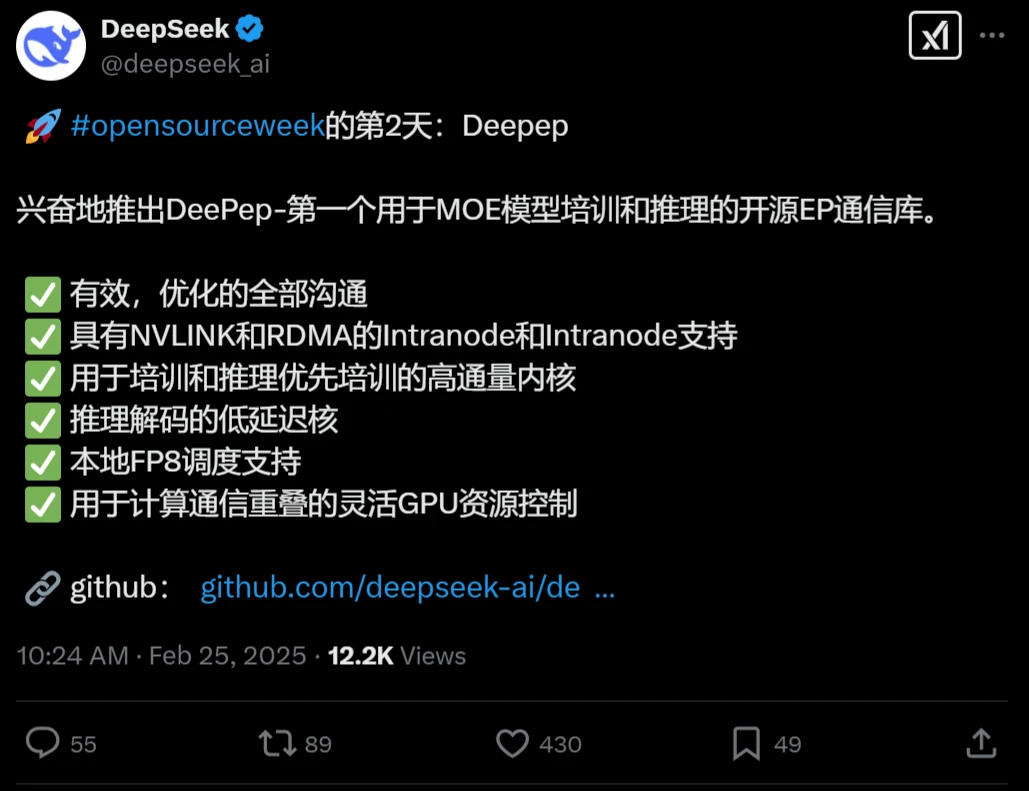
Qu'est-ce que Deepep ?
Deepep est une bibliothèque de communication EP open source pour l'entraînement et l'inférence de modèles MOE. Elle est basée sur une architecture avancée de mélange d'experts (Mixture-of-Experts) et exploite pleinement de grands ensembles de données pour améliorer l'efficacité du pré-entraînement et du fine-tuning. DeepEP est conçu pour réduire la charge de calcul et l'utilisation de la mémoire, permettant aux utilisateurs d'exécuter efficacement des modèles à grande échelle sur du matériel conventionnel.
Fonctionnalités et caractéristiques de Deepep
Optimisation de l'architecture MoE :
DeepEP est spécialement conçu pour le Mixture-of-Experts (MoE) et le parallélisme d'experts (EP), fournissant des noyaux GPU all-to-all performants pour les tâches d'entraînement et d'inférence.
Prend en charge les calculs en basse précision, notamment FP8 et BF16, améliorant l'efficacité de calcul et économisant la mémoire vidéo.
Communication haute performance :
Fournit des noyaux de communication à haut débit et faible latence, prenant en charge les réseaux NVLink et RDMA. Testé sur GPU H800, la bande passante maximale peut atteindre 153 Go/s (NVLink) et 46 Go/s (RDMA).
Optimisé pour les scénarios de transfert de bande passante asymétrique de NVLink vers RDMA, garantissant des performances à haut débit.
Communication à faible latence :
Fournit des noyaux RDMA purs à faible latence, particulièrement adaptés à la phase de décodage d'inférence, avec une latence aussi basse que 163 microsecondes.
Introduit une méthode de chevauchement communication-calcul basée sur des hooks, n'occupant pas les ressources GPU SM, maximisant ainsi l'efficacité de calcul.
Optimisation matérielle :
Exploite des instructions PTX non publiées pour améliorer les performances de l'architecture Hopper.
Prend en charge les réseaux InfiniBand et est théoriquement compatible avec RoCE, offrant des options de configuration réseau flexibles.
Scénarios d'application de Deepep
Entraînement de modèles à grande échelle :
Convient à l'entraînement de modèles Mixture-of-Experts (MoE), offrant un support de communication parallèle efficace et améliorant considérablement l'efficacité de l'entraînement.
Tâches d'inférence :
Particulièrement adapté aux scénarios de décodage d'inférence sensibles à la latence, améliorant significativement l'efficacité, réduisant la latence et augmentant le débit d'inférence.
Besoins en calcul haute performance :
Parfaitement adapté aux besoins modernes en calcul haute performance, prenant en charge diverses plateformes matérielles, y compris l'architecture GPU Hopper, avec la possibilité d'étendre à davantage de dispositifs à l'avenir.
Utilisation et intégration de Deepep
Facilité d'utilisation :
Prend en charge l'architecture GPU Hopper et nécessite un environnement Python 3.8+, CUDA 12.3+ et PyTorch 2.1+.
L'installation doit être accompagnée de la version modifiée par l'équipe de NVSHMEM, avec un guide d'installation détaillé.
Méthode d'intégration :
Open source et facile à intégrer, seulement quelques lignes de commande suffisent pour construire et exécuter les tests.
Après l'installation, il suffit d'importer le module deep_ep pour l'utiliser directement, avec des exemples de code et des scripts de test fournis.
DeepEP est déjà open source sur GitHub, à l'adresse : https://github.com/deepseek-ai/DeepEP
1. Projet open source du premier jour de la semaine open source de DeepSeek : DeepSeek FlashMLA









