
 Assistant scénario▸
 Apps AI
 Actualités AI
DeepSeek Open Source Week, jour 5 : 3FS, un système de fichiers distribué hautes performances
小编 ·

DeepSeek Open Source Week, jour 5 : 3FS, un système de fichiers distribué hautes performances
D'un côté GPT4.5 vient d'être publié, de l'autre DeepSeek entre dans le cinquième jour de sa Semaine Open Source, et le projet open source du dernier jour est : 3FS (Fire-Flyer File System).
Qu'est-ce que 3FS (Fire-Flyer File System) ?
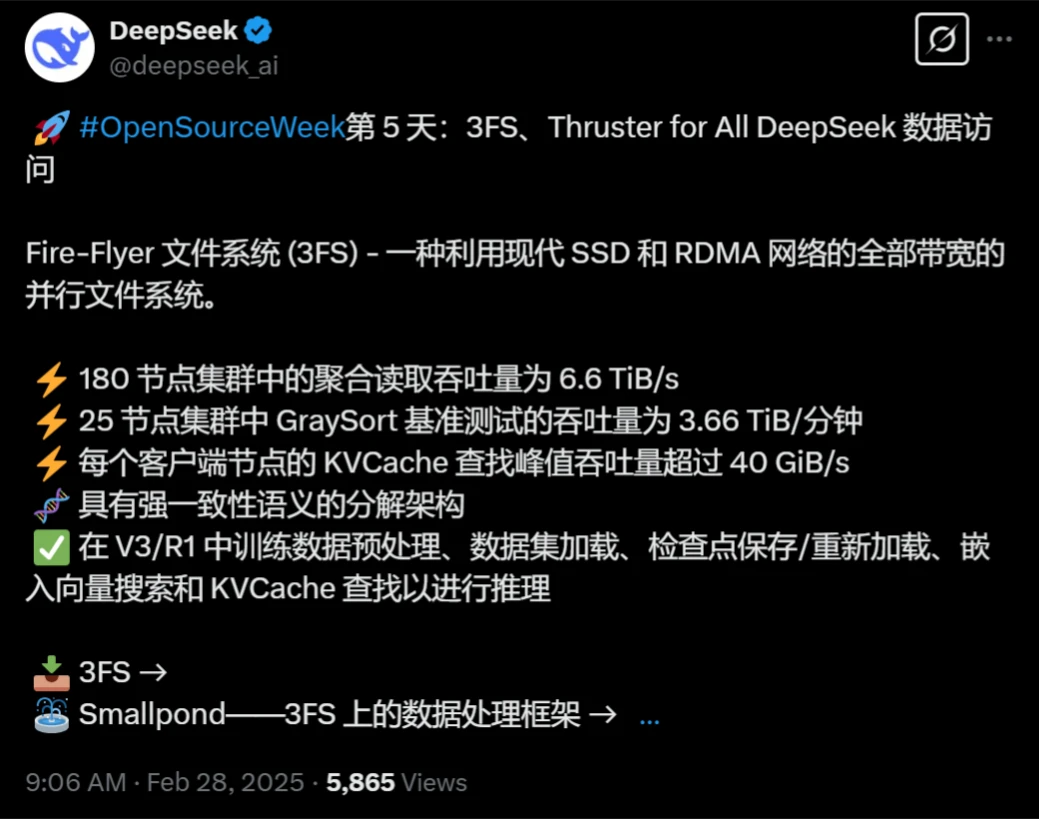
3FS (Fire-Flyer File System) est un système de fichiers distribué haute performance développé en interne par DeepSeek, conçu spécifiquement pour relever les défis des charges de travail d'entraînement et d'inférence en ia.
Caractéristiques de 3FS
Haute performance :
Exploite les SSD modernes et les réseaux RDMA pour offrir un accès aux données à haut débit et faible latence.
Combine le débit de milliers de SSD et la bande passante réseau de centaines de nœuds de stockage, permettant aux applications d'accéder aux ressources de stockage indépendamment de leur localisation.
Cohérence forte :
Garantit une cohérence forte grâce à l'implémentation de la réplication en chaîne avec requêtes distribuées (CRAQ), rendant le code applicatif plus simple et plus facile à raisonner.
Interface fichiers :
Adopte un service de métadonnées sans état, soutenu par un stockage clé-valeur transactionnel (tel que FoundationDB).
Interface fichiers familière, sans besoin d'apprendre une nouvelle API de stockage.
Support de charges de travail diversifiées :
Préparation des données : organise la sortie des pipelines d'analyse de données en structures de répertoires hiérarchiques, gérant efficacement un grand volume de sorties intermédiaires.
Chargeurs de données : élimine le besoin de pré-lecture ou de mélange des données en prenant en charge l'accès aléatoire aux échantillons d'entraînement à travers les nœuds de calcul.
Points de contrôle : prend en charge les points de contrôle parallèles à haut débit pour l'entraînement à grande échelle.
Cache KV d'inférence : offre une alternative rentable aux caches DRAM, fournissant un débit plus élevé et une capacité considérablement accrue.
Séparation stockage-calcul :
Le service de stockage de données est séparé des nœuds de calcul, dédié au stockage des données d'échantillons nécessaires à l'entraînement des modèles.
Chaque nœud de service de stockage est équipé de 16 disques SSD de 15 To chacun et de 2 cartes réseau haut débit, offrant de solides performances en lecture et une bande passante réseau puissante, avec une bande passante de lecture/écriture de 7,0 To/s.
Outils de communication développés en interne :
Comme hfreduce, qui optimise la communication parallèle multi-cartes, remplaçant NCCL de NVIDIA et réduisant le trafic PCIe ainsi que les coûts de calcul.
Format de données dédié FFRecord :
Réduit la surcharge liée à l'ouverture d'un grand nombre de petits fichiers pendant l'entraînement en fusionnant plusieurs petits fichiers.
Améliore les performances de lecture aléatoire par lot grâce aux offsets des fichiers d'échantillons.
Applications de 3FS
Entraînement et inférence IA :
3FS est conçu pour les charges de travail d'entraînement et d'inférence en IA, améliorant significativement l'efficacité de ces tâches.
Grâce à sa haute performance et sa cohérence forte, 3FS prend en charge l'entraînement de modèles à grande échelle et l'inférence à haut débit.
Préparation et chargement des données :
Les fonctionnalités de préparation et de chargement des données de 3FS rendent le traitement de grands volumes de données plus efficace, réduisant le besoin de pré-lecture et de mélange des données.
Points de contrôle et cache d'inférence :
3FS prend en charge les points de contrôle parallèles à haut débit, garantissant la stabilité et la tolérance aux pannes du processus d'entraînement.
Le cache KV d'inférence offre une alternative rentable, améliorant le débit et la capacité d'inférence.
Utilisation de 3FS
Installation et configuration :
3FS peut être installé et configuré via le projet open source disponible sur GitHub.
Conversion de format de données :
Utilisez le format FFRecord pour le stockage et le chargement des données ; les données d'échantillons doivent être converties au format FFRecord.
Des outils de conversion FFRecord sont fournis pour faciliter la conversion des formats de données.
Intégration avec PyTorch :
3FS s'adapte aux interfaces Dataset et Dataloader de PyTorch, permettant de charger facilement les données et de lancer l'entraînement.
Adresse du projet GitHub :https://github.com/deepseek-ai/3FS
Rappel des projets open source des quatre premiers jours
Premier jour : FlashMLA, noyaux de décodage efficaces pour les GPU NVIDIA Hopper, optimisant les performances de l'attention latente multi-têtes (MLA) et améliorant significativement la vitesse de réponse des outils IA dans la création de contenu.
Deuxième jour : DeepeEP, première bibliothèque de communication open source dédiée à l'entraînement et à l'inférence des modèles Mixture of Experts (MoE), optimisant l'efficacité de la communication dans l'entraînement distribué à grande échelle et réduisant la latence.
Troisième jour : DeepGEMM, bibliothèque de calcul FP8 prenant en charge les modèles denses et MoE, conçue spécifiquement pour les GPU à architecture NVIDIA Hopper, améliorant significativement l'efficacité de calcul et l'utilisation matérielle.
Quatrième jour : DualPipe, un algorithme de parallélisme de pipeline bidirectionnel visant à optimiser le chevauchement entre calcul et communication dans l'entraînement des modèles V3/R1. EPLB, un équilibreur de charge parallèle pour experts, spécialement conçu pour résoudre les problèmes de déséquilibre de charge des tâches parallèles d'experts dans les modèles IA à grande échelle.









