
 Asistente de guiones▸
 Apps AI
 Noticias AI
Día 6 de la Semana Open Source de DeepSeek: sistema de inferencia DeepSeek-V3/R1 con un margen de beneficio del 545%
小编 ·

Día 6 de la Semana Open Source de DeepSeek: sistema de inferencia DeepSeek-V3/R1 con un margen de beneficio del 545%
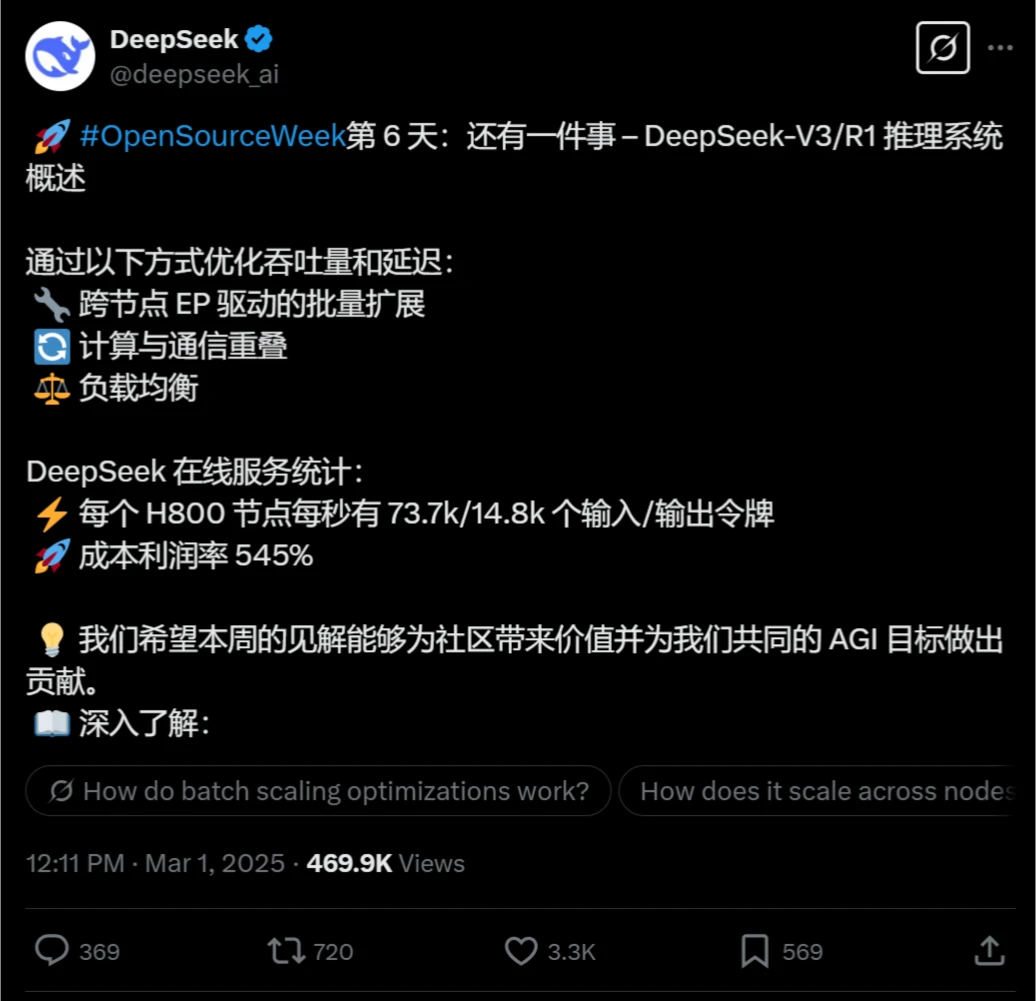
La semana de código abierto prometía 5 días, pero quién iba a imaginar que el sábado traerían un regalo extra: el sistema de inferencia DeepSeek-V3/R1.
¿Qué es el sistema de inferencia DeepSeek-V3/R1?
El sistema de inferencia DeepSeek-V3/R1 es el sistema de inferencia de alto rendimiento presentado recientemente por DeepSeek, diseñado para mejorar la eficiencia de la inferencia optimizando el rendimiento y la latencia. El sistema adopta la tecnología de paralelismo de expertos entre nodos a gran escala (Expert Parallelism, EP), lo que mejora significativamente la eficiencia del cálculo matricial en las GPU y reduce la latencia al distribuir los módulos de expertos entre distintas GPU.
Características principales
Optimización de alto rendimiento y baja latencia:
Adopta la tecnología de paralelismo de expertos entre nodos (Expert Parallelism, EP), ampliando notablemente el tamaño de los lotes y mejorando la eficiencia del cálculo matricial en las GPU.
Mediante una arquitectura desacoplada de prellenado y decodificación, se aplican distintas estrategias de paralelismo en las fases de prellenado y decodificación.
Balanceo inteligente de carga:
Se logra el equilibrio de la carga entre el cálculo central de atención y el envío de distribución en las fases de prellenado y decodificación, respectivamente.
En el modelo de Mezcla de Expertos (MoE), se equilibra la carga de cálculo de los expertos en cada GPU.
Solapamiento de cálculo y comunicación:
Se adopta una estrategia de solapamiento de doble lote (dual-batch), dividiendo el mismo lote de solicitudes en dos microlotes para ocultar el coste de comunicación y aumentar el rendimiento global.
En la fase de decodificación, se emplea una técnica de pipeline de cinco etapas, logrando un solapamiento continuo entre cálculo y comunicación.
Paralelismo de expertos entre nodos a gran escala (EP):
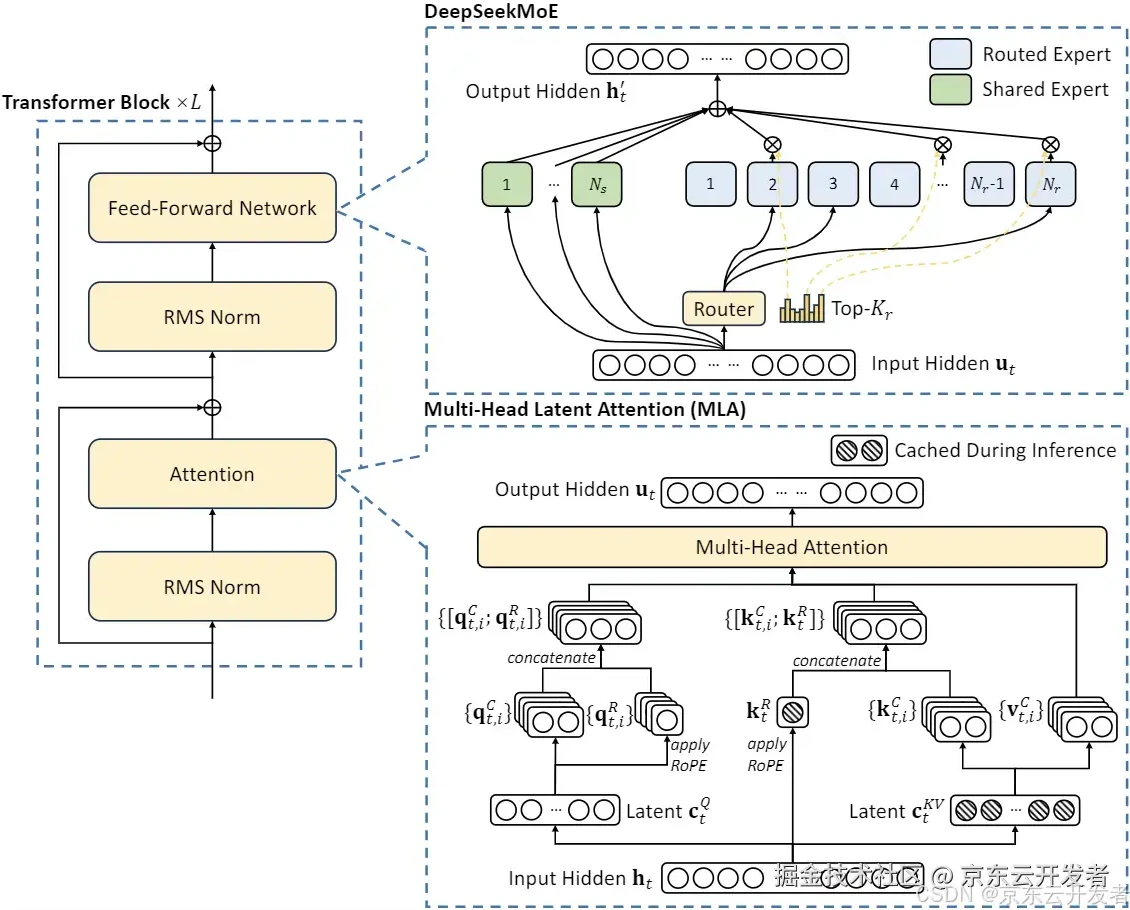
De los 256 expertos por capa, solo se activan 8. La alta dispersión del modelo exige un tamaño de lote global muy elevado.
En la fase de prellenado se utilizan EP32 para los expertos de enrutamiento y DP32 para MLA/expertos compartidos; en la fase de decodificación se utilizan EP144 para los expertos de enrutamiento y DP144 para MLA/expertos compartidos.
Uso eficiente de recursos:
Durante las horas punta del día, todos los nodos se dedican al servicio de inferencia; durante las horas de baja carga nocturna, se reduce el número de nodos de inferencia y los recursos se reasignan a investigación y entrenamiento.
Tecnologías clave
Paralelismo de expertos entre nodos (EP): los modelos DeepSeek-V3/R1 pueden activar una gran cantidad de redes de expertos, pero solo se activan 8 de los 256 expertos por capa, generando una estructura de cálculo altamente dispersa.
Balanceo de carga: el diseño del sistema garantiza una distribución uniforme de la carga de cálculo entre los nodos, permitiendo aprovechar todos los recursos de forma eficaz.
Coste y rentabilidad: según la última evaluación del modelo, asumiendo un coste de alquiler de GPU de 2 dólares por hora, el coste total es de 87.072 dólares al día, mientras que los ingresos teóricos diarios podrían alcanzar los 562.027 dólares, con un margen de coste-beneficio del 545%.
Aplicaciones
Servicios de inferencia en línea:
Todos los servicios de inferencia de DeepSeek-V3/R1 se ejecutan en GPU H800, manteniendo la misma precisión que en el entrenamiento.
Ofrece servicios de inferencia en línea de alto rendimiento y baja latencia, aptos para todas las solicitudes de usuarios en la web, aplicaciones y APIs.
Servicios comerciales y no comerciales:
Algunos servicios se han comercializado, mientras que el acceso a través de la web y la aplicación sigue siendo gratuito.
Durante las horas de menor demanda se aplica automáticamente un descuento nocturno, optimizando el uso de recursos y la rentabilidad.
Estadísticas
En las últimas 24 horas, la ocupación máxima combinada de nodos de los servicios de inferencia V3 y R1 alcanzó los 278 nodos, con una ocupación media de 226,75 nodos (cada nodo contiene 8 GPU H800).
Cada nodo H800 ofrece un rendimiento medio de entrada de aproximadamente 73.700 tokens/segundo en la fase de prellenado, o de aproximadamente 14.800 tokens/segundo de salida en la fase de decodificación.
Si todos los tokens se facturaran al precio de DeepSeek-R1, los ingresos diarios totales alcanzarían los 562.027 dólares, con un margen de beneficio del 545%.
Repaso de los proyectos de código abierto de los cinco primeros días
Día 1: FlashMLA, un kernel de decodificación eficiente para GPU NVIDIA Hopper que optimiza el rendimiento de la atención latente multi-cabezal (MLA), mejorando notablemente la velocidad de respuesta de las herramientas de IA en la creación de contenidos.
Día 2: DeepeEP, la primera biblioteca de comunicación de código abierto para entrenamiento e inferencia de modelos de Mezcla de Expertos (MoE), que optimiza la eficiencia de la comunicación en el entrenamiento distribuido a gran escala y reduce la latencia.
Día 3: DeepGEMM, una biblioteca de cálculo FP8 compatible con modelos densos y MoE, diseñada específicamente para GPU con arquitectura NVIDIA Hopper, que mejora notablemente la eficiencia de cálculo y el aprovechamiento del hardware.
Día 4: DualPipe, un algoritmo de paralelismo de pipeline bidireccional diseñado para optimizar el solapamiento de cálculo y comunicación en el entrenamiento de los modelos V3/R1. EPLB, un balanceador de carga de paralelismo de expertos, creado específicamente para resolver el desequilibrio de carga en tareas de paralelismo de expertos en modelos de IA a gran escala.
Día 5: 3FS, un sistema de archivos distribuido de alto rendimiento.









