
 Asistente de guiones▸
 Apps AI
 Noticias AI
FlashMLA: el eficiente kernel de decodificación MLA de DeepSeek, optimizado para secuencias de longitud variable
小编 ·

FlashMLA: el eficiente kernel de decodificación MLA de DeepSeek, optimizado para secuencias de longitud variable
¿Qué es FlashMLA?
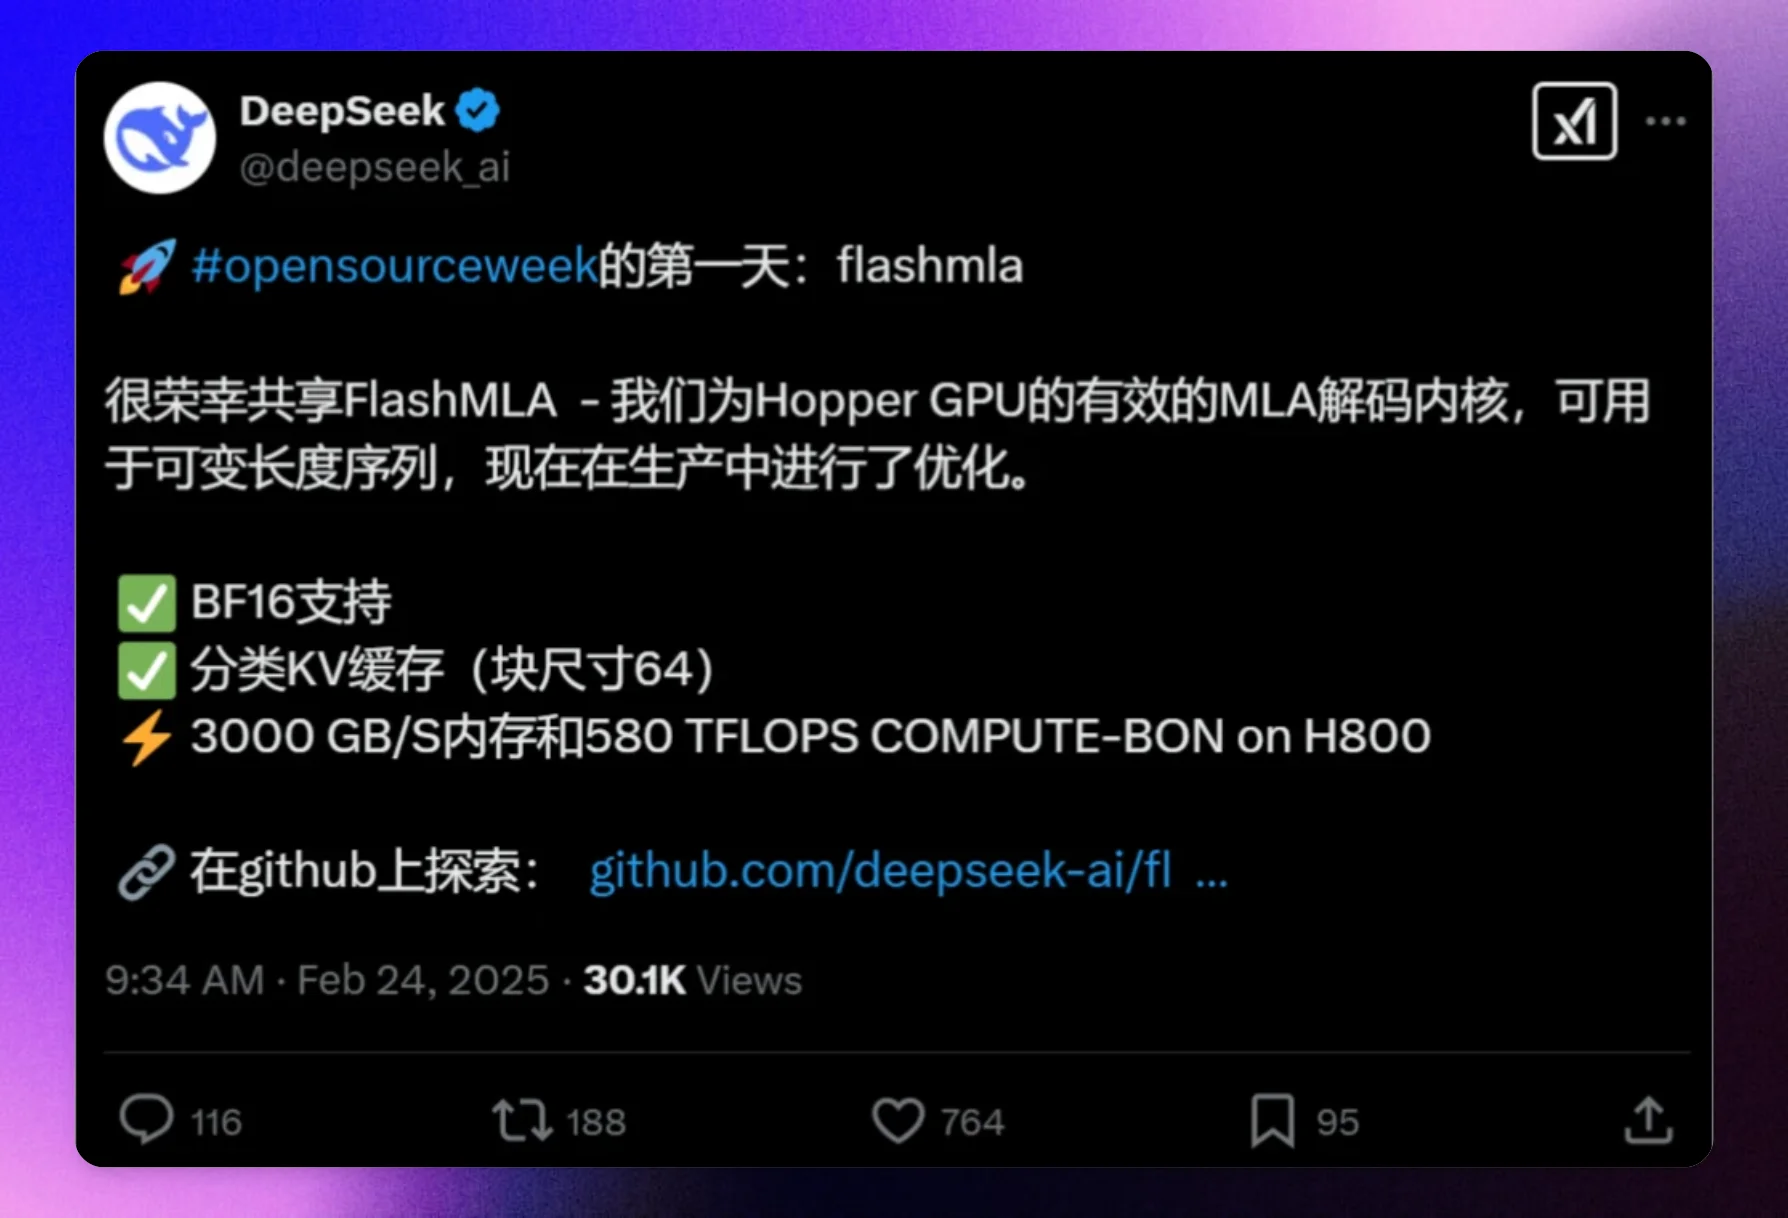
FlashMLA es un núcleo de decodificación MLA (Multi-Head Latent Attention) lanzado por DeepSeek el 24 de febrero de 2025, optimizado para GPU con arquitectura NVIDIA Hopper (como H800), con especial optimización para el procesamiento de servicios con secuencias de longitud variable.
Características principales de FlashMLA:
Soporte BF16: FlashMLA admite el tipo de datos BF16 (Bfloat16), lo que lo hace más eficiente en cálculo y uso de memoria.
Cache KV paginada: gestiona la caché de clave-valor (KV) mediante un mecanismo de paginación con un tamaño de bloque de 64, lo que le permite procesar secuencias a gran escala de manera eficiente.
Alto rendimiento: FlashMLA puede alcanzar un ancho de banda de memoria de 3000 GB/s (en escenarios con cuello de botella en memoria) y un rendimiento de cálculo de 580 TFLOPS (en escenarios con cuello de botella en cálculo, basado en el tipo de datos BF16).
Contexto técnico de FlashMLA:
FlashMLA surgió para resolver los cuellos de botella de cálculo y memoria a los que se enfrentan los modelos de lenguaje grandes durante la inferencia. El mecanismo tradicional de atención multi-cabezal (MHA) requiere grandes cantidades de memoria para almacenar los pares clave-valor (KV) en la caché al procesar secuencias largas, lo que limita el despliegue del modelo en recursos de hardware limitados. MLA, mediante la introducción del mecanismo de atención latente, reduce el tamaño de la caché KV manteniendo el rendimiento del modelo.
Escenarios de aplicación de FlashMLA:
FlashMLA es especialmente adecuado para tareas de procesamiento de lenguaje natural (NLP) que requieren una decodificación eficiente, como la inferencia de modelos de lenguaje grandes (LLM). Está optimizado para secuencias de longitud variable y ha sido validado en entornos de producción reales, siendo ideal para necesidades de computación de alto rendimiento.
Implementación técnica de FlashMLA
Compresión de bajo rango: MLA logra una compresión efectiva de la caché KV mediante la descomposición de matrices de bajo rango, reduciendo el uso de memoria.
Optimización de la caché KV: optimiza el mecanismo de la caché KV, reduciendo significativamente los requisitos de recursos de hardware y, por tanto, los costes de inferencia.
Decodificación paralela: introduce un mecanismo de decodificación paralela que permite procesar múltiples tokens simultáneamente, mejorando notablemente la velocidad de inferencia.
Mejora de rendimiento de FlashMLA
Tras adoptar FlashMLA, DeepSeek logró un aumento de aproximadamente el 5% en la precisión de las tareas de procesamiento de lenguaje natural, una mejora del 20% en la velocidad de inferencia y una reducción del 15% en el consumo de recursos de cálculo. Estas mejoras permiten que DeepSeek tenga un mejor desempeño en escenarios de interacción en tiempo real (como ai conversacional y traducción en tiempo real).
Instalación y uso de FlashMLA
Requisitos del entorno:
GPU con arquitectura Hopper (como NVIDIA A100)
CUDA 12.3 o superior
PyTorch 2.0 o superior
1. En primer lugar, necesitas instalar la biblioteca FlashMLA. Puedes hacerlo con el siguiente comando:
git clone https://github.com/deepseek-ai/FlashMLA.git
cd FlashMLA
python setup.py install
O si ya has clonado el repositorio y deseas reconstruirlo:
python setup.py clean --all && python setup.py build_ext --inplace
2. Obtener los metadatos de MLA
Antes de usar FlashMLA, necesitas obtener los metadatos de MLA. Esto generalmente implica preparar los tensores de entrada y otros parámetros necesarios.
from flash_mla import get_mla_metadata, flash_mla_with_kvcache

# Suponiendo que ya tienes cache_seqlens y otras variables relacionadas
cache_seqlens = [...]  # Lista de longitudes de cada secuencia
s_q = ...              # Dimensión de consulta
h_q = ...              # Número de cabezas
h_kv = ...             # Número de cabezas de clave-valor

tile_scheduler_metadata, num_splits = get_mla_metadata(cache_seqlens, s_q * h_q // h_kv, h_kv)
3. Ejecutar la decodificación MLA
A continuación, puedes ejecutar la operación de decodificación MLA. Suponiendo que ya cuentas con los componentes necesarios como la matriz de consulta q_i, la caché de clave-valor kvcache_i, la tabla de bloques block_table, etc.
dv = ...               # Dimensión de salida

for i in range(num_layers):  # Recorrer cada capa
    o_i, lse_i = flash_mla_with_kvcache(
        q_i[i],                # Matriz de consulta de la capa actual
        kvcache_i[i],           # Caché de clave-valor de la capa actual
        block_table,            # Tabla de bloques
        cache_seqlens,          # Longitudes de la caché de secuencias
        dv,                     # Dimensión de salida
        tile_scheduler_metadata,# Metadatos de MLA
        num_splits,             # Número de divisiones
        causal=True             # Si se usa máscara causal
    )
    # Continuar procesando los resultados de salida o_i y lse_i
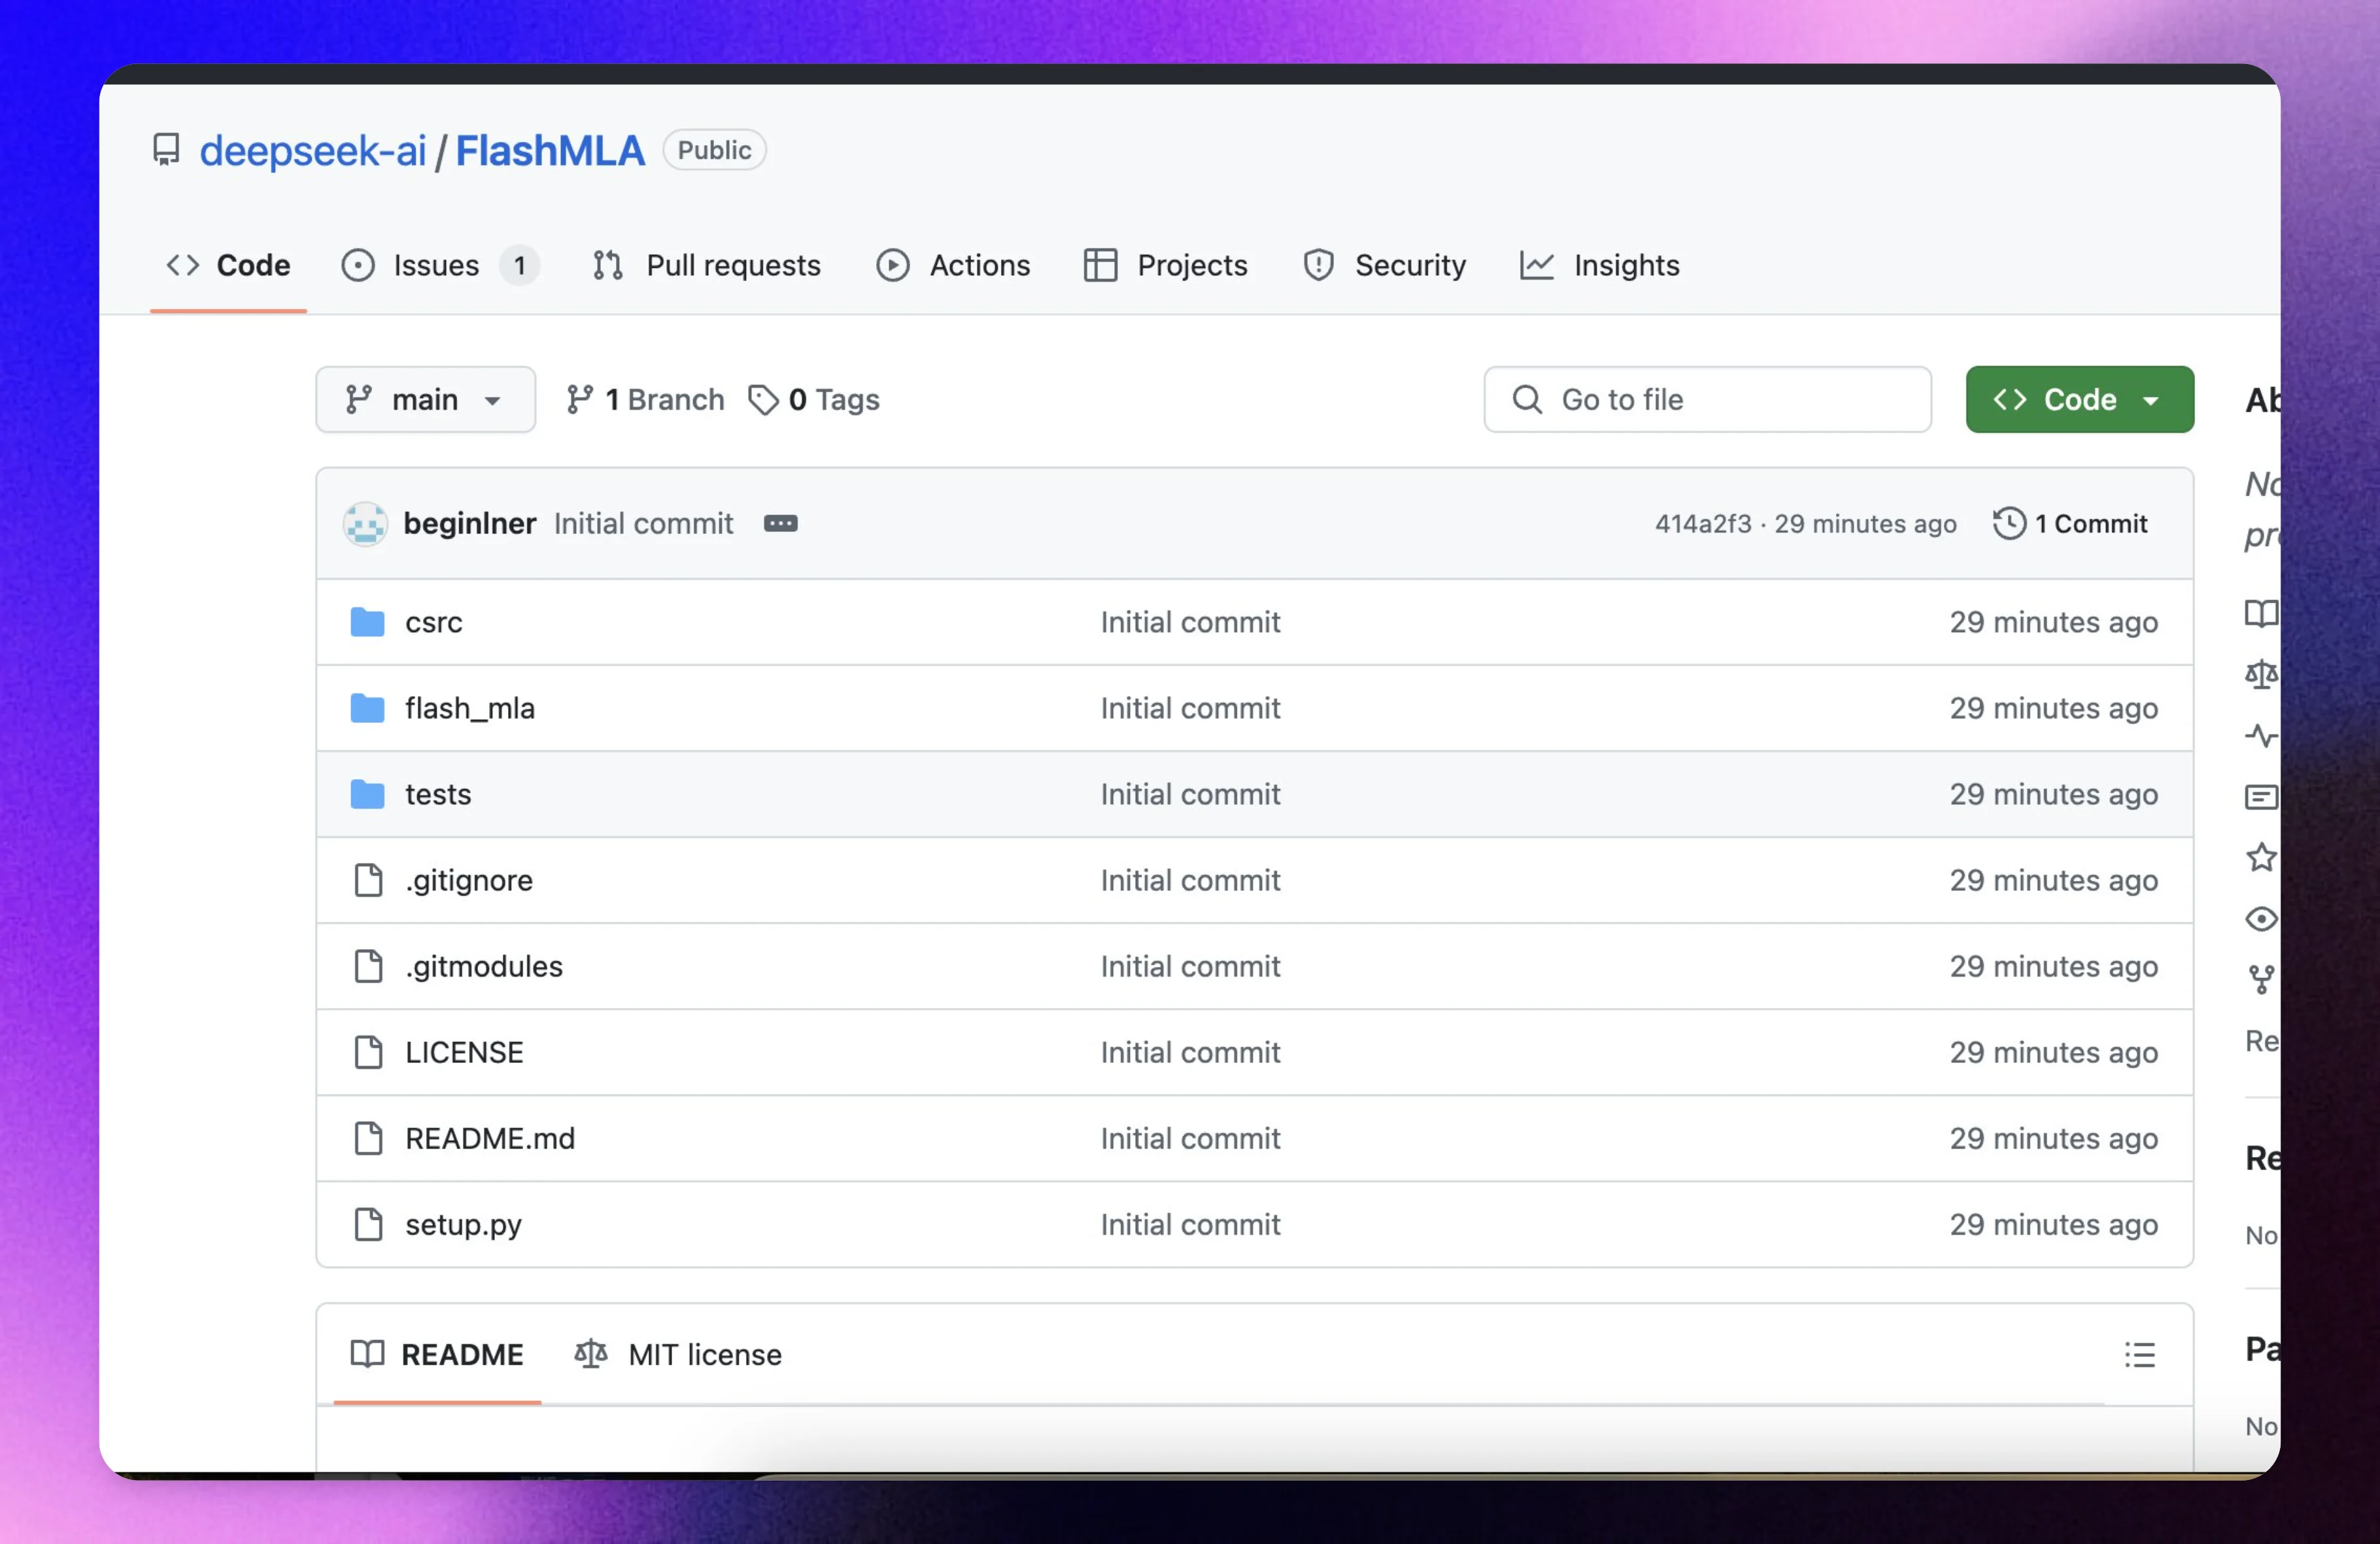
FlashMLA github:https://github.com/deepseek-ai/FlashMLA









