
 Asistente de guiones▸
 Apps AI
 Noticias AI
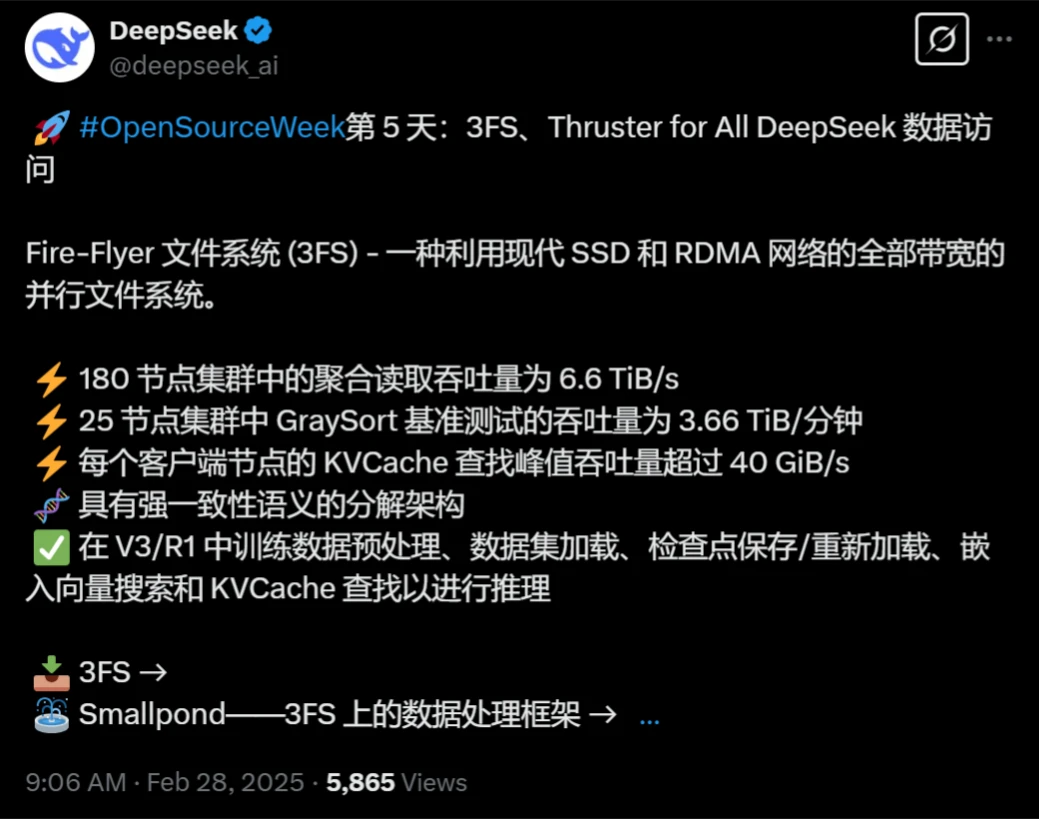
Semana de código abierto de DeepSeek, día 5: 3FS, un sistema de archivos distribuido de alto rendimiento
小编 ·

Semana de código abierto de DeepSeek, día 5: 3FS, un sistema de archivos distribuido de alto rendimiento
Aquí GPT4.5 acaba de ser lanzado, y aquí la semana de código abierto de DeepSeek llega al quinto día de proyectos de código abierto. El proyecto de código abierto del último día es: 3FS (Fire-Flyer File System).
¿Qué es 3FS (Fire-Flyer File System)?
3FS (Fire-Flyer File System) es un sistema de archivos distribuido de alto rendimiento desarrollado por DeepSeek, diseñado específicamente para abordar los desafíos de las cargas de trabajo de entrenamiento e inferencia de ai.
Características de 3FS
Alto rendimiento:
Aprovecha los SSD modernos y las redes RDMA para proporcionar un acceso a datos de alto rendimiento y baja latencia.
Combina el rendimiento de miles de SSD con el ancho de banda de red de cientos de nodos de almacenamiento, permitiendo que las aplicaciones accedan a los recursos de almacenamiento de forma independiente de la ubicación geográfica.
Fuerte consistencia:
Garantiza una fuerte consistencia mediante la implementación de Replicación en Cadena con Consultas de Distribución (CRAQ), lo que hace que el código de las aplicaciones sea más simple y fácil de razonar.
Interfaz de archivos:
Utiliza un servicio de metadatos sin estado, respaldado por un almacenamiento clave-valor transaccional (como FoundationDB).
Una interfaz de archivos familiar, sin necesidad de aprender nuevas API de almacenamiento.
Soporte para cargas de trabajo diversificadas:
Preparación de datos: organiza la salida de los pipelines de análisis de datos en estructuras de directorios jerárquicas, gestionando eficazmente grandes volúmenes de resultados intermedios.
Cargadores de datos: elimina los requisitos de prelectura o barajado de datos al admitir acceso aleatorio a muestras de entrenamiento entre nodos de cómputo.
Puntos de control: admite puntos de control paralelos de alto rendimiento para entrenamiento a gran escala.
Caché KV para inferencia: ofrece una alternativa rentable en lugar de la caché DRAM, proporcionando mayor rendimiento y una capacidad significativamente mayor.
Separación de almacenamiento y cómputo:
El servicio de almacenamiento de datos está separado de los nodos de cómputo, dedicado a almacenar los datos de muestra necesarios para el entrenamiento de modelos.
Cada nodo del servicio de almacenamiento cuenta con 16 discos SSD de 15 TB cada uno y 2 tarjetas de red de alta velocidad, con un rendimiento de lectura potente y un gran ancho de banda de red: ancho de banda de lectura/escritura: 7.0 TB/s.
Herramienta de comunicación de desarrollo propio:
Como hfreduce, que optimiza la comunicación paralela en múltiples tarjetas, reemplazando el NCCL de NVIDIA, reduciendo el tráfico PCIe y la sobrecarga computacional.
Formato de datos dedicado FFRecord:
Al combinar múltiples archivos pequeños, se reduce la sobrecarga de abrir una gran cantidad de archivos pequeños durante el entrenamiento.
Mejora el rendimiento de lectura aleatoria por lotes mediante los offsets de los archivos de muestras.
Aplicaciones de 3FS
Entrenamiento e inferencia de IA:
3FS está diseñado específicamente para cargas de trabajo de entrenamiento e inferencia de IA, capaz de mejorar significativamente la eficiencia de estas tareas.
Gracias a su alto rendimiento y fuerte consistencia, 3FS admite el entrenamiento de modelos a gran escala y la inferencia de alto rendimiento.
Preparación y carga de datos:
Las funciones de preparación y carga de datos de 3FS hacen que el procesamiento de grandes volúmenes de datos sea más eficiente, reduciendo la necesidad de prelectura y barajado de datos.
Puntos de control y caché de inferencia:
3FS admite puntos de control paralelos de alto rendimiento, garantizando la estabilidad y la tolerancia a fallos del proceso de entrenamiento.
La caché KV para inferencia ofrece una alternativa rentable, mejorando el rendimiento y la capacidad de la inferencia.
Uso de 3FS
Instalación y configuración:
3FS se puede instalar y configurar a través del proyecto de código abierto en GitHub.
Conversión de formato de datos:
Para almacenar y cargar datos utilizando el formato FFRecord, es necesario convertir los datos de muestra al formato FFRecord.
Se proporciona una herramienta de conversión FFRecord para facilitar la conversión de formato de datos a los usuarios.
Integración con PyTorch:
3FS se adapta a las interfaces Dataset y Dataloader de PyTorch, lo que permite cargar datos e iniciar el entrenamiento de manera muy conveniente.
Dirección del proyecto en GitHub:https://github.com/deepseek-ai/3FS
Repaso de los proyectos de código abierto de los cuatro días anteriores
Primer día: FlashMLA, un núcleo de decodificación eficiente para GPU NVIDIA Hopper, que optimiza el rendimiento de la Atención Latente Multi-cabeza (MLA), mejorando significativamente la velocidad de respuesta de las herramientas de IA en la creación de contenido.
Segundo día: DeepeEP, la primera biblioteca de comunicación de código abierto para entrenamiento e inferencia de modelos de Mezcla de Expertos (MoE), que optimiza la eficiencia de la comunicación en el entrenamiento distribuido a gran escala y reduce la latencia.
Tercer día: DeepGEMM, una biblioteca de cálculo FP8 compatible con modelos densos y MoE, diseñada específicamente para GPU con arquitectura NVIDIA Hopper, que mejora significativamente la eficiencia computacional y la utilización del hardware.
Cuarto día: DualPipe, un algoritmo de paralelismo de pipeline bidireccional diseñado para optimizar la superposición de cálculo y comunicación en el entrenamiento de los modelos V3/R1. EPLB, un equilibrador de carga paralelo para expertos, diseñado específicamente para resolver el problema de desequilibrio de carga en tareas paralelas por expertos en modelos de IA a gran escala.









