
 Asistente de guiones▸
 Apps AI
 Noticias AI
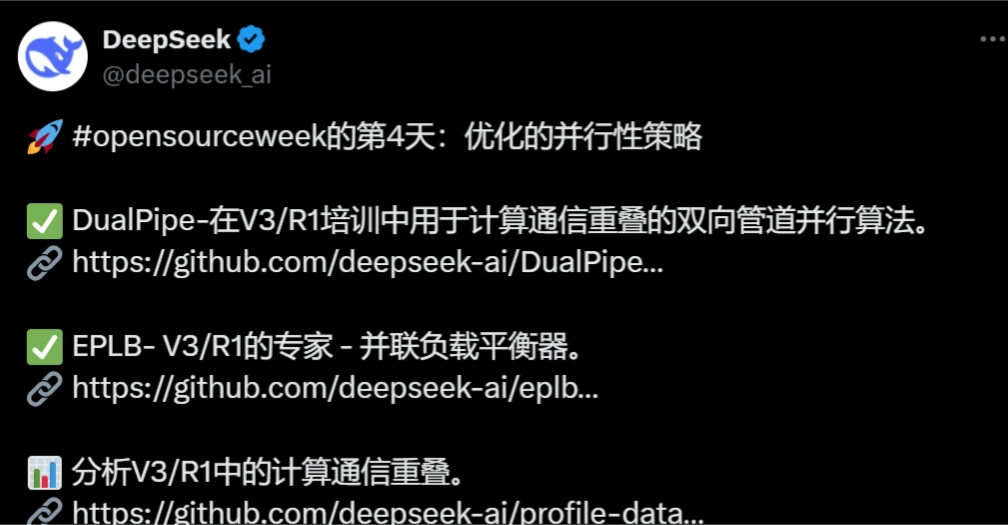
Semana de código abierto de DeepSeek, día 4: DualPipe
小编 ·

Semana de código abierto de DeepSeek, día 4: DualPipe
¿Qué es DualPipe?
DualPipe es un innovador algoritmo de paralelismo por pipeline bidireccional, presentado por primera vez en el informe técnico de DeepSeek-V3. Mediante la superposición completa de las fases de cálculo y comunicación en los procesos de forward y backward, mejora significativamente la eficiencia y la utilización de recursos del entrenamiento de modelos a gran escala, al mismo tiempo que reduce eficazmente el fenómeno de "burbujas" en el pipeline.
Descripción general de DualPipe
DualPipe es un innovador algoritmo de paralelismo por pipeline bidireccional, presentado por primera vez en el informe técnico de DeepSeek-V3. Mediante la superposición completa de las fases de cálculo y comunicación en los procesos de forward y backward, mejora significativamente la eficiencia y la utilización de recursos del entrenamiento de modelos a gran escala, al mismo tiempo que reduce eficazmente el fenómeno de "burbujas" en el pipeline.
Innovaciones principales de DualPipe
Superposición de cálculo y comunicación
El núcleo de DualPipe reside en la programación bidireccional de los datos de micro-lotes, lo que permite la superposición completa del cálculo y la comunicación en los procesos de forward y backward. Este diseño garantiza que los recursos de cálculo no queden inactivos mientras esperan a que finalice la comunicación, aumentando así considerablemente la utilización de la GPU.
Reducción de burbujas en el pipeline
Los métodos tradicionales de paralelismo por pipeline (como 1F1B y ZB1P), al manejar modelos a gran escala, suelen generar cuellos de botella de eficiencia debido a la separación de las fases de cálculo y comunicación. DualPipe reduce eficazmente el fenómeno de burbujas en el pipeline mediante la optimización de la disposición de los módulos funcionales y la regulación precisa de la proporción de asignación de recursos de la GPU.
Optimización del uso de memoria
Aunque DualPipe requiere mantener dos copias de los parámetros del modelo, esta redundancia no supone un aumento significativo de la sobrecarga de memoria, ya que el proceso de entrenamiento utiliza una acumulación de gradientes a gran escala (EP). Además, su memoria activa máxima solo se incrementa en un factor de 2, siendo más eficiente en comparación con los métodos tradicionales.
Detalles de implementación de DualPipe
División de módulos funcionales
Cada bloque de cálculo se divide en cuatro módulos funcionales: mecanismo de atención, distribución de datos a todos los nodos, procesamiento MLP e integración de datos de todos los nodos. En los bloques de cálculo del backward, los módulos de atención y MLP se subdividen a su vez en dos partes: cálculo del gradiente de entrada y cálculo del gradiente de los pesos.
Mecanismo de programación
DualPipe adopta una innovadora estrategia de programación de pipeline bidireccional, que permite introducir los datos de micro-lotes simultáneamente desde ambos extremos del pipeline. Este diseño garantiza que, incluso si el tamaño del modelo sigue aumentando, siempre que se mantenga una proporción adecuada entre cálculo y comunicación, se pueda lograr una asignación de expertos con granularidad fina entre nodos, reduciendo a casi cero la sobrecarga de comunicación entre todos los nodos.
Comparación de rendimiento
En comparación con los métodos tradicionales 1F1B y ZB1P, DualPipe destaca por reducir el bloqueo del pipeline y el uso de memoria. Su tiempo de "burbuja" se reduce significativamente, mientras que el pico de memoria activa solo aumenta ligeramente. Esta eficiente forma de programación concede a DualPipe una notable ventaja de rendimiento en escenarios de paralelismo a gran escala.
Perspectivas de aplicación de DualPipe
La aparición de DualPipe proporciona una herramienta eficiente y viable de entrenamiento paralelo para el entrenamiento de modelos a gran escala. Tanto en la investigación académica como en las aplicaciones industriales, esta tecnología promete impulsar un mayor desarrollo en el campo del entrenamiento de IA.
Repositorio de DualPipe en GitHub:https://github.com/deepseek-ai/DualPipe
Repaso de los proyectos de código abierto de los tres primeros días
FlashMLA: núcleos de decodificación eficientes para GPU NVIDIA Hopper, que optimizan el rendimiento de la Atención Latente Multi-cabezal (MLA) y mejoran significativamente la velocidad de respuesta de las herramientas de IA en la creación de contenidos.
DeepeEP: la primera biblioteca de comunicación de código abierto para el entrenamiento e inferencia de modelos Mixture of Experts (MoE), que optimiza la eficiencia de la comunicación en el entrenamiento distribuido a gran escala y reduce la latencia.
DeepGEMM: una biblioteca de cálculo FP8 compatible con modelos densos y MoE, diseñada específicamente para GPU con arquitectura NVIDIA Hopper, que mejora significativamente la eficiencia de cálculo y la utilización del hardware.









