
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
DeepSeek Open-Source-Woche Tag 6: DeepSeek-V3/R1-Inferenzsystem mit 545 % Kostenmarge
小编 ·

DeepSeek Open-Source-Woche Tag 6: DeepSeek-V3/R1-Inferenzsystem mit 545 % Kostenmarge
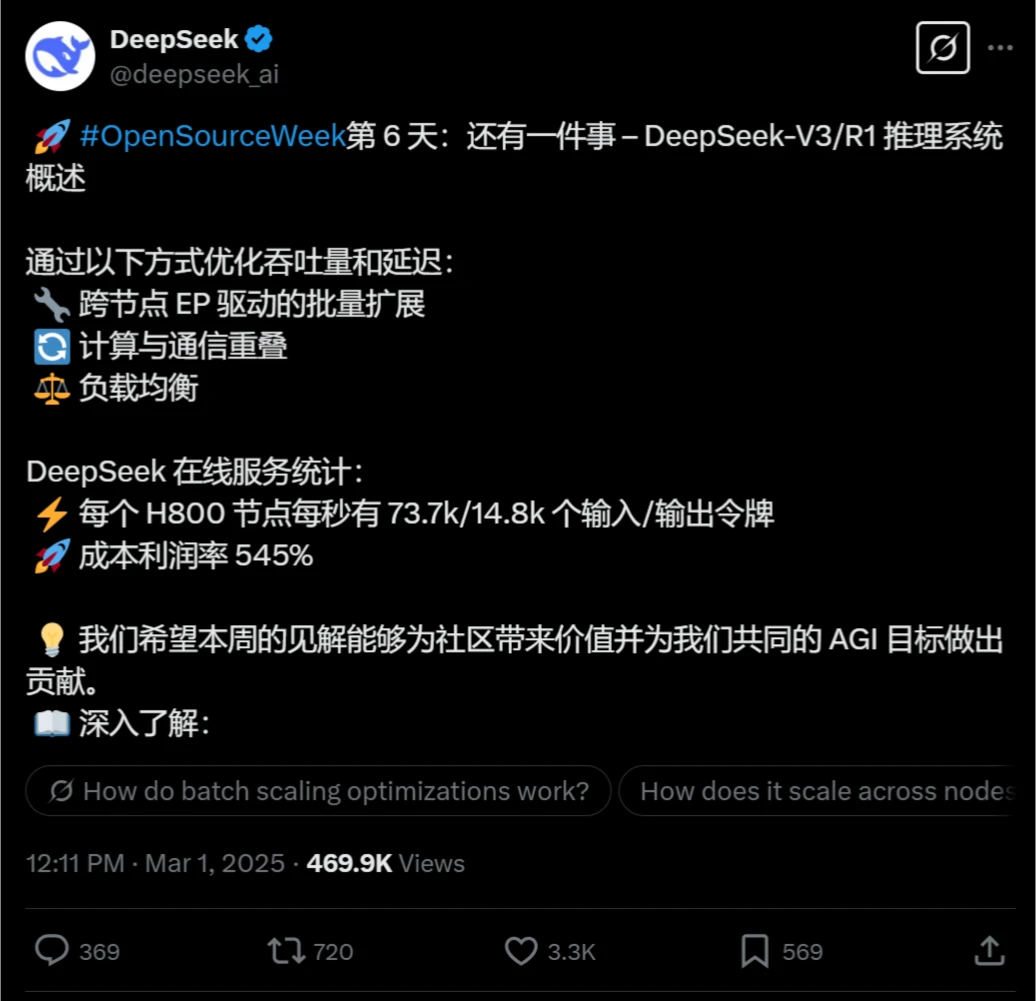
Die angekündigte 5-tägige Open-Source-Woche hat noch ein Überraschungsgeschenk am Samstag parat – das DeepSeek-V3/R1 Inferenzsystem.
Was ist das DeepSeek-V3/R1 Inferenzsystem?
Das DeepSeek-V3/R1 Inferenzsystem ist ein von DeepSeek neu eingeführtes Hochleistungs-Inferenzsystem, das darauf abzielt, die Inferenzeffizienz durch Optimierung von Durchsatz und Latenz zu steigern. Das System setzt大规模跨节点专家并行(Expert Parallelism, EP)-Technik auf großer Knotenebene ein, wodurch die Effizienz der GPU-Matrixberechnung erheblich verbessert und die Latenz reduziert wird, indem Expertenmodule auf verschiedene GPUs verteilt werden.
Hauptmerkmale
Optimierung für hohen Durchsatz und niedrige Latenz:
Durch die Nutzung der大规模跨节点专家并行(Expert Parallelism, EP)-Technik wird die Batchverarbeitungsgröße deutlich erweitert und die Effizienz der GPU-Matrixberechnung verbessert.
Durch die Prefill-Dekodierung-Entkopplungsarchitektur werden in der Prefill- und Dekodierungsphase unterschiedlich starke Parallelitätsstrategien eingesetzt.
Intelligenter Lastausgleich:
In der Prefill- und Dekodierungsphase wird ein Ausgleich der Kernaufmerksamkeitsberechnung und der Verteilungs-/Sendelast erreicht.
计算-通信重叠处理:
采用dual-batch重叠策略,将同一批请求分割为两个microbatch,以隐藏通信成本并提高整体吞吐量。
在解码阶段,采用五阶段流水线技术,实现计算与通信的无缝重叠。
大规模跨节点专家并行(EP):
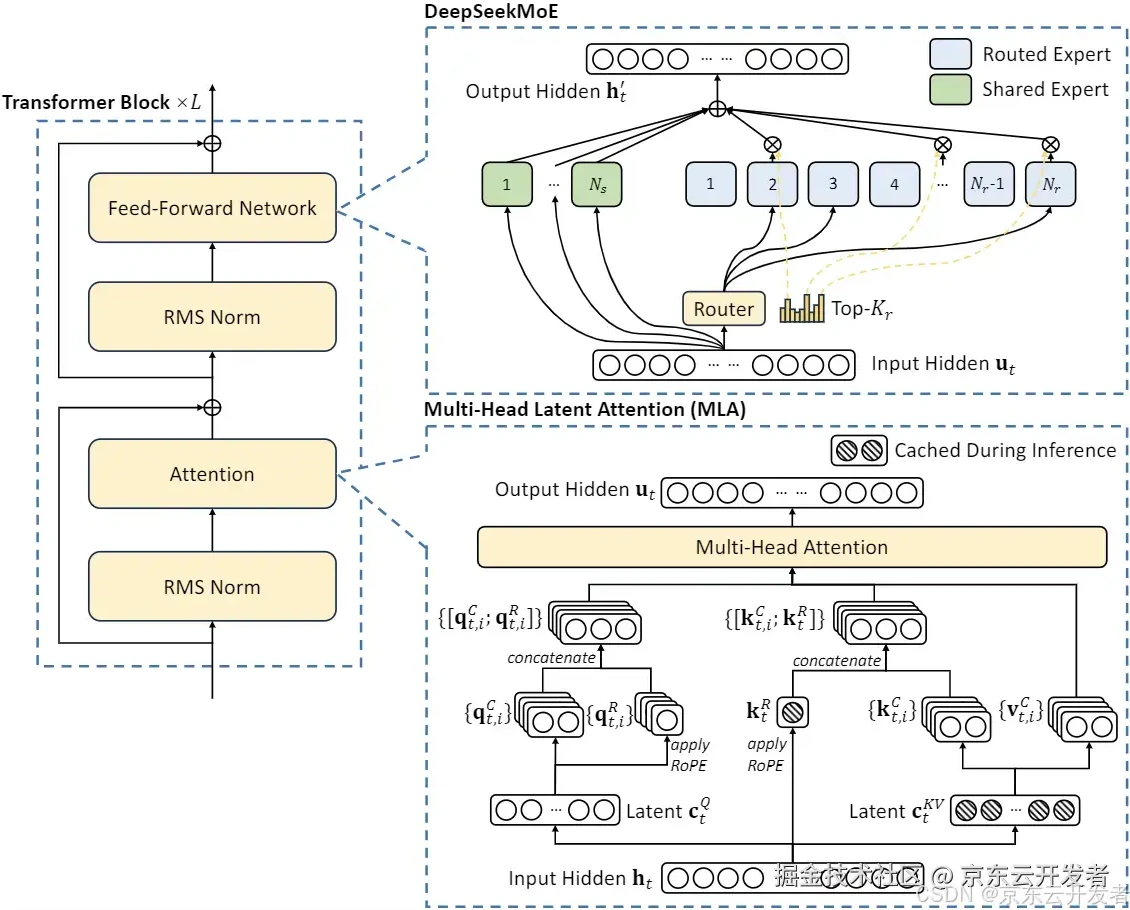
每层256个专家中仅激活8个,模型的高稀疏性特点要求采用极大的整体批处理规模。
预填充阶段采用路由专家EP32和MLA/共享专家DP32,解码阶段采用路由专家EP144和MLA/共享专家DP144。
高效资源利用:
在白天高峰时段,所有节点都部署推理服务;在夜间低负载时段,减少推理节点并将资源分配给研究和训练。
关键技术
跨节点专家并行(EP):DeepSeek-V3/R1模型能够激活大量的专家网络,但每层仅激活256个专家中的8个,生成高度稀疏的计算结构。
负载平衡:系统设计确保各个节点间的计算负载均匀,从而能够有效利用全部资源。
成本和利润率:根据模型的最新评估,假设GPU租赁成本为每小时2美元,总成本为每天87072美元,而理论上的一天总收入可达562027美元,成本利润率高达545%
Anwendungen
Online-Inferenzdienste:
Alle DeepSeek-V3/R1-Inferenzdienste laufen auf H800 GPUs, wobei die Genauigkeit mit dem Training übereinstimmt.
Es werden Online-Inferenzdienste mit hohem Durchsatz und niedriger Latenz bereitgestellt, die für alle Benutzeranfragen über Web, APP und API geeignet sind.
Kommerzielle und nicht-kommerzielle Dienste:
Einige Dienste sind kommerzialisiert, der Zugriff über Web und APP bleibt weiterhin kostenlos.
In Nebenzeiten werden automatisch Nachtrabatte angewendet, um die Ressourcennutzung und Kosteneffizienz zu optimieren.
Statistische Daten
In den letzten 24 Stunden erreichte die kombinierte Spitzenknotenauslastung der V3- und R1-Inferenzdienste 278 Knoten, mit einer durchschnittlichen Auslastung von 226,75 Knoten (jeder Knoten enthält 8 H800 GPUs).
Jeder H800-Knoten liefert in der Prefill-Phase einen durchschnittlichen Eingabedurchsatz von etwa 73.700 Token/s oder in der Dekodierungsphase einen Ausgabedurchsatz von etwa 14.800 Token/s.
Wenn alle Token zu den DeepSeek-R1-Preisen abgerechnet würden, würde der tägliche Gesamtumsatz 562.027 US-Dollar betragen, mit einer Gewinnmarge von 545 %.
Rückblick auf die Open-Source-Projekte der ersten fünf Tage
Tag 1: FlashMLA, ein effizienter Dekodierungskernel für NVIDIA Hopper GPUs, der die Leistung der Multi-Head Latent Attention (MLA) optimiert und die Reaktionsgeschwindigkeit von KI-Tools in der Content-Erstellung deutlich verbessert.
Tag 2: DeepeEP, die erste Open-Source-Kommunikationsbibliothek für Training und Inferenz von Mixture-of-Experts-Modellen (MoE), die die Kommunikationseffizienz beim verteilten Training in großem Maßstab optimiert und die Latenz reduziert.
Tag 3: DeepGEMM, eine FP8-Bibliothek für dichte und MoE-Modelle, die speziell für GPUs mit NVIDIA Hopper-Architektur entwickelt wurde und die Recheneffizienz sowie Hardwareauslastung deutlich steigert.
Tag 4: DualPipe, ein bidirektionaler Pipeline-Parallelitätsalgorithmus zur Optimierung der Überlappung von Berechnung und Kommunikation beim Training der V3/R1-Modelle. EPLB, ein Experten-Parallel-Lastbalancierer, der speziell zur Lösung des Problems der unausgeglichenen Lastverteilung bei Experten-Parallel-Aufgaben in großskaligen KI-Modellen entwickelt wurde.
Tag 5: 3FS, ein Hochleistungs-verteiltes Dateisystem.









