
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
FlashMLA: DeepSeeks effizienter MLA-Decoding-Kernel, optimiert für Sequenzen variabler Länge
小编 ·

FlashMLA: DeepSeeks effizienter MLA-Decoding-Kernel, optimiert für Sequenzen variabler Länge
Was ist FlashMLA?
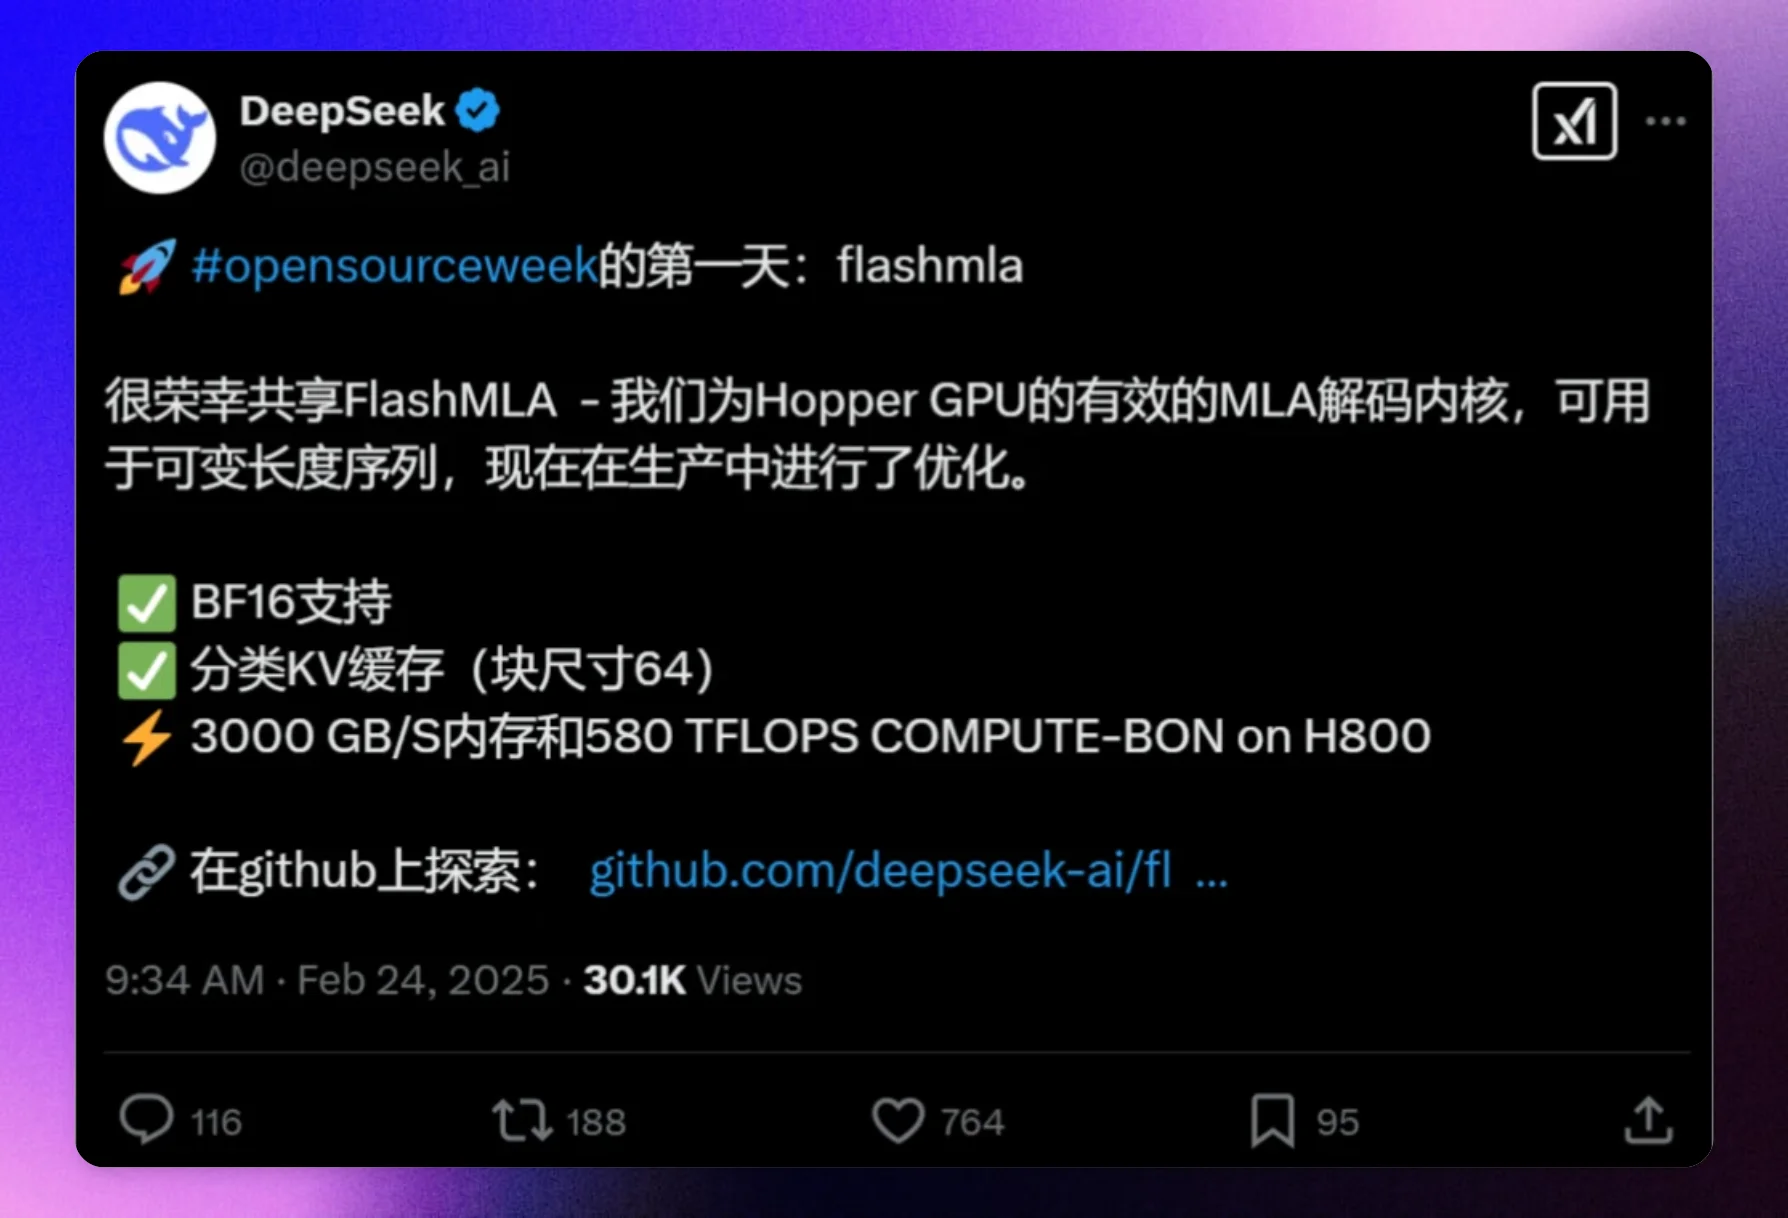
FlashMLA ist ein MLA-Decoder-Kernel (Multi-Head Latent Attention), der von DeepSeek am 24. Februar 2025 veröffentlicht wurde und speziell für NVIDIA Hopper-Architektur-GPUs (wie H800) optimiert ist, mit besonderer Optimierung für die Verarbeitung von Sequenzen variabler Länge.
Hauptmerkmale von FlashMLA:
BF16-Unterstützung: FlashMLA unterstützt den Datentyp BF16 (Bfloat16), was es in Bezug auf Berechnung und Speichernutzung effizienter macht.
Paginierten KV-Cache: Verwaltet den Key-Value-Cache (KV) durch einen Paginierungsmechanismus mit einer Blockgröße von 64, wodurch große Sequenzen effizient verarbeitet werden können.
Hohe Leistung: FlashMLA erreicht eine Speicherbandbreite von bis zu 3000 GB/s (in speichergebundenen Szenarien) und eine Rechenleistung von bis zu 580 TFLOPS (in rechengebundenen Szenarien, basierend auf dem BF16-Datentyp).
Technischer Hintergrund von FlashMLA:
FlashMLA wurde entwickelt, um die Rechen- und Speicherengpässe zu lösen, mit denen große Sprachmodelle während der Inferenz konfrontiert sind. Der herkömmliche Multi-Head-Attention-Mechanismus (MHA) benötigt bei der Verarbeitung langer Sequenzen eine große Menge an Speicher zur Speicherung der Key-Value-Paar-Caches (KV), was den Einsatz des Modells auf begrenzten Hardwareressourcen einschränkt. MLA reduziert durch die Einführung eines latenten Aufmerksamkeitsmechanismus die Größe des KV-Caches und erhält gleichzeitig die Modellleistung.
Anwendungsszenarien von FlashMLA:
FlashMLA eignet sich besonders für Aufgaben der natürlichen Sprachverarbeitung (NLP), die eine effiziente Decodierung erfordern, wie z. B. die Inferenz großer Sprachmodelle (LLM). Es ist für Sequenzen variabler Länge optimiert und wurde in realen Produktionsumgebungen validiert, was es besonders für Hochleistungsrechenanforderungen geeignet macht.
Technische Implementierung von FlashMLA
Niedrigrangige Komprimierung: MLA erreicht eine effektive Komprimierung des KV-Caches durch Niedrigrang-Matrixzerlegung, wodurch der Speicherverbrauch reduziert wird.
KV-Cache-Optimierung: Optimiert den KV-Cache-Mechanismus, was den Bedarf an Hardwareressourcen deutlich senkt und somit die Inferenzkosten reduziert.
Parallele Decodierung: Führt einen parallelen Decodierungsmechanismus ein, der die gleichzeitige Verarbeitung mehrerer Tokens ermöglicht und die Inferenzgeschwindigkeit deutlich erhöht.
Leistungssteigerung von FlashMLA
Nach der Einführung von FlashMLA konnte DeepSeek die Genauigkeit bei NLP-Aufgaben um etwa 5 % steigern, die Inferenzgeschwindigkeit um 20 % erhöhen und den Rechenressourcenverbrauch um 15 % senken. Diese Verbesserungen ermöglichen es DeepSeek, in Echtzeit-Interaktionsszenarien (wie Dialog-ai, Echtzeit-Übersetzung) eine bessere Leistung zu erzielen.
Installation und Nutzung von FlashMLA
Umgebungsanforderungen:
GPU mit Hopper-Architektur (z. B. NVIDIA A100)
CUDA 12.3 oder höher
PyTorch 2.0 oder höher
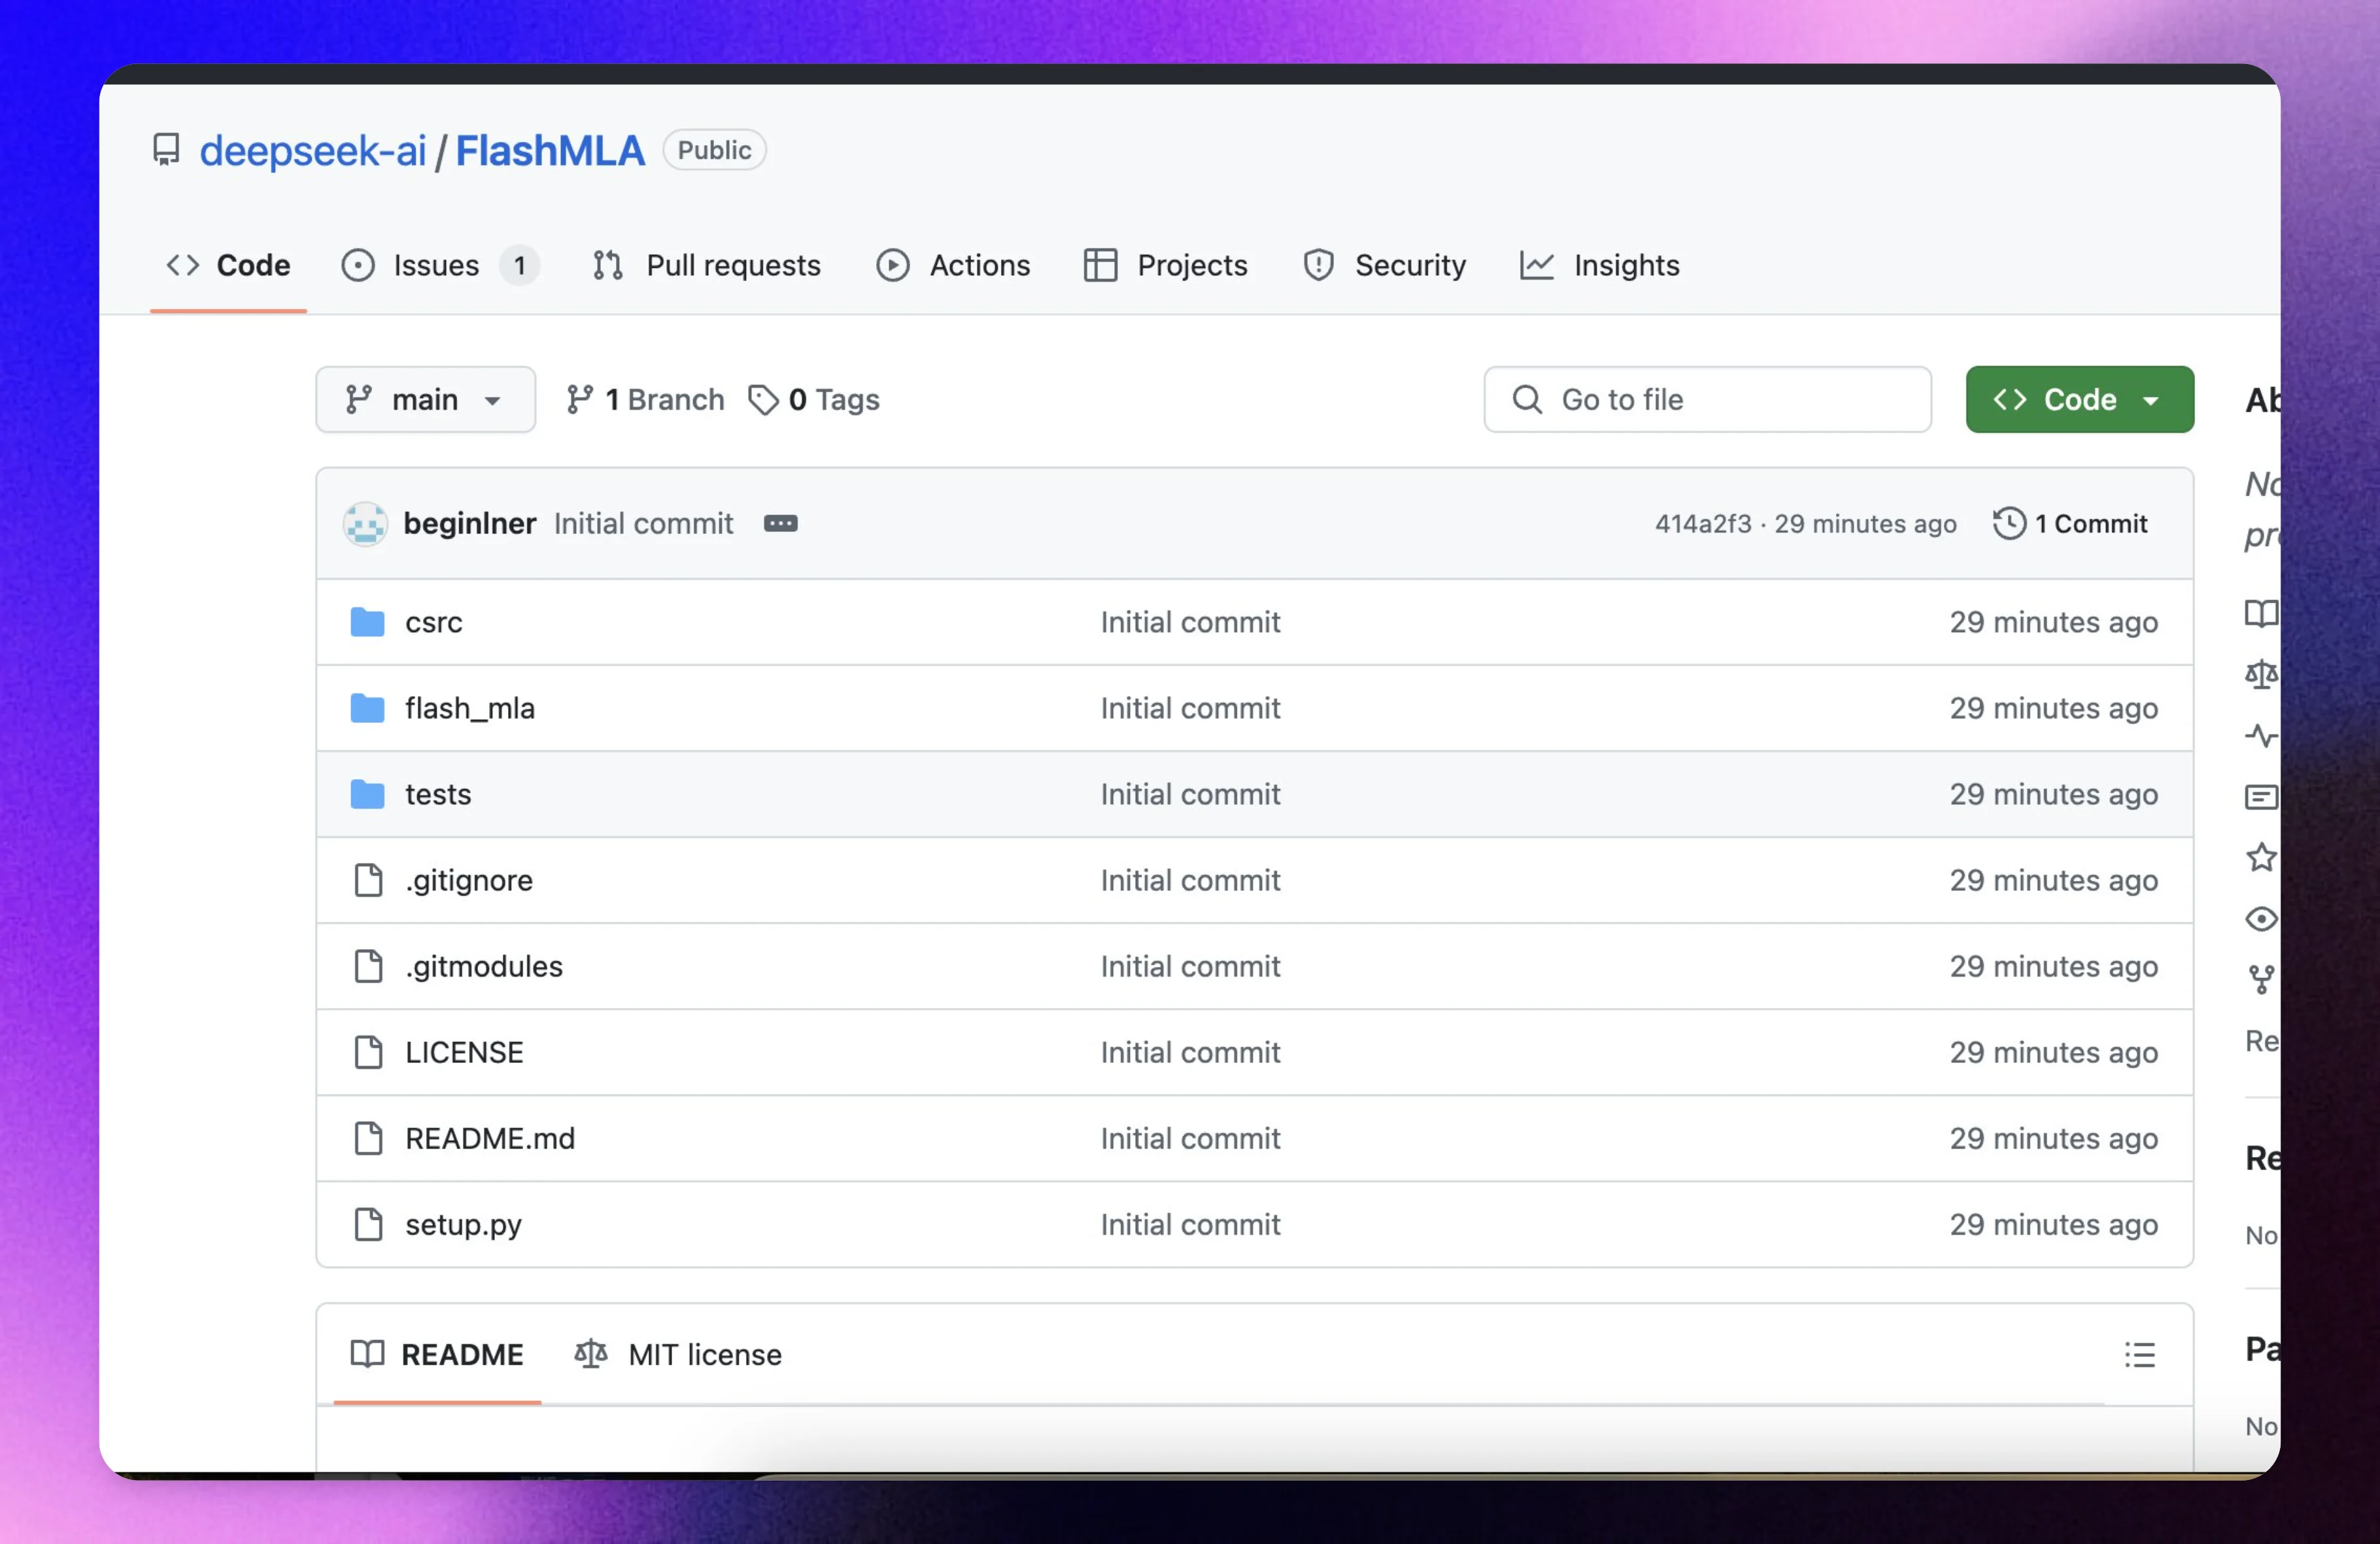
1. Zunächst musst du die FlashMLA-Bibliothek installieren. Du kannst sie mit dem folgenden Befehl installieren:
git clone https://github.com/deepseek-ai/FlashMLA.git
cd FlashMLA
python setup.py install
Oder, wenn du das Repository bereits geklont hast und neu erstellen möchtest:
python setup.py clean --all && python setup.py build_ext --inplace
2. MLA-Metadaten abrufen
Bevor du FlashMLA verwendest, musst du die MLA-Metadaten abrufen. Dies beinhaltet normalerweise die Vorbereitung von Eingabetensoren und anderen erforderlichen Parametern.
from flash_mla import get_mla_metadata, flash_mla_with_kvcache

# Angenommen, du hast bereits cache_seqlens und andere relevante Variablen
cache_seqlens = [...]  # Liste der Längen jeder Sequenz
s_q = ...              # Abfragedimension
h_q = ...              # Anzahl der Köpfe
h_kv = ...             # Anzahl der Key-Value-Köpfe

tile_scheduler_metadata, num_splits = get_mla_metadata(cache_seqlens, s_q * h_q // h_kv, h_kv)
3. MLA-Decodierung ausführen
Anschließend kannst du die MLA-Decodierungsoperation ausführen. Es wird davon ausgegangen, dass du bereits die notwendigen Komponenten wie die Abfragematrix q_i, den Key-Value-Cache kvcache_i, die Blocktabelle block_table usw. hast.
dv = ...               # Ausgabedimension

for i in range(num_layers):  # Schleife über jede Schicht
    o_i, lse_i = flash_mla_with_kvcache(
        q_i[i],                # Abfragematrix der aktuellen Schicht
        kvcache_i[i],           # Key-Value-Cache der aktuellen Schicht
        block_table,            # Blocktabelle
        cache_seqlens,          # Cache-Sequenzlängen
        dv,                     # Ausgabedimension
        tile_scheduler_metadata,# MLA-Metadaten
        num_splits,             # Anzahl der Aufteilungen
        causal=True             # Kausale Maskierung ja/nein
    )
    # Verarbeite die Ausgabewerte o_i und lse_i weiter
FlashMLA GitHub:https://github.com/deepseek-ai/FlashMLA









