
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
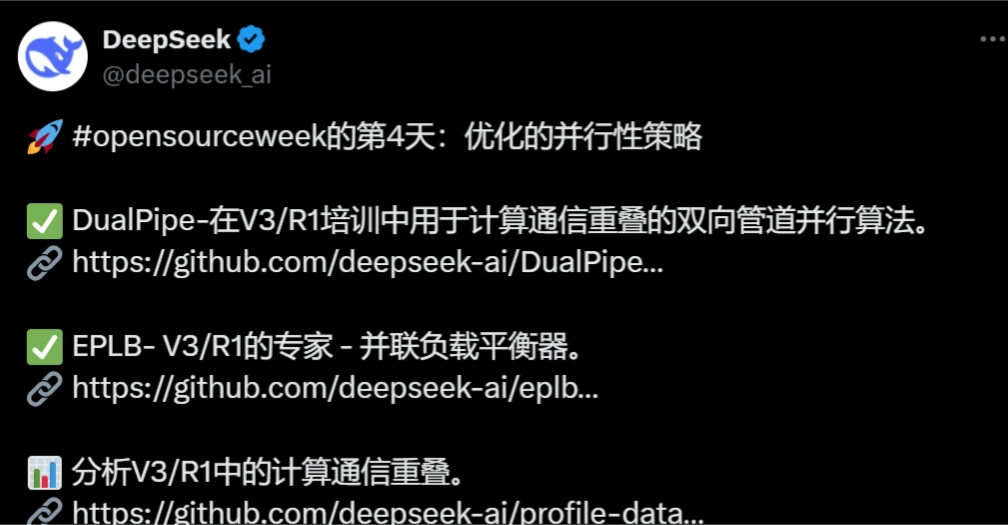
DeepSeek Open-Source-Woche, Tag 4: DualPipe
小编 ·

DeepSeek Open-Source-Woche, Tag 4: DualPipe
Was ist DualPipe?
DualPipe ist ein innovativer bidirektionaler Pipeline-Parallelalgorithmus, der erstmals im technischen Bericht von DeepSeek-V3 vorgestellt wurde. Durch die vollständige Überlappung von Vorwärts- und Rückwärtsberechnungen mit den Kommunikationsphasen verbessert er signifikant die Effizienz und Ressourcennutzung beim Training großer Modelle und reduziert gleichzeitig effektiv das Auftreten von „Bubbles“ in der Pipeline.
Überblick über DualPipe
DualPipe ist ein innovativer bidirektionaler Pipeline-Parallelalgorithmus, der erstmals im technischen Bericht von DeepSeek-V3 vorgestellt wurde. Durch die vollständige Überlappung von Vorwärts- und Rückwärtsberechnungen mit den Kommunikationsphasen verbessert er signifikant die Effizienz und Ressourcennutzung beim Training großer Modelle und reduziert gleichzeitig effektiv das Auftreten von „Bubbles“ in der Pipeline.
Kerninnovationen von DualPipe
Überlappung von Berechnung und Kommunikation
Der Kern von DualPipe liegt in der bidirektionalen Steuerung von Mikrobatches, die eine vollständige Überlappung von Vorwärts- und Rückwärtsberechnungen mit der Kommunikation erreicht. Dieses Design stellt sicher, dass Rechenressourcen nicht im Leerlauf verharren, während sie auf den Abschluss der Kommunikation warten, wodurch die GPU-Auslastung erheblich gesteigert wird.
Reduzierung von Pipeline-Bubbles
Herkömmliche Pipeline-Parallelmethoden (wie 1F1B und ZB1P) stoßen bei der Verarbeitung großer Modelle häufig aufgrund der Trennung von Berechnungs- und Kommunikationsphasen auf Effizienzengpässe. DualPipe reduziert Bubble-Phänomene in der Pipeline effektiv, indem es die Anordnung der Funktionsmodule optimiert und die GPU-Ressourcenzuteilung präzise steuert.
Optimierung der Speichernutzung
Obwohl DualPipe zwei Kopien der Modellparameter vorhalten muss, führt diese Redundanz aufgrund der im Trainingsprozess eingesetzten umfangreichen Gradientenakkumulation (EP) nicht zu einem signifikanten Anstieg des Speicherverbrauchs. Darüber hinaus steigt der Spitzenwert des aktiven Speichers nur um das 2-fache, was im Vergleich zu herkömmlichen Methoden effizienter ist.
Implementierungsdetails von DualPipe
Aufteilung der Funktionsmodule
Jeder Berechnungsblock ist in vier Funktionsmodule unterteilt: Aufmerksamkeitsmechanismus, All-to-All-Datenverteilung, MLP-Verarbeitung und All-to-All-Datenaggregation. In den Rückwärts-Berechnungsblöcken werden die Aufmerksamkeits- und MLP-Module zusätzlich in zwei Teile unterteilt: Eingabegradientenberechnung und Gewichtsgradientenberechnung.
Steuerungsmechanismus
DualPipe verwendet eine innovative bidirektionale Pipeline-Steuerungsstrategie, die den gleichzeitigen Eingang von Mikrobatches von beiden Enden der Pipeline ermöglicht. Dieses Design stellt sicher, dass auch bei weiter wachsender Modellgröße durch die Aufrechterhaltung eines angemessenen Verhältnisses von Berechnung zu Kommunikation eine feinkörnige Expertenverteilung zwischen den Knoten erreicht werden kann, während der All-to-All-Kommunikationsaufwand nahezu auf Null reduziert wird.
Leistungsvergleich
Im Vergleich zu herkömmlichen 1F1B- und ZB1P-Methoden schneidet DualPipe sowohl bei der Reduzierung von Pipeline-Blockaden als auch bei der Speichernutzung hervorragend ab. Die „Bubble“-Zeit wird deutlich reduziert, während der Spitzenwert des aktiven Speichers nur leicht ansteigt. Diese effiziente Steuerung verleiht DualPipe in großskaligen Parallelszenarien signifikante Leistungsvorteile.
Anwendungsperspektiven von DualPipe
Das Erscheinen von DualPipe bietet eine effiziente und praktikable Lösung für das parallele Training von Werkzeugen für das Training großer Modelle. Sowohl in der akademischen Forschung als auch in industriellen Anwendungen dürfte diese Technologie die Weiterentwicklung des KI-Trainingsbereichs vorantreiben.
DualPipe GitHub-Adresse:https://github.com/deepseek-ai/DualPipe
Rückblick auf die Open-Source-Projekte der ersten drei Tage
FlashMLA: Ein hocheffizienter Dekodierungs-Kernel für NVIDIA Hopper GPUs, der die Leistung der Multi-Head Latent Attention (MLA) optimiert und die Reaktionsgeschwindigkeit von KI-Tools in der Inhaltserstellung deutlich verbessert.
DeepeEP: Die erste Open-Source-Kommunikationsbibliothek für Training und Inferenz von Mixture-of-Experts-Modellen (MoE), die die Kommunikationseffizienz beim verteilten Training im großen Maßstab optimiert und die Latenz reduziert.
DeepGEMM: Eine FP8-Berechnungsbibliothek für dichte und MoE-Modelle, die speziell für GPUs mit NVIDIA Hopper-Architektur entwickelt wurde und die Berechnungseffizienz sowie Hardwareauslastung deutlich steigert.









