
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
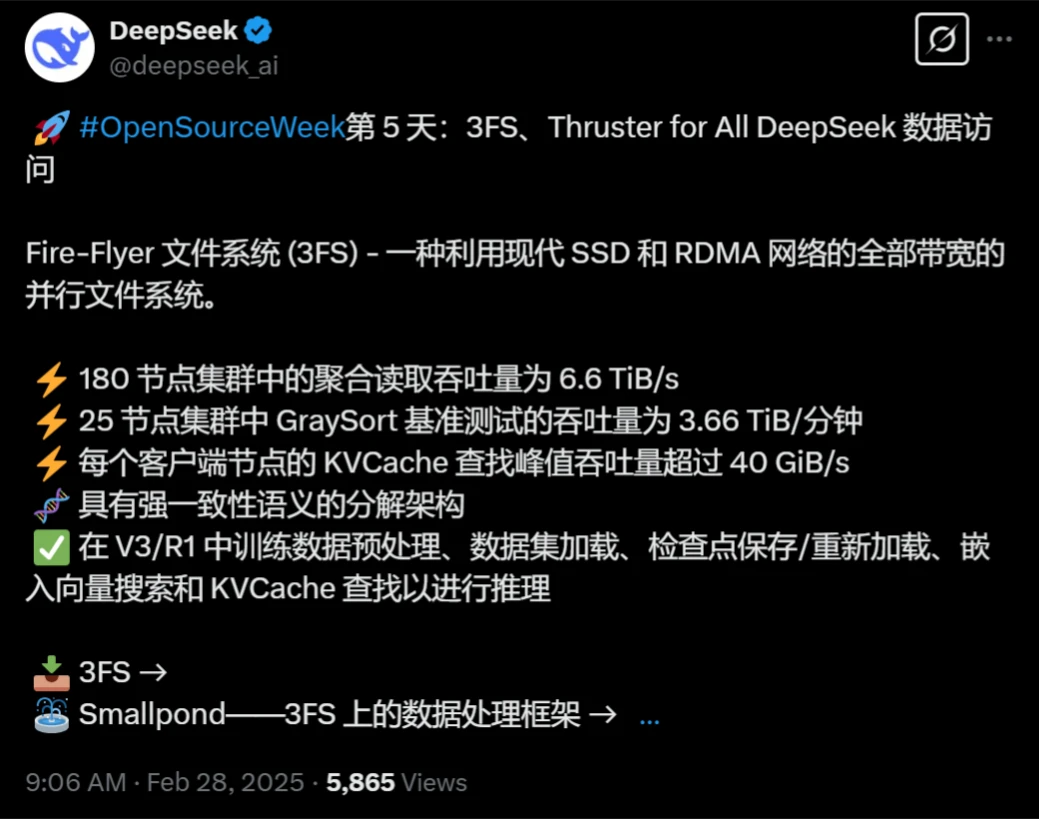
DeepSeek Open-Source-Woche, Tag 5: 3FS, ein hochleistungsfähiges verteiltes Dateisystem
小编 ·

DeepSeek Open-Source-Woche, Tag 5: 3FS, ein hochleistungsfähiges verteiltes Dateisystem
Während auf der einen Seite gerade GPT4.5 veröffentlicht wurde, erreicht die Open-Source-Woche von DeepSeek ihren fünften Tag. Das am letzten Tag veröffentlichte Open-Source-Projekt ist: 3FS (Fire-Flyer File System).
Was ist 3FS (Fire-Flyer File System)?
3FS (Fire-Flyer File System) ist ein von DeepSeek selbst entwickeltes hochleistungsfähiges verteiltes Dateisystem, das speziell dafür konzipiert wurde, die Herausforderungen von KI-Trainings- und Inferenz-Workloads zu bewältigen.
Merkmale von 3FS
Hohe Leistung:
Nutzt moderne SSDs und RDMA-Netzwerke, um hohen Durchsatz und geringe Latenz beim Datenzugriff zu bieten.
Kombiniert den Durchsatz von Tausenden von SSDs mit der Netzwerkbandbreite Hunderter Speicherknoten, sodass Anwendungen standortunabhängig auf Speicherressourcen zugreifen können.
Starke Konsistenz:
Durch die Implementierung von Chained Replication with Apportioned Queries (CRAQ) wird starke Konsistenz sichergestellt, was den Anwendungscode einfacher und leichter nachvollziehbar macht.
Dateischnittstelle:
Verwendet einen zustandslosen Metadatendienst, der durch transaktionale Schlüssel-Wert-Speicher (wie FoundationDB) unterstützt wird.
Vertraute Dateischnittstelle, keine Notwendigkeit, neue Speicher-APIs zu erlernen.
Unterstützung vielfältiger Workloads:
Datenaufbereitung: Organisiert die Ausgabe von Datenanalyse-Pipelines in hierarchische Verzeichnisstrukturen und verwaltet effektiv große Mengen an Zwischenergebnissen.
Data Loader: Eliminiert die Notwendigkeit von Prefetching oder Daten-Shuffling, indem wahlfreier Zugriff auf Trainingssamples über Rechenknoten hinweg unterstützt wird.
Checkpoints: Unterstützt hochdurchsatzfähige parallele Checkpoints für groß angelegtes Training.
Inferenz-KV-Cache: Bietet eine kosteneffiziente Alternative zu DRAM-Caches, mit höherem Durchsatz und deutlich gesteigerter Kapazität.
Trennung von Speicher und Rechenleistung:
Der Datenspeicherdienst ist von den Rechenknoten getrennt und speziell für die Speicherung der für das Modelltraining benötigten Beispieldaten vorgesehen.
Jeder Speicherdienstknoten verfügt über 16 SSDs mit jeweils 15 TB und 2 Hochgeschwindigkeits-Netzwerkkarten, was eine starke Leseleistung und hohe Netzwerkbandbreite bietet, mit einer Lese-/Schreibbandbreite von 7,0 TB/s.
Selbst entwickelte Kommunikations-Tools:
Wie z. B. hfreduce, das die Multi-GPU-parallele Kommunikation optimiert, NVIDIAs NCCL ersetzt und den PCIe-Datenverkehr sowie den Rechenaufwand reduziert.
Spezielles Datenformat FFRecord:
Durch das Zusammenführen vieler kleiner Dateien wird der Overhead beim Öffnen zahlreicher kleiner Dateien während des Trainings reduziert.
Verbessert die Leistung bei zufälligen Batch-Lesezugriffen durch Offsets in den Beispieldateien.
Anwendungen von 3FS
KI-Training und Inferenz:
3FS ist speziell für KI-Trainings- und Inferenz-Workloads konzipiert und kann die Effizienz dieser Aufgaben deutlich steigern.
Durch hohe Leistung und starke Konsistenz unterstützt 3FS das Training großer Modelle sowie Inferenz mit hohem Durchsatz.
Datenaufbereitung und Laden:
Die Datenaufbereitungs- und Loader-Funktionen von 3FS ermöglichen eine effizientere Verarbeitung großer Datenmengen und reduzieren die Notwendigkeit von Prefetching und Daten-Shuffling.
Checkpoints und Inferenz-Cache:
3FS unterstützt parallele Checkpoints mit hohem Durchsatz und gewährleistet so Stabilität und Fehlertoleranz während des Trainings.
Der Inferenz-KV-Cache bietet eine kosteneffiziente Alternative, die den Inferenzdurchsatz und die Kapazität erhöht.
Verwendung von 3FS
Installation und Konfiguration:
3FS kann über das Open-Source-Projekt auf GitHub installiert und konfiguriert werden.
Datenformatkonvertierung:
Für die Datenspeicherung und das Laden mit dem FFRecord-Format müssen die Beispieldaten in das FFRecord-Format konvertiert werden.
Es wird ein FFRecord-Konvertierungstool bereitgestellt, das Benutzern die Datenformatkonvertierung erleichtert.
Integration mit PyTorch:
3FS ist an die Dataset- und Dataloader-Schnittstellen von PyTorch angepasst, sodass Daten sehr bequem geladen und Trainings gestartet werden können.
GitHub-Projekt-Adresse:https://github.com/deepseek-ai/3FS
Rückblick auf die Open-Source-Projekte der ersten vier Tage
Erster Tag: FlashMLA, ein hocheffizienter Decodierungs-Kernel für NVIDIA Hopper GPUs, der die Leistung der Multi-Head Latent Attention (MLA) optimiert und die Reaktionsgeschwindigkeit von KI-Tools bei der Inhaltserstellung deutlich verbessert.
Zweiter Tag: DeepeEP, die erste Open-Source-Kommunikationsbibliothek für das Training und die Inferenz von Mixture-of-Experts-Modellen (MoE), die die Kommunikationseffizienz beim verteilten Training in großem Maßstab optimiert und die Latenz reduziert.
Dritter Tag: DeepGEMM, eine FP8-Bibliothek für dichte und MoE-Modelle, die speziell für NVIDIA Hopper-Architektur-GPUs entwickelt wurde und die Rechenleistung sowie Hardwareauslastung deutlich verbessert.
Vierter Tag: DualPipe, ein bidirektionaler Pipeline-Parallelitätsalgorithmus, der darauf abzielt, die Überlappung von Berechnung und Kommunikation beim Training der Modelle V3/R1 zu optimieren, sowie EPLB, ein Expert-Parallelism Load Balancer, der speziell zur Lösung des Problems der Lastunausgewogenheit bei Expert-Parallel-Aufgaben in groß angelegten KI-Modellen entwickelt wurde.









