
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten

IndexTTS: TTS-Modell von Bilibili auf Basis von XTTS und Tortoise
IndexTTS: TTS-Modell von Bilibili auf Basis von XTTS und TortoiseEinführung
IndexTTS ist ein auf XTTS und Tortoise basierendes Text-zu-Sprache-Modell, das von Bilibili entwickelt wurde und über TTS-Fähigkeiten auf Industrieniveau mit Zero-Shot verfügt. Für chinesische Szenarien wird innovativ eine Zeichen-Pinyin-Mischmodellierung eingesetzt, um Aussprachefehler schnell zu korrigieren. In Kombination mit dem Conformer-Bedingungscodierer und dem BigVGAN2-Decoder werden die Trainingsstabilität, die Klangfarbenwiedergabe und die Ausgabeaudioqualität verbessert.
Kernfunktionen:
✅ Unterstützt Chinesisch und Englisch
✅ Chinesische Pinyin-Korrektur: Pinyin-Eingabe zur Anpassung der Aussprache mehrdeutiger Zeichen (z. B. kann „长" als „zhǎng" oder „cháng" angegeben werden)
✅ Steuerung der Pausen durch Zeichensetzung: Steuerung des Sprachpausenrhythmus durch Interpunktion
✅ Klangqualitätsverbesserung: Conformer-Codierer extrahiert Stimmmerkmale, BigVGAN2-Decoder verbessert die Qualität der Wellenformgenerierung
✅ Getrennte Steuerung von Emotion und Stimme: Unabhängige Einstellung von Emotionsausdruck und Sprecherstimme
✅ Präzise Dauersteuerung: Unterstützt zwei Modi – Token-Anzahl festlegen oder autoregressive Generierung
Technische Highlights:
✅ Chinesische Mischmodellierung: Die Eingabeschicht unterstützt gemischte Eingaben aus reinem Text und Pinyin, sagt unmarkierte Pinyins automatisch vorher und reduziert die Wortfehlerrate
✅ Conformer-Codierer: Kombination aus Faltung und Selbstaufmerksamkeit zur Stärkung der Modellierung von Stimmfarbe und Prosodie
✅ BigVGAN2-Decoder: Wellenformgenerator auf GAN-Basis, der Rechenleistung und Audioqualität in Einklang bringt
Hauptvorteile:
✓ Präzise Aussprache mehrdeutiger Zeichen
✓ Natürlicher Pausenrhythmus
✓ Hochwertige Klangqualität
✓ Schnelles Stimmklonen
✓ Unterstützung für Chinesisch und Englisch
Typische Anwendungen:
Die von IndexTTS synthetisierte Sprache klingt natürlich und emotional, menschenähnlich und ist vielseitig einsetzbar – z. B. für intelligente Assistenten | Hörbücher | Videosynchronisation | intelligenter Kundenservice | Bildungs-tools und weitere Szenarien.
Leistung
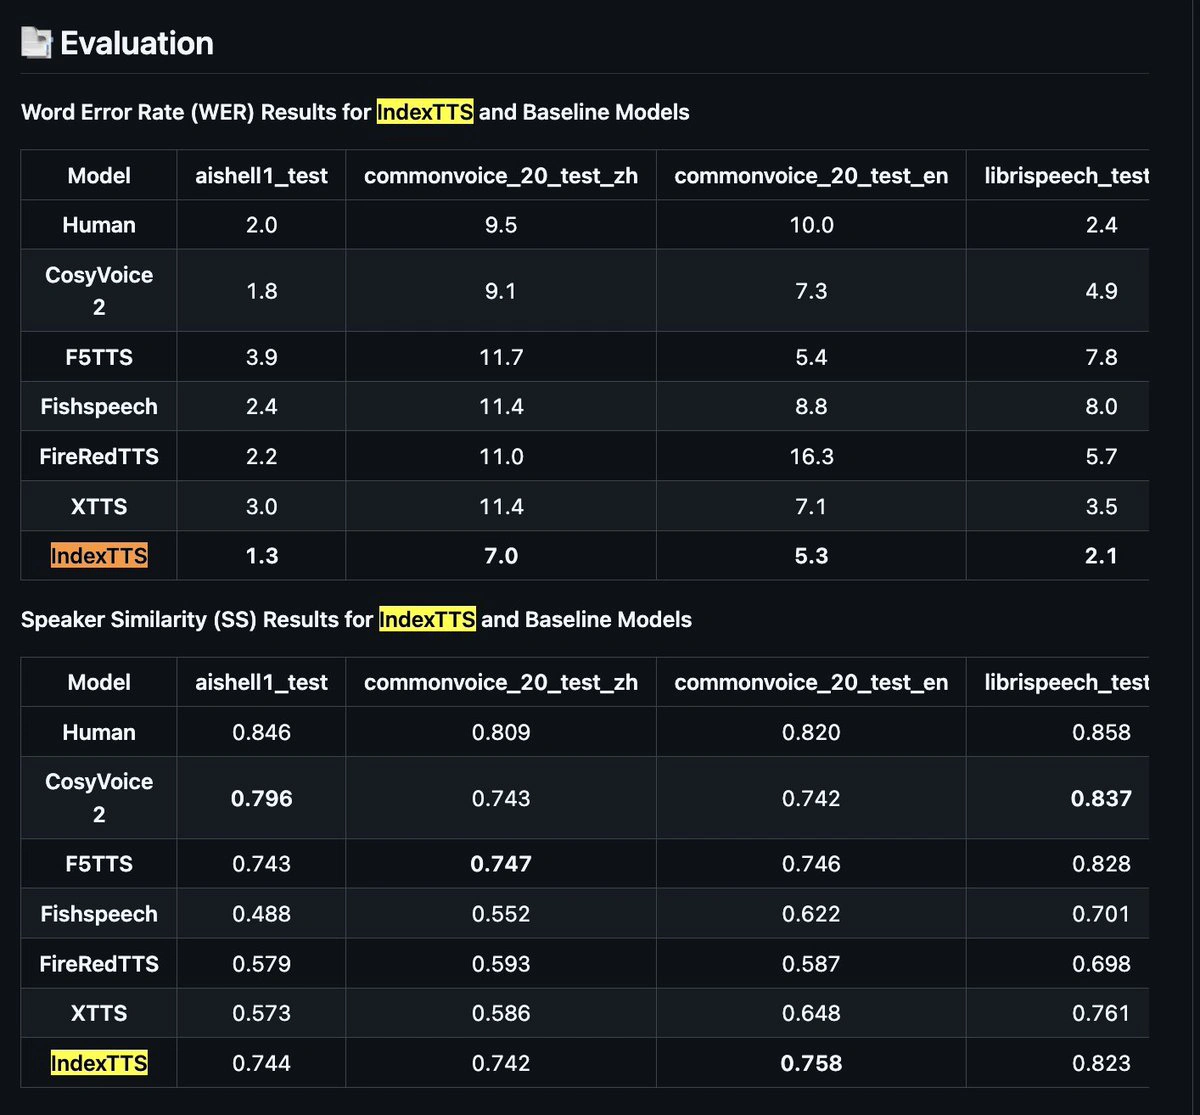
✓ Natürlichkeit und Konsistenz: In Bezug auf Natürlichkeit, inhaltliche Konsistenz und Zero-Shot-Stimmklonen zeigt IndexTTS deutliche Verbesserungen gegenüber bestehenden Modellen wie XTTS.
✓ Trainings- und Inferenz-Effizienz: Der Trainingsprozess ist relativ einfach, die Inferenzgeschwindigkeit höher und die Leistung übertrifft gängige Open-Source-TTS-Systeme wie Fish-Speech, CosyVoice2, FireRedTTS und F5-TTS.
✓ Codebuch-Auslastung: Im Vergleich zu Vektorquantisierung (VQ) und Finite Scalar Quantization (FSQ) wird das Problem des Codebuch-Kollapses gelöst, mit einer Codebuch-Auslastung nahe 100 %.
Bereitstellung:
GitHub-Repository klonen
Abhängigkeiten wie PyTorch installieren
Audiodaten vorbereiten und vorverarbeiten
Training durchführen oder vortrainiertes Modell laden
Parameter anpassen und Audiodateien generieren
Projekt-URL: https://github.com/index-tts/index-tts














