
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Moshi: Open-Source-Echtzeit-Sprachkonverter
Moshi: Open-Source-Echtzeit-SprachkonverterEinführung
Moshi ist ein Transformer-Modell zur Echtzeit-Spracherzeugung mit mehreren Streams, das Vollduplex-Sprachdialoge unterstützt. Zu den Hauptmerkmalen gehören gleichzeitige Spracheingabe und -ausgabe (Vollduplex) sowie die Fähigkeit, komplexe Dialogszenarien zu verarbeiten, einschließlich überlappender Sprache, Unterbrechungen und emotionaler Ausdrücke sowie anderer nonverbaler Informationen.
Dies bedeutet, dass es gleichzeitig hören und sprechen kann und darauf abzielt, einige Probleme herkömmlicher Dialogsysteme zu lösen, wie z. B. Latenz, den Verlust nonverbaler Informationen (z. B. Emotionen) und die unflexible Struktur des Sprechtüchens.
Vollduplex-Kommunikation: Herkömmliche Dialogsysteme sind rundenbasiert (eine Person beendet das Sprechen, bevor die andere beginnt). Moshi durchbricht diese Einschränkung und unterstützt Vollduplex-Kommunikation. Das bedeutet, dass Moshi Sprachantworten generieren kann, während der Benutzer spricht, ohne an Runden gebunden zu sein, und komplexe Dialogdynamiken wie überlappende Sprache, Unterbrechungen und schnelles Feedback verarbeiten kann.
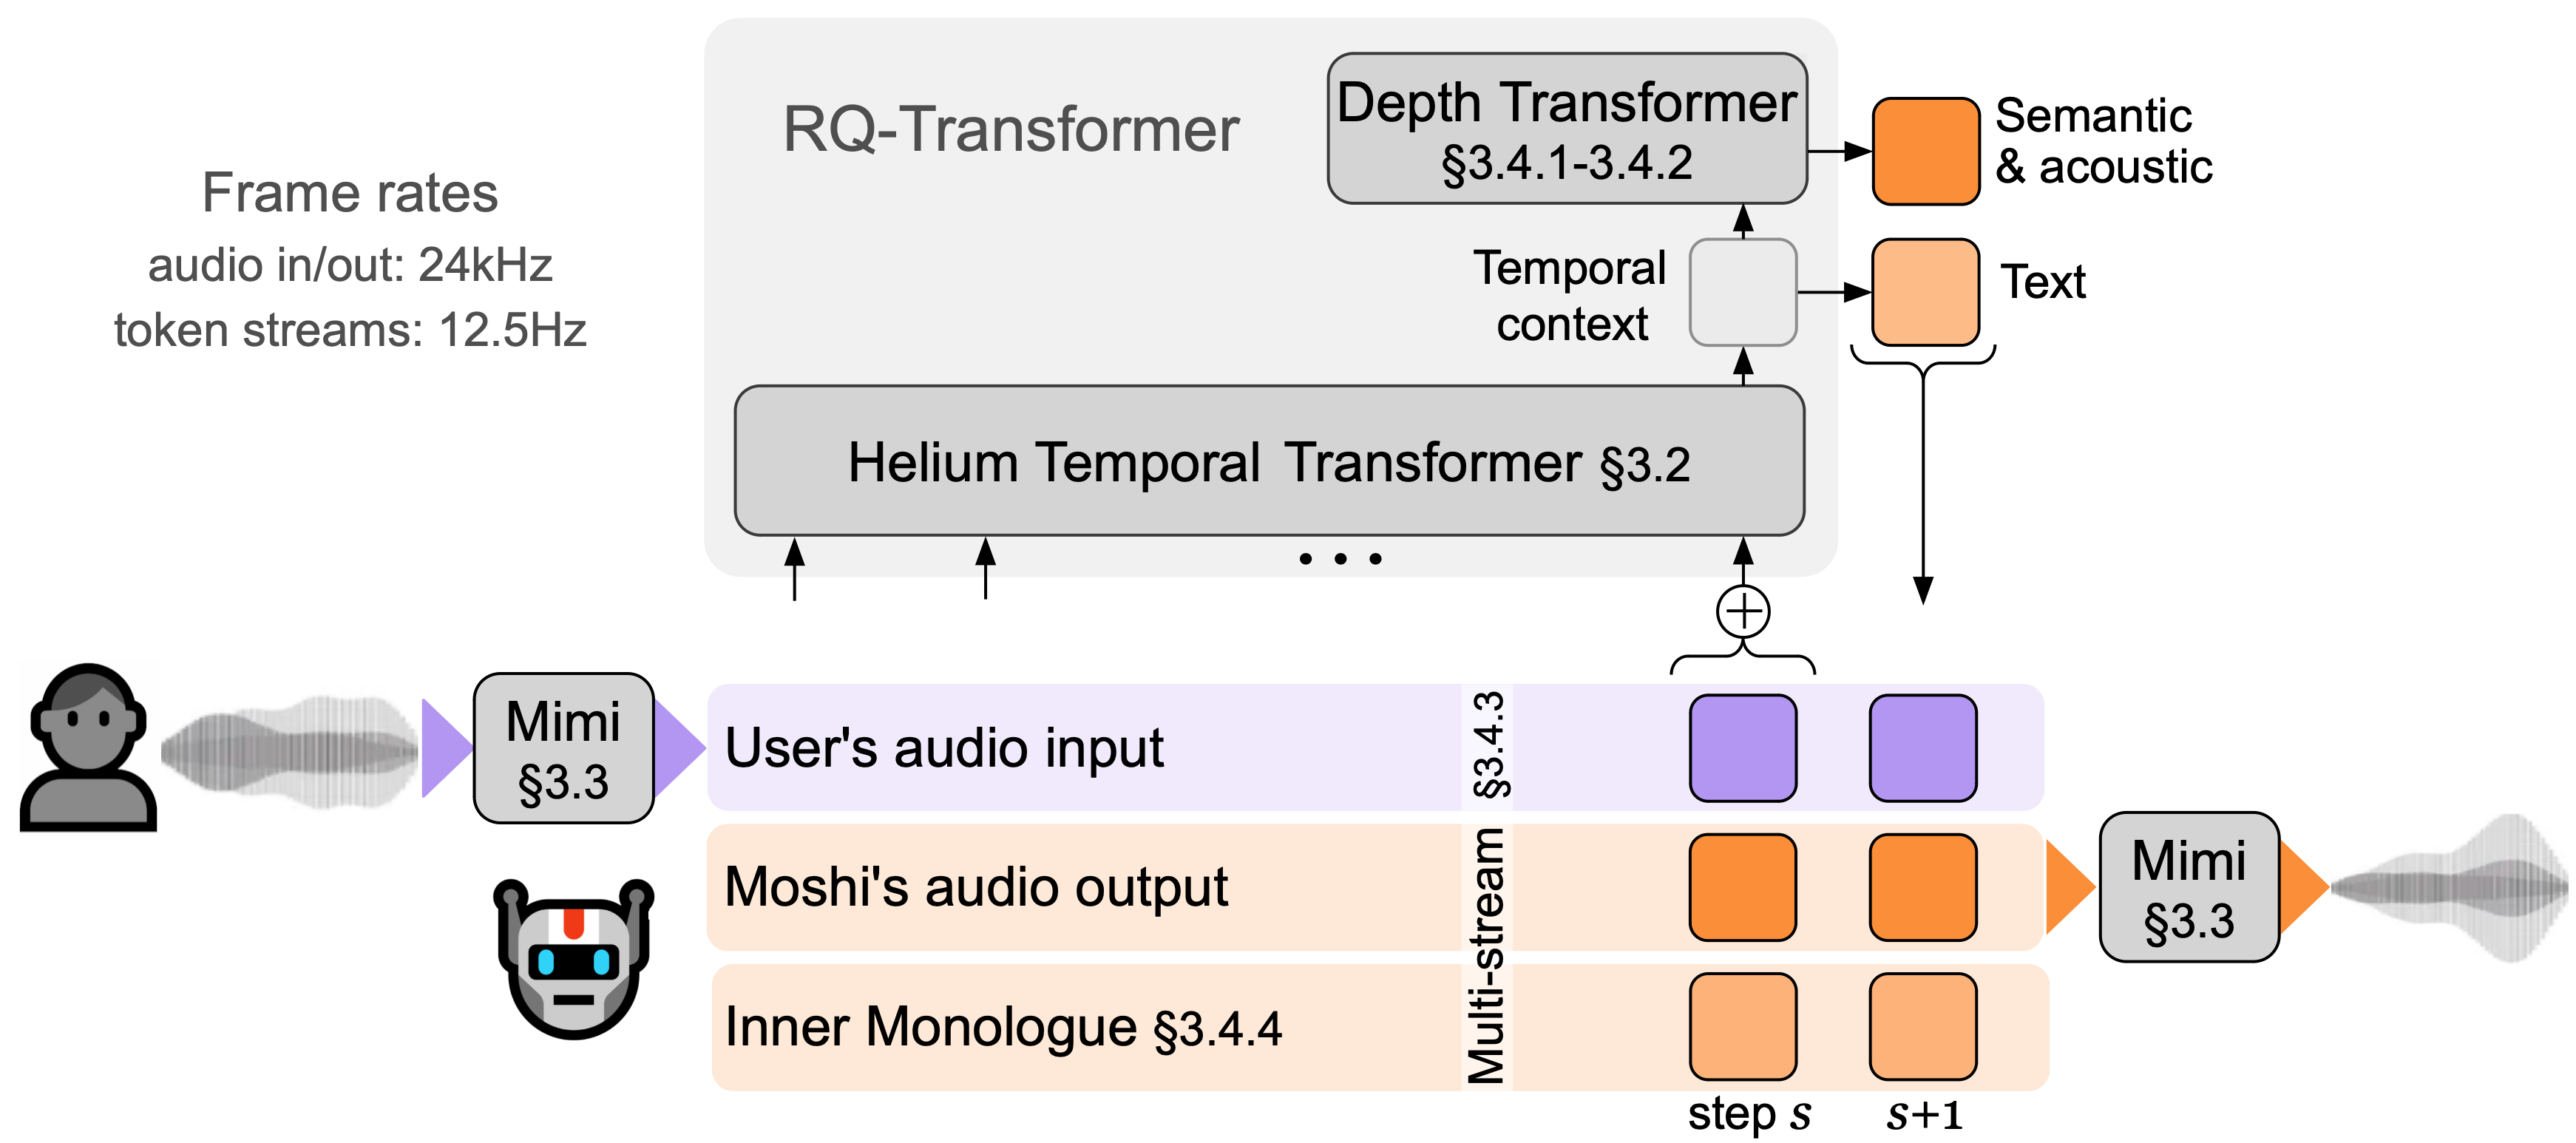
Mehrstufige Verarbeitung: Moshi verarbeitet mehrere Audioströme, um gleichzeitig zuhören und Sprache erzeugen zu können. Diese Multi-Stream-Architektur ermöglicht es, Sprachinteraktionen zwischen Benutzer und System flexibel zu handhaben, ohne den natürlichen Dialogfluss zu unterbrechen.
Im Vergleich zu herkömmlichen Sprachdialogsystemen bietet Moshi mehrere bemerkenswerte Vorteile:
Echtzeit-Reaktion: Die Reaktionsgeschwindigkeit von Moshi ist sehr schnell, die Latenz beträgt nur 160–200 Millisekunden, was nahe an der Reaktionsgeschwindigkeit in natürlichen Gesprächen liegt und somit ein flüssigeres Dialogerlebnis ermöglicht.
Sprache-zu-Sprache-Verarbeitung: Herkömmliche Systeme verlassen sich in der Regel auf den Prozess Sprache-zu-Text-zu-Sprache, während Moshi Spracheingaben direkt verarbeiten und Sprachausgaben erzeugen kann, wobei nonverbale Informationen wie Tonfall und Emotion erhalten bleiben.
Vollduplex-Dialog: Moshi ist nicht auf einen strengen Sprechtüche angewiesen, sondern kann Benutzer- und Systemstimme gleichzeitig verarbeiten. Das bedeutet, dass es überlappende Sprache und Unterbrechungen handhaben kann, was der natürlichen Form menschlicher Gespräche näher kommt.
Die Hauptmerkmale von Moshi:
Echtzeit-Sprachdialog: Moshi erzeugt Audioausgaben direkt aus Audioeingaben, anstatt sich auf den herkömmlichen Prozess Sprache-zu-Text-zu-Sprache zu verlassen. Durch die direkte Verarbeitung von Sprachdaten bewahrt Moshi nonverbale Informationen wie Tonfall, Emotion, überlappende Sprache und Unterbrechungen und sorgt so für natürlichere und flüssigere Dialoge.
Vollduplex-Kommunikation: Moshi kann gleichzeitig hören und sprechen, d. h. es kann Sprachantworten generieren, während der Benutzer spricht, ohne strenge Sprechtüche. Es kann komplexe Dialogszenarien wie überlappende Sprache und ununterbrochenes Feedback (z. B. „mmh“ oder „ich verstehe“) verarbeiten, das jederzeit eingefügt werden kann.
Geringe Latenz: Moshi ist auf eine sehr geringe Latenz ausgelegt, theoretisch nur 160 Millisekunden, in der Praxis etwa 200 Millisekunden. Das bedeutet, dass Moshi nahezu in Echtzeit auf Benutzereingaben reagieren und ein flüssigeres Dialogerlebnis bieten kann.
Innerer-Monolog-Methode: Moshi sagt Texttokens vorher, bevor es Sprache erzeugt, was die sprachliche Qualität und Konsistenz der erzeugten Sprache deutlich verbessert. Dies macht die erzeugte Sprache nicht nur klarer, sondern verbessert auch die Spracherkennung und die Text-zu-Sprache-Fähigkeiten des Systems in Streaming-Umgebungen. Durch die Einführung eines „Inneren-Monolog“-Mechanismus realisiert Moshi Streaming-Spracherkennung (ASR) und Text-zu-Sprache (TTS) und unterstützt die gleichzeitige Verarbeitung von Sprache und Audio in kontinuierlichen Dialogströmen.
Parallele Verarbeitung mehrerer Audioströme: Moshi kann Benutzer- und System-Sprachströme gleichzeitig verarbeiten. Diese Multi-Stream-Verarbeitungsfähigkeit ermöglicht es Moshi, nicht nur eigene Sprache zu erzeugen, sondern auch die Benutzersprache in Echtzeit zu verstehen und darauf zu reagieren.
Verarbeitung von Emotionen und Sprachdynamik: Durch die direkte Verarbeitung von Sprache anstelle von vermittelndem Text kann Moshi emotional gefüllte Sprache verstehen und erzeugen sowie komplexe Dialogdynamiken wie Emotionsäußerungen und Stimmveränderungen verarbeiten.
Unterstützung komplexer Dialogdynamiken: Moshi kann komplexe Dynamiken natürlicher Gespräche verarbeiten, z. B. Unterbrechungen, Überlappungen, Ausrufe und Antworten. Herkömmliche Systeme sind auf klare Sprechtüche angewiesen (eine Person spricht, bevor die andere an der Reihe ist), aber Moshi hebt diese Einschränkung auf und macht Dialoge natürlicher.
Die Modellarchitektur von Moshi
Moshi besteht aus drei Hauptkomponenten: Helium, ein mit 2,1 Billionen Tokens trainiertes 7B-Sprachmodell; Mimi, ein neuronaler Audio-Codec, der semantische und akustische Informationen modelliert; sowie eine neue Multi-Stream-Architektur, die die Audiodaten von Benutzer und Moshi separat modellieren kann.
Durch ihre Zusammenarbeit ermöglichen diese Module flüssige Vollduplex-Dialoge, emotionalen Ausdruck und die Verarbeitung komplexer Dialogdynamiken.
Helium Text-Sprachmodell
Helium ist das Herzstück von Moshi. Es handelt sich um ein Text-Sprachmodell mit 7 Milliarden Parametern, das auf einer Transformer-Architektur (ähnlich wie GPT) basiert. Helium verleiht Moshi starke Sprachverstehens- und Generierungsfähigkeiten.
Die Trainingsdaten umfassen 2,1 Billionen englische Wörter, die ihm umfangreiches Wissen und sprachliche Fähigkeiten verleihen.
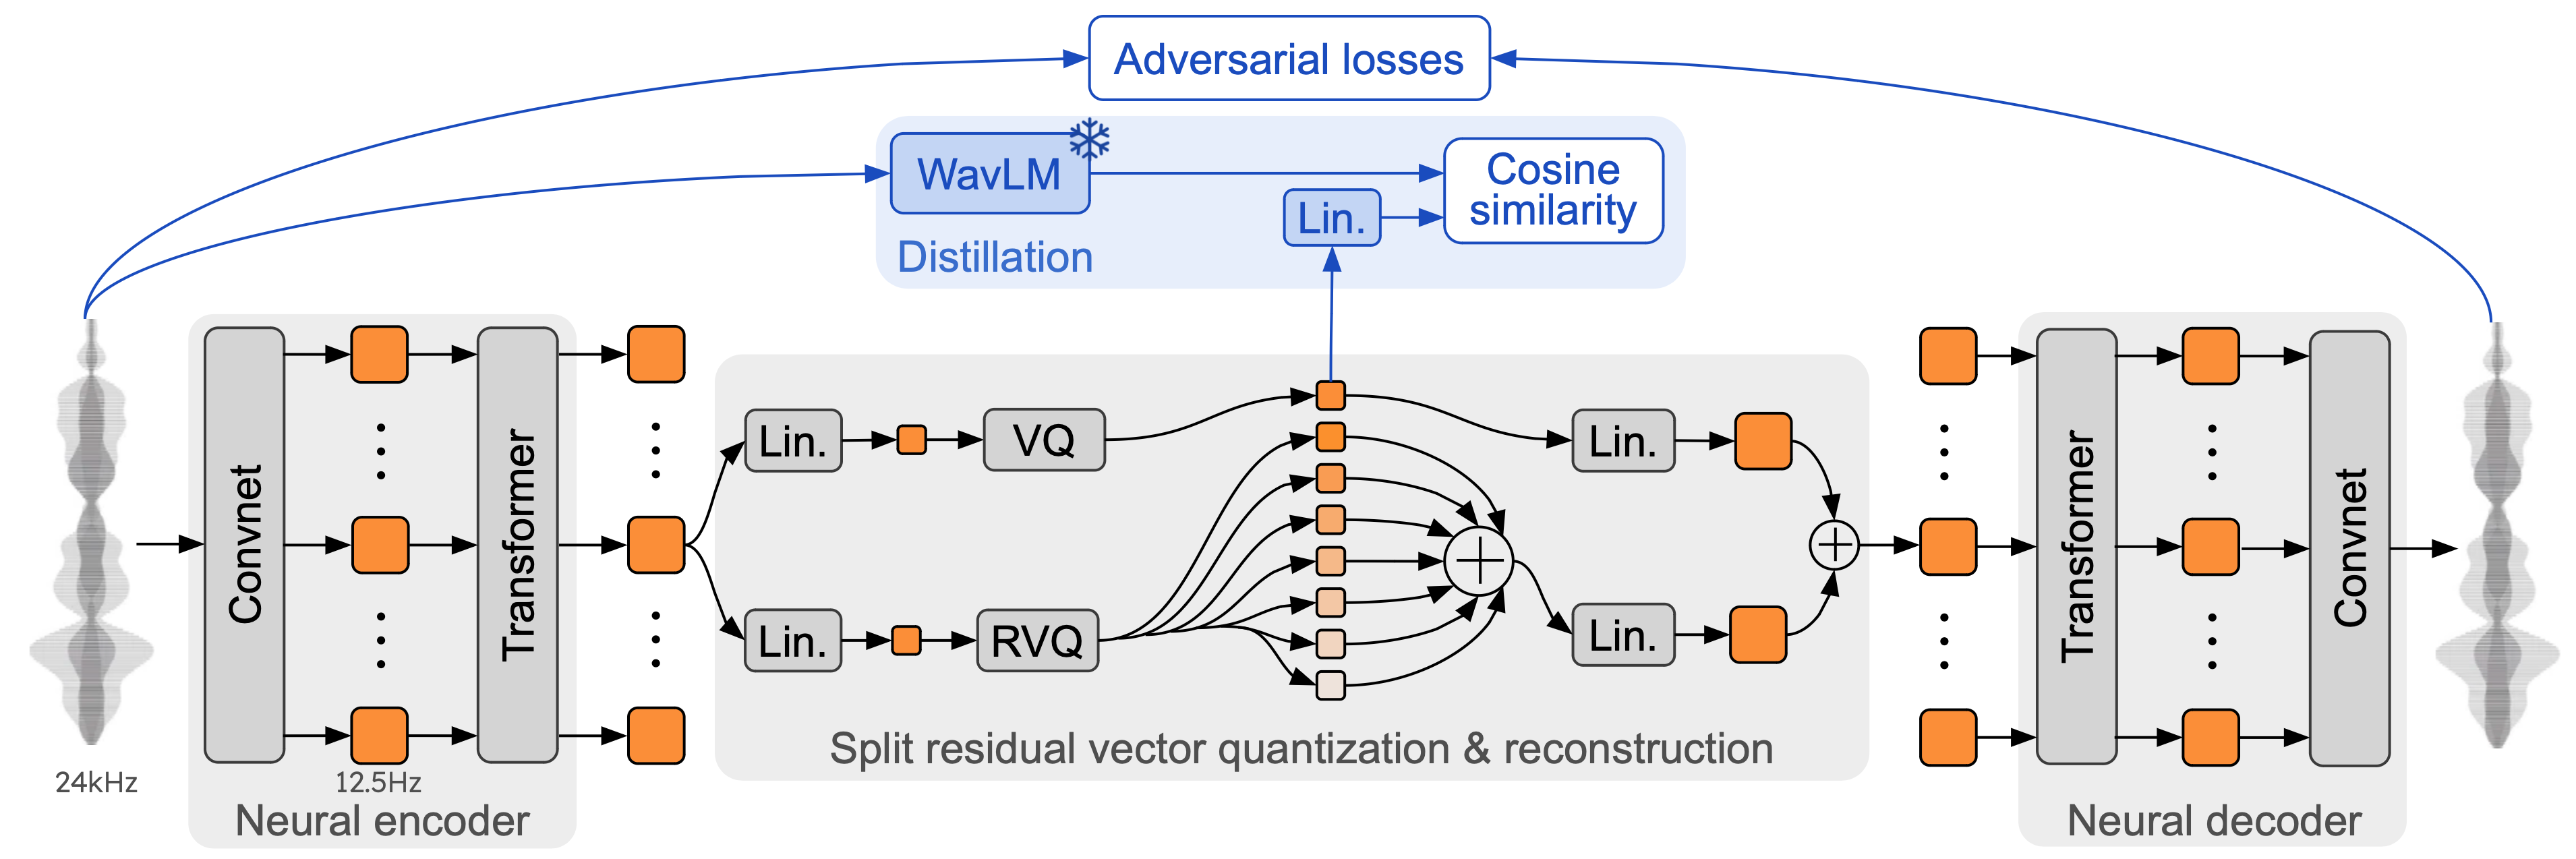
Mimi neuronaler Audio-Codec:Mimi ist die Audiokomponente von Moshi. Es handelt sich um einen neuronalen Audio-Codec, der Audiosignale in diskrete Sprachtokens umwandelt und umgekehrt qualitativ hochwertige Sprachausgaben erzeugen kann.
Mimi verwendet Residual Vector Quantization (RVQ), um Sprachdaten in diskrete Sprach- und Semantik-Tokens zu kodieren, und gewährleistet so eine hohe Sprachtreue und sprachliche Konsistenz.
Durch die Kombination von Semantik- und Akustik-Tokens kann Mimi nicht nur natürliche Sprache erzeugen, sondern auch komplexe Sprachkontexte und emotionale Informationen verarbeiten.
Innerer-Monolog-Methode:Die Innerer-Monolog-Methode ist eine Schlüsseltechnologie für die Spracherzeugung in Moshi und ermöglicht es dem Modell, vor der Erzeugung von Sprache Texttokens vorherzusagen, die mit dem Audio synchronisiert sind. Dieser Ansatz verbessert nicht nur die sprachliche Qualität der erzeugten Sprache, sondern ermöglicht es Moshi auch, in Streaming-Umgebungen Spracherkennung und Text-zu-Sprache-Funktionen zu realisieren.
Synchrone Erzeugung von Text und Sprache: Vor der Audioerzeugung generiert Moshi einen Textstrom, der seiner Sprachausgabe entspricht. Dieser Textstrom dient als Grundlage für die Spracherzeugung, macht sie präziser und hilft bei der Verarbeitung komplexer Dialogszenarien.
Streaming-Kompatibilität: Dieser Ansatz ermöglicht es Moshi, Sprache zu verarbeiten und gleichzeitig in Streaming-Umgebungen eine effiziente Spracherkennung und Text-zu-Sprache (TTS) zu realisieren.
Die Modellarchitektur ist darauf ausgelegt, mehrere parallele Audioströme zu verarbeiten und Sprache sowie Text in Echtzeit zu erzeugen. Moshi kann Systemsprache erzeugen, während es Benutzersprache verarbeitet, wodurch es ununterbrochene natürliche Dialoge unterstützen kann.
Detaillierte technische Methoden von Moshi
1. Sprache-zu-Sprache-Generierungsarchitektur
Die Kerninnovation von Moshi besteht darin, den Sprachdialog als Sprache-zu-Sprache-Generierungsaufgabe zu betrachten, anstatt als herkömmlichen mehrkomponentigen Prozess von Text zu Sprache und dann zu Sprache. Herkömmliche Sprachdialogdialoge bestehen aus mehreren unabhängigen Modulen wie Sprachaktivitätserkennung (VAD), Spracherkennung (ASR), natürlichem Sprachverstehen (NLU), natürlicher Sprachgenerierung (NLG) und Text-zu-Sprache (TTS).
Moshi erzeugt direkt Sprachtokens, sodass die Sprache bei Verstehens- und Generierungsprozessen nicht auf eine zwischengeschaltete Textdarstellung angewiesen ist. Dadurch wird der Verlust von Informationen (z. B. Emotion, Tonfall und nonverbale Laute) vermieden.
2. Helium Text-Sprachmodell
Moshi basiert auf dem Helium Text-Sprachmodell, einem großen Textgenerierungsmodell mit 7B Parametern. Helium wurde mit 2,1 Billionen englischen Daten vortrainiert und verfügt über leistungsstarke Fähigkeiten zum Sprachverstehen, zur Argumentation und zur Generierung. Es bildet die Grundlage für das semantische Verständnis von Moshi und unterstützt komplexe Funktionen zur Verarbeitung natürlicher Sprache, einschließlich offener Dialoge und Frage-Antwort-Szenarien.
Hauptmerkmale von Helium:
Autoregressive Transformer-Architektur: Moshi basiert auf Helium, einem Text-Sprachmodell, das auf einer Transformer-Architektur basiert. Ähnlich wie der klassische Transformer verwendet Helium mehrschichtige Aufmerksamkeitsmechanismen und autoregressive Modellierung, um Texteingaben zu verarbeiten und Ausgaben zu erzeugen. Das Modell verfügt über 7B Parameter, was ausreicht, um das Lernen aus großen Korpora zu unterstützen.
RMS-Normalisierung: RMS-Normalisierung wird in Aufmerksamkeitsmodulen, Feedforward-Modulen und der Ausgabeschicht verwendet, um die Trainingsstabilität des Modells zu verbessern.
Rotary Position Embedding (RoPE): Wird zur Verarbeitung längerer Kontextfenster (4096 Tokens) verwendet, um sicherzustellen, dass das Modell Fernabhängigkeiten in Dialogen erfassen kann.
Effizientes FlashAttention: Durch optimierte Aufmerksamkeitsberechnungen ist die Modellinferenz bei langen Sequenzeingaben effizienter.
3. Mimi neuronaler Audio-Codec
Mimi ist der neuronale Audio-Codec zur Sprachverarbeitung in Moshi. Seine Aufgabe besteht darin, kontinuierliche Sprachsignale in Audiotokens zu diskretisieren. Diese diskreten Audiotokens ähneln Texttokens und können detaillierte Informationen in der Sprache darstellen. Mimi verwendet die Residual Vector Quantization (RVQ), um qualitativ hochwertiges Audio mit niedriger Bitrate zu erhalten und Echtzeit-Spracherzeugung und -verarbeitung zu unterstützen.
Schlüsseltechniken von Mimi:
Residual Vector Quantization (RVQ): Mimi verwendet mehrstufige Residual Vector Quantization, um komplexe Audiosignale in mehrere Ebenen von Audiotokens zu diskretisieren. Dieser Ansatz ermöglicht es, semantische und akustische Informationen der Sprache zu jedem Zeitschritt effizient zu kodieren und gleichzeitig die Qualität der Audiorekonstruktion sicherzustellen.
Kombination aus semantischen und akustischen Tokens: Die von Mimi verwendeten Audiotokens enthalten sowohl semantische als auch akustische Informationen. Semantische Tokens bewahren den Inhalt der Sprache (z. B. die spezifischen gesprochenen Wörter), während akustische Tokens Audioeigenschaften wie Klangfarbe, Emotion und Intonation beschreiben.
Streaming-Codierung und -Decodierung: Mimi unterstützt Streaming und ermöglicht kontinuierliche Spracherzeugung und -erkennung in Echtzeitdialogen. Dadurch ist die Reaktionsgeschwindigkeit von Moshi sehr nah an natürlichen Dialogen.
4. Architektur des RQ-TransformerMoshi verwendet eine mehrstufige hierarchische Generierungsarchitektur, die mehrere Audioströme parallel verarbeiten kann. Moshi modelliert gleichzeitig den Sprachstrom des Nutzers und den eigenen Sprachstrom des Systems und ermöglicht so flexible Interaktionen im Dialog, einschließlich komplexer Dialogdynamiken wie überlappende Rede, Unterbrechungen und Interjektionen zwischen den Sprechern.
Dies ist eine zuvor vorgeschlagene Architektur für die diskrete Bilderzeugung, die die Hierarchie von semantischen und akustischen Tokens modellieren kann, ohne die Helium-Sequenzlänge zu erhöhen. Das bedeutet, dass jede Sekunde Audio nur 12,5 Mal durch das 7B-Backbone-Modell geleitet werden muss, um in Echtzeit auf einer L4 oder einem M3 Macbook Pro zu laufen! In Kombination mit der Token-Latenz von MusicGen bietet dies eine hochmoderne Leistung für die Audio-Sprachmodellierung.
Hierarchische autoregressive Modellierung: Moshi verwendet den RQ-Transformer (Residual Quantizer Transformer), um Audio-Tokens in mehrere Ebenen zu zerlegen, und generiert Audio durch hierarchische autoregressive Modellierung. Konkret verarbeitet das Modell zunächst die Zeitreihen mit einem größeren Temporal Transformer und nutzt dann einen kleineren Depth Transformer, um mehrere Untersequenzen in jedem Zeitschritt zu verarbeiten. Dieses Design verbessert die Effizienz der Generierung langer Audiosequenzen erheblich.
Multimodale Sequenzgenerierung: Das Modell generiert gleichzeitig mehrere Sequenzen (einschließlich Text, semantischer Tokens und Audio-Tokens) und stellt durch einen internen Monolog-Mechanismus deren präzise zeitliche Ausrichtung sicher. Jeder Zeitschritt erzeugt nicht nur die aktuelle Sprache, sondern auch das entsprechende Textpräfix, wodurch die erzeugte Sprache inhaltlich logischer wird.
Architecture of RQ-Transformer
5. „Innerer Monolog"-Mechanismus
Der „Innerer Monolog"-Mechanismus von Moshi ist eine der zentralen Innovationen für die Sprachgenerierung. Durch diesen Mechanismus sagt Moshi vor der Audioerzeugung die entsprechenden zeitlich ausgerichteten Texttokens vorher. Dies verbessert nicht nur die sprachliche Konsistenz der erzeugten Sprache, sondern unterstützt auch Echtzeit-Spracherkennung (ASR) und Text-zu-Sprache-Umwandlung (TTS).
Merkmale des „Innerer Monolog"-Mechanismus:
Ausgerichtete Text- und Audiogenerierung: Moshi sagt zunächst den Text vorher und erzeugt dann das Audio, wodurch die erzeugte Sprache grammatisch und inhaltlich genauer und flüssiger wird.
Latenzmechanismus: Durch die Einführung einer Verzögerung zwischen Text und Audio kann Moshi ASR- und TTS-Aufgaben separat ausführen. Wird beispielsweise zuerst Text und dann Audio erzeugt, befindet sich das Modell im TTS-Modus; andernfalls im ASR-Modus. Moshi kann nahtlos zwischen diesen beiden Modi wechseln und stellt so sicher, dass das Modell Sprache sowohl erzeugen als auch erkennen kann.
Moshi: Delay mechanism
Moshi: TTS mode
6. Mehrstrommodellierung
Die Architektur von Moshi ermöglicht die gleichzeitige Verarbeitung mehrerer Audioströme – sowohl zur Überwachung der Nutzerstimme als auch zur Erzeugung der eigenen Systemstimme. Während des Dialogs kann Moshi überlappende Audiodaten (wie Unterbrechungen und Verschränkungen) dynamisch verarbeiten, ohne Sprecherwechsel vorher explizit festlegen zu müssen. Diese Technik macht Dialoge natürlicher.
Synchronisierte Erzeugung semantischer und akustischer Tokens: Moshi verwendet einen parallelen Mechanismus zur Erzeugung semantischer und Audio-Tokens und optimiert die Abhängigkeiten zwischen diesen Tokens durch die Einführung zeitlicher Verzögerungen. Durch die präzise Modellierung der Audio-Streams von Nutzer und System kann Moshi flexibel auf komplexe Dialogszenarien reagieren.
Zwei-Strom-Audioverarbeitung: Moshi verarbeitet gleichzeitig die Audio-Streams von Nutzer und System und realisiert durch parallele Modellierung zweier autoregressiver Audioströme Vollduplex-Konversationen. Dieses Design ermöglicht es dem Modell, überlappende Sprache und Unterbrechungen in natürlichen Dialogen zu bewältigen.
Latenzbasierte Ausrichtung von Semantik und Audio: Durch die Einführung einer Verzögerung zwischen semantischen Tokens und Audio-Tokens wird sichergestellt, dass die erzeugten Sprachinhalte kohärent und effizient sind. Die Verzögerung beträgt je nach Dialogdynamik 1 bis 2 Frames.
Moshi: Multi-stream modeling
7. Modelltraining und Feinabstimmung
Umfangreiches Vortraining: Moshis Text-Sprachmodell (Helium) wurde auf über 2,1 Billionen englischen Tokens vortrainiert und verfügt über umfangreiche Sprachverständnis- und Generierungsfähigkeiten. Das Modell wurde mit großen Text- und Sprachdatenmengen trainiert und kann verschiedene komplexe Dialogszenarien bewältigen.
Mehrstufiges Training mit und ohne Aufsicht: Moshi wird zunächst auf umfangreichen unüberwachten Sprachdaten vortrainiert, dann auf mehrstufigen Daten mit natürlichen Dialogen nachtrainiert und schließlich einer Instruktions-Feinabstimmung unterzogen, um die Leistung in realen Dialogen weiter zu verbessern.
Helium-Vortraining: Zunächst wird das Helium-Text-Sprachmodell auf einem umfangreichen Textdatensatz vortrainiert, um sein Sprachverständnis und seine Argumentationsfähigkeit zu verbessern.
Moshi-Vortraining: Auf einem unbeschrifteten Audiodatensatz wird das Mehrstrom-Audiomodell trainiert, um Sprachgenerierung und semantisches Verständnis zu erlernen.
Mehrstrom-Feinabstimmung: Das Modell wird mit dem Fisher-Datensatz (der Zwei-Wege-Sprachdialogdaten enthält) feinabgestimmt, um seine Fähigkeit zur Verarbeitung mehrstufiger Spracheingaben zu verbessern.
Instruktions-Feinabstimmung: Abschließend wird das Modell mit generierten Instruktionsdialogdaten feinabgestimmt, um seine Leistung in natürlichen Dialogszenarien zu steigern.
Datenaugmentierung: Während des Trainings setzt Moshi Datenaugmentierungstechniken ein, etwa das Hinzufügen von Hintergrundgeräuschen und das Simulieren von Nutzerechos, damit das Modell in unterschiedlichen Sprachumgebungen stabil arbeitet und seine Belastbarkeit erhöht wird.
Leistungsbewertung von Moshi
1. Qualität und Konsistenz der Sprachgenerierung
Sprachverständlichkeit: Moshi schneidet bei der Sprachgenerierung hervorragend ab; Experimente zeigen, dass es qualitativ hochwertige und leicht verständliche Sprache erzeugen kann. Es kann die sprachliche Kohärenz während des Generierungsprozesses aufrechterhalten, insbesondere in langen Dialogen – ein wichtiger Leistungsindikator für Dialogmodelle in komplexen Kontexten.
Natürlichkeit und Konsistenz der Sprache: Mithilfe des Mimi Neural Audio Codec kann Moshi hochauflösende Sprache erzeugen und die Konsistenz der Systemstimme bewahren. Darüber hinaus kann das Modell je nach Dialogkontext passende emotionale Tonlagen erzeugen, was die Natürlichkeit der Nutzererfahrung verbessert.
2. Echtzeit-Antwortverhalten
Niedrige Latenz: Die theoretische Latenz von Moshi beträgt 160 Millisekunden, in praktischen Tests etwa 200 Millisekunden. Das bedeutet, dass Moshi nahezu in Echtzeit auf Nutzereingaben reagieren kann, was die Interaktionsflüssigkeit und das Dialogerlebnis deutlich verbessert.
Vollduplex-Kommunikationsfähigkeit: Moshi hat in Tests seine Fähigkeit gezeigt, Sprache gleichzeitig zu empfangen und zu erzeugen. Diese Vollduplex-Funktion ermöglicht es, überlappende Sprache und Dialogunterbrechungen zu verarbeiten, mit einer Reaktionsgeschwindigkeit, die der menschlichen Unterhaltung nahekommt.
3. Spracherkennung und Dialogverständnis
Automatische Spracherkennung (ASR): Durch die Inner-Monologue-Methode kombiniert Moshi Text- und Sprachströme und verbessert so die Genauigkeit der Spracherkennung deutlich. Das Modell erfasst nicht nur die Spracheingabe des Nutzers, sondern verbessert auch die Reaktionsgenauigkeit des Systems, indem es zunächst Textvorhersagen erzeugt.
Dialogverständnis und Argumentationsfähigkeit: Moshi nutzt das Helium-Sprachmodell für Textverständnis und Argumentation, wodurch es bei der Verarbeitung komplexer Fragen, offener Dialoge und Wissensabfragen gut abschneidet. Die experimentellen Ergebnisse zeigen, dass Moshi Kontexte effektiv verstehen und angemessene Antworten liefern kann.
4. Robustheit der Mehrstrom-Sprachverarbeitung
Verarbeitung überlappender Sprache: Moshi kann in den Bewertungen komplexe Dialogszenarien bewältigen, etwa überlappende Dialoge mehrerer Sprachströme. Dies ist für die Multitasking-Verarbeitung in realen Anwendungen wichtig, da natürliche Dialoge häufig Unterbrechungen und überlappende Sprache beinhalten.
Verarbeitung von Dialogen mit mehreren Kontexten: Moshi wird auf mehreren Datenströmen trainiert und kann in unterschiedlichen Dialogszenarien gute Leistung zeigen, sei es der Sprachstrom eines einzelnen Nutzers oder der gleichzeitige Dialog mit mehreren Nutzern.
5. Fragebeantwortung und Wissensgewinnung
Moshi übertrifft andere aktuelle Sprachdialogsysteme bei Fragebeantwortung und Wissensgewinnung. Dank seiner starken Textverständnisfähigkeiten und der Echtzeit-Sprachgenerierung kann Moshi mehrstufige Fragen bearbeiten und Nutzeranfragen genau extrahieren und beantworten.
Sprachliche Argumentation und Allgemeinwissen: Das Modell kann komplexe Argumentationsaufgaben bewältigen und schneidet in verschiedenen Standardbewertungen der natürlichen Sprachverarbeitung (NLP) gut ab, etwa bei Allgemeinwissensfragen, Leseverständnis und offenen Fragen.
6. Sprachemotion und personalisierte Generierung
Emotionale Sprachgenerierung: Moshi hat in den Bewertungen seine Fähigkeit zur Erzeugung emotionaler Sprache gezeigt. Es kann je nach Dialogkontext Sprachausgaben mit unterschiedlichen Emotionen erzeugen, etwa Wut, Freude oder Trauer.
Personalisierter Sprachstil: Durch die Instruktions-Feinabstimmung während des Trainings kann Moshi je nach Nutzerbedarf unterschiedliche Stile oder bestimmte Rollenstimmen erzeugen. Diese Personalisierungsfähigkeit ermöglicht vielfältigere Leistungen in spezifischen Dialogszenarien.
7. Sicherheit und Zuverlässigkeit
Sicherheitsbewertung im Dialog: Moshi zeigt eine gute Sicherheit beim Umgang mit Dialogen, die sensible oder unangemessene Inhalte enthalten. Es kann unangemessene Inhalte effektiv erkennen und verhindern und gewährleistet so die Sicherheit und ethische Vertretbarkeit der Konversation.
Robustheit und Anpassung an geräuschvolle Umgebungen: In Bewertungen unter geräuschvollen und komplexen Umgebungen zeigt Moshi eine gute Robustheit. Durch Datenaugmentierungstechniken (wie Geräuschaddition und Echoverarbeitung) kann das Modell unterschiedliche Sprachumgebungen bewältigen und qualitativ hochwertige Ausgaben auch in geräuschvoller Umgebung gewährleisten.
Acht. Umfassende Testergebnisse
Die umfassenden Leistungstests von Moshi zeigen, dass es führende Ergebnisse in den Bereichen Sprachgenerierung, Dialogverständnis, Echtzeit-Antwortverhalten und Verarbeitung komplexer Dialoge erzielt. Besonders sticht Moshi bei der Handhabung überlappender Dialoge, Sprachunterbrechungen und der Emotionserzeugung hervor und übertrifft herkömmliche Dialogsysteme bei Weitem.
Technischer Bericht: https://kyutai.org/Moshi.pdf
GitHub: https://github.com/kyutai-labs/moshi
Modelldownload: https ://huggingface.co/collections/kyutai/moshi-v01-release-66eaeaf3302bef6bd9ad7acd
Online ausprobieren: https://moshi.chat/
Verwandte Nachrichten:














