
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
MoshiVis: Ein Vision-Speech-Modell, das zuhört, sieht und Bilder in flüssiger Sprache bespricht
小编 ·

MoshiVis: Ein Vision-Speech-Modell, das zuhört, sieht und Bilder in flüssiger Sprache bespricht
Was ist MoshiVis?
MoshiVis ist ein visuelles Sprachmodell, das auf Moshi aufbaut und die geringe Latenz sowie die Fähigkeit zu natürlichen Gesprächen von Moshi beibehält. Es kann Bildinhalte in einem natürlichen Gesprächsstil diskutieren, unterstützt mehrere Gesprächsrunden, kann Textinhalte von Bildern beschreiben und Fragen zu Bildern beantworten.
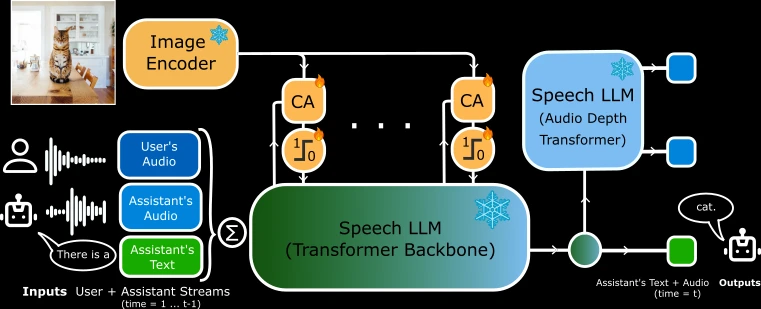
Es integriert visuelle Informationen über einen Cross-Attention-Mechanismus in den Sprachstrom und behält dabei eine geringe Latenz und einen niedrigen Speicherverbrauch bei. MoshiVis bietet Unterstützung für mehrere Backends (wie PyTorch, Rust, MLX) und stellt vortrainierte Modelle sowie synthetische visuelle Dialogdatensätze bereit, die sich für Echtzeit-Sprachinteraktionsszenarien eignen.
Kernfunktionen von MoshiVis
Verbindung von Vision und Sprache: MoshiVis erweitert Moshi um visuelle Verständnisfähigkeiten und kann Bildinformationen in Sprachdialoge integrieren. Durch die Erweiterung der zentralen Transformer-Architektur wird ein Cross-Attention-Mechanismus eingeführt, der visuelle Informationen in den Sprachstrom einspeist.
Geringe Latenz und niedriger Speicherverbrauch: Um die geringe Latenz beizubehalten und den Speicherverbrauch zu reduzieren, werden die Cross-Attention-Projektionsgewichte von MoshiVis zwischen den Schichten geteilt und visuelle Eingabeströme über einen Gating-Mechanismus reguliert.
Natürlicher Gesprächsstil: Das Modell behält den ursprünglichen natürlichen Gesprächsstil von Moshi bei, während es visuelle Fähigkeiten integriert.
Technische Architektur von MoshiVis
Basis-Modell: Basierend auf Moshi, einem Sprach-Text-Basis-Modell mit 7B Parametern.
Visueller Encoder: Verwendet einen vortrainierten eingefrorenen 400M-Visuell-Encoder aus der PaliGemma2-Familie.
Adapter-Parameter: Fügt Moshi ca. 206M Adapter-Parameter für die Verarbeitung visueller Informationen hinzu.
Cross-Attention-Mechanismus: Visuelle Informationen werden über ein Cross-Attention-Modul in den Sprachstrom eingespeist, wobei der Einfluss der visuellen Eingabe über einen Gating-Mechanismus reguliert wird.
Veröffentlichung des MoshiVis-Modells
Modellvarianten: Veröffentlichung des MoshiVis-Modells basierend auf Moshika (weibliche Stimme), einschließlich der vollständigen Modellgewichte, wie Sprachcodec, Text-Tokenizer, Bild-Encoder und Moshi-Basis-Modell.
Backend-Unterstützung: Bietet drei Backends, darunter PyTorch, Rust und MLX, und unterstützt verschiedene Quantisierungsformate (wie BF16, Q8_0 usw.).
Lizenz: Die Modellgewichte (ohne den visuellen Encoder) werden unter der CC-BY 4.0-Lizenz veröffentlicht, der visuelle Encoder unter der Gemma-Lizenz.
Verwendung von MoshiVis
WebUI-Frontend: Ein WebUI-Frontend wird bereitgestellt, das Echo-Unterdrückung unterstützt und die Modellleistung verbessert. Benutzer können eine vorgefertigte statische Version verwenden oder den Quellcode selbst kompilieren.
Backend-Ausführung:
PyTorch: Erfordert ca. 24 GB GPU-Speicher, unterstützt keine Quantisierung.
Rust: Unterstützt GPU-Beschleunigung, erfordert die Rust-Toolchain und CUDA (oder Metal unter macOS).
MLX: Unterstützt bfloat16 und Quantisierung (q4, q8).
Ausführungsbefehle: Es werden detaillierte Ausführungsbefehle bereitgestellt, sodass Benutzer je nach Bedarf verschiedene Backends und Quantisierungsformate wählen können.
Verwandte Links:
GitHub-Projekt:https://github.com/kyutai-labs/moshivis
HuggingFace-Modell:https://huggingface.co/collections/kyutai/moshivis-v01-67cef4acae6a5d75d6d6c883









