
 Помощник сценариста▸
 AI Приложения
 AI Новости
Step-Video-T2V: передовая модель генерации видео из текста
Step-Video-T2V: передовая модель генерации видео из текстаОписание
Step-Video-T2V — это передовая модель преобразования текста в видео с открытым исходным кодом, созданная в результате сотрудничества компании StepFun и Geely Auto. Она обладает множеством выдающихся характеристик и демонстрирует высокую эффективность в области генерации видео.
Преимущества модели Step-Video-T2V
Использование архитектуры DiT и метода обучения с потоковым сопоставлением обеспечивает 16×16-кратное пространственное сжатие и 8-кратное временное сжатие, что значительно повышает эффективность крупномасштабной генерации видео.
Обладая огромным количеством параметров — 30 миллиардов, модель способна генерировать высококачественные видео с разрешением до 544x992.
Поддержка ввода подсказок на китайском и английском языках обеспечивает удобство использования для пользователей с разным языковым фоном.
Функциональные особенности Step-Video-T2V
Крупномасштабные параметры: количество параметров достигает 30 миллиардов, что обеспечивает модели высокую способность и точность генерации, позволяя более точно понимать текстовые описания и преобразовывать их в качественное видео.
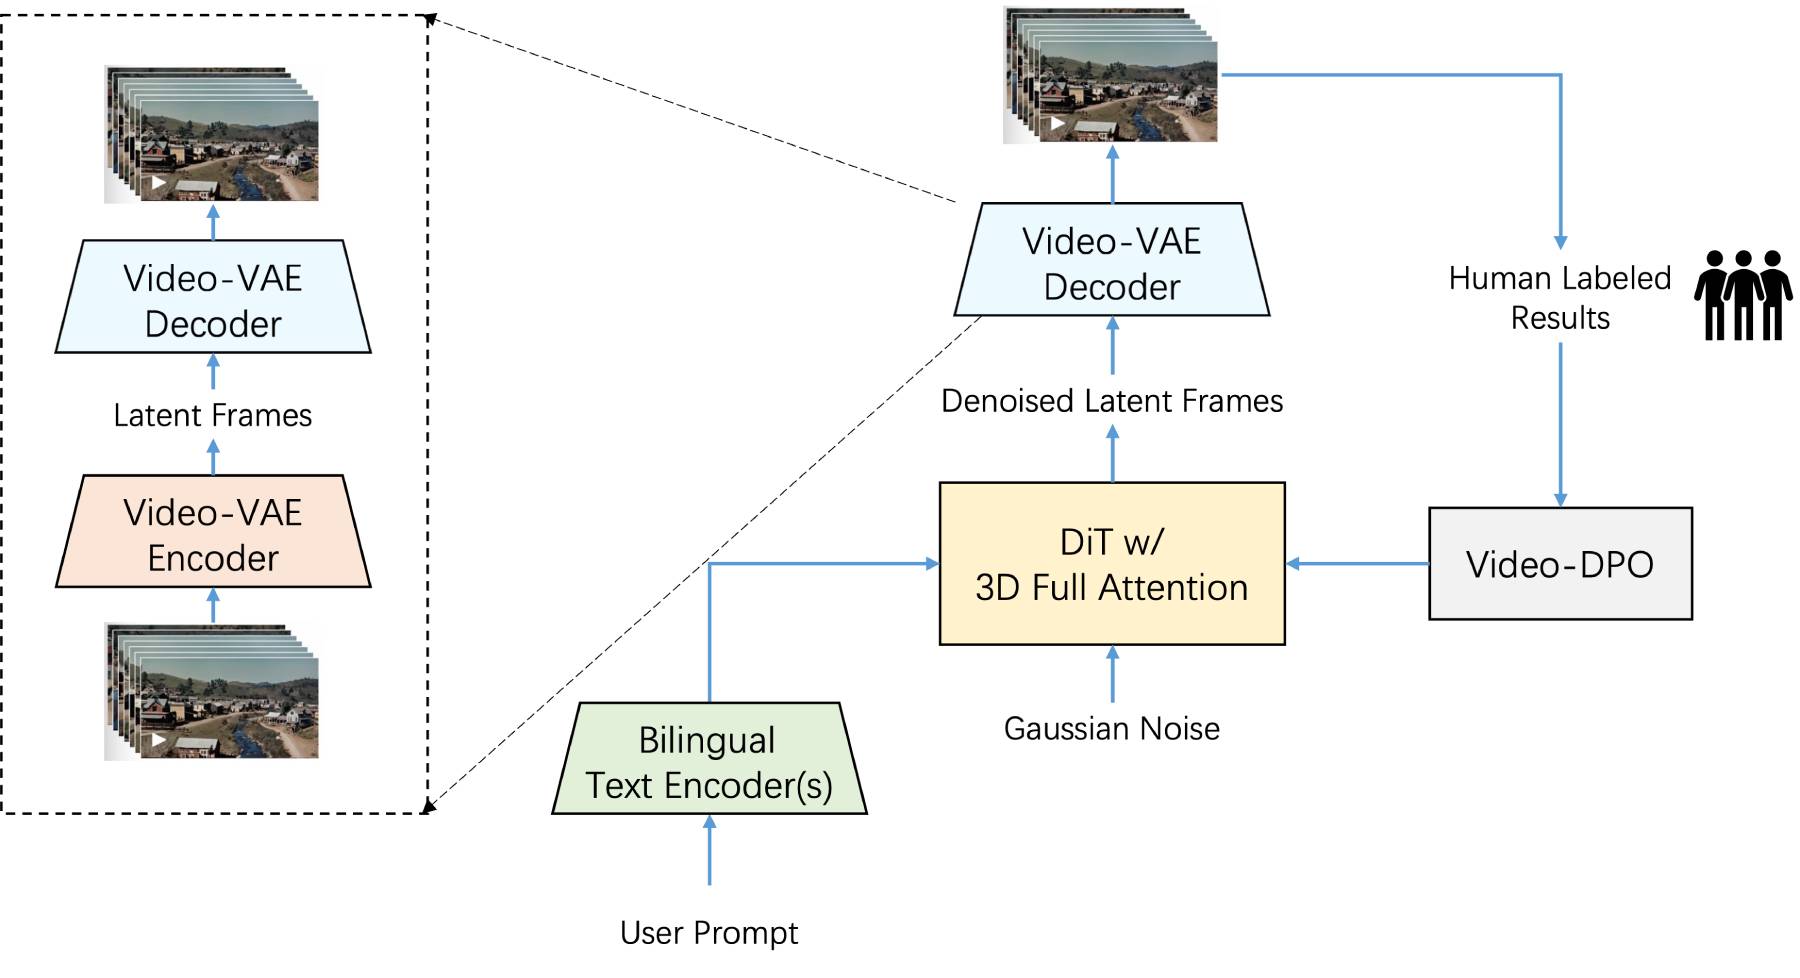
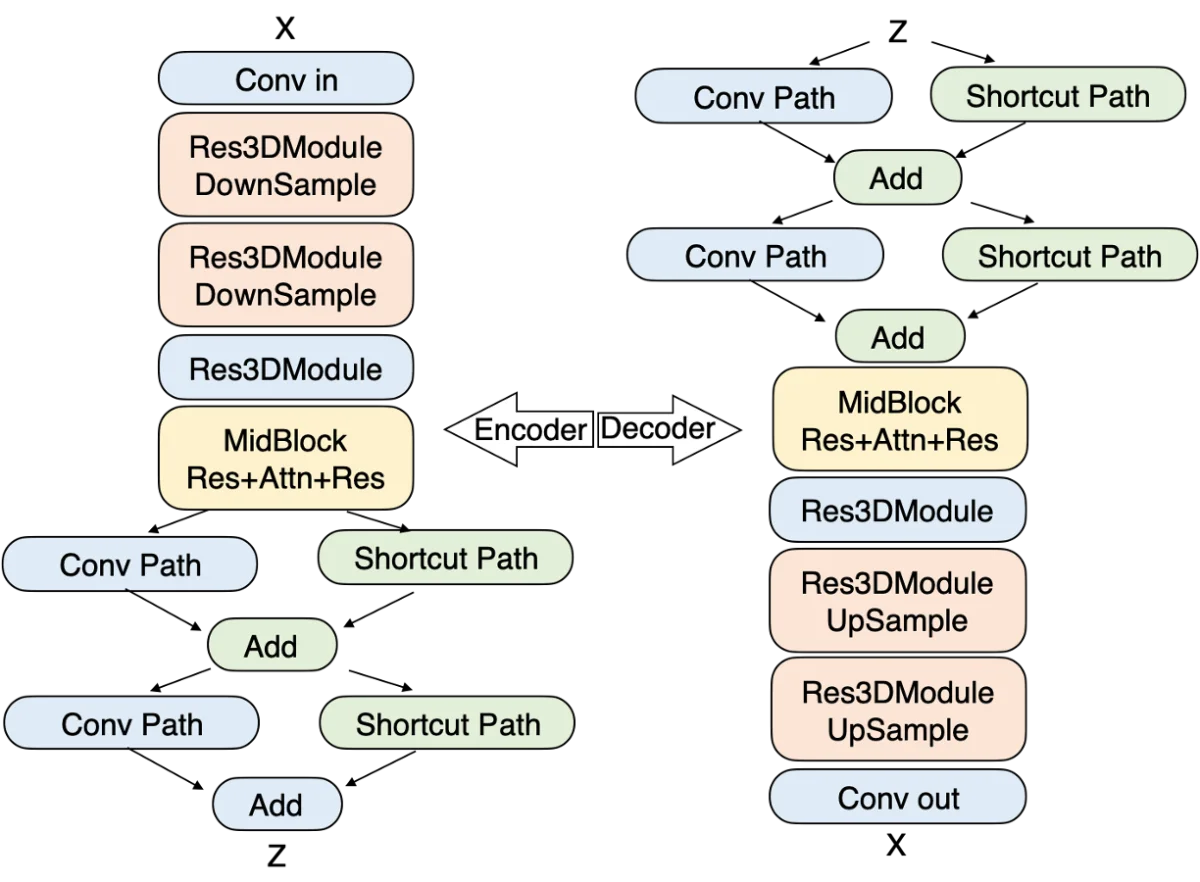
Эффективная генерация видео: поддержка генерации качественных видео длительностью до 204 кадров (544x992 пикселей) удовлетворяет разнообразные творческие потребности. Применение вариационного автокодировщика с глубоким сжатием (Video-VAE) обеспечивает 16×16 пространственное и 8× временное сжатие, что позволяет эффективно снизить затраты на обучение и инференс при сохранении качества видео.
Двуязычный текстовый кодировщик: поддержка ввода на китайском и английском языках позволяет глубоко понимать и создавать видеоконтент, соответствующий текстовому описанию, что делает модель удобной для пользователей с разными языками.
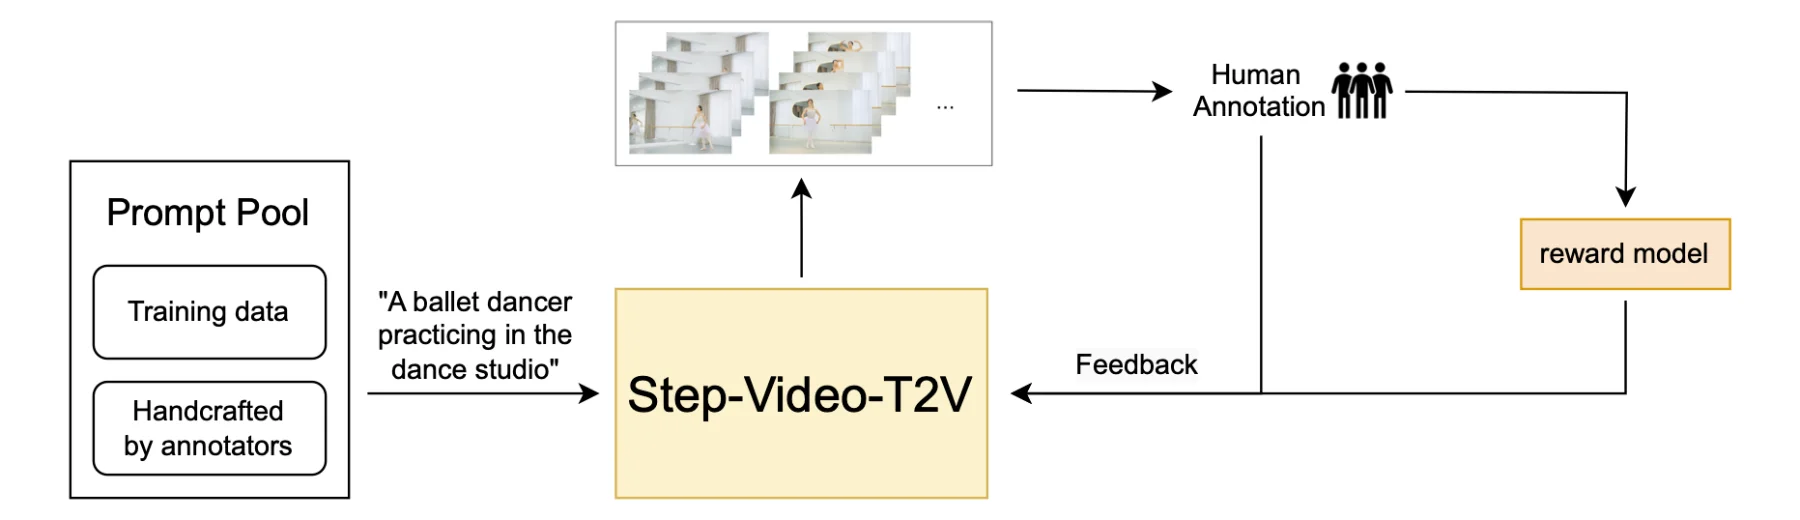
Передовая архитектура: используется 3D-архитектура полного внимания DiT, которая гибко адаптируется к изменениям динамического разрешения, обеспечивая стабильность и высокое качество генерации видео. Внедрение оптимизации видео-предпочтений (Direct Preference Optimization, DPO) с помощью механизма обратной связи от человека дополнительно повышает качество и плавность генерируемого видео, делая его более соответствующим ожиданиям пользователей.
Мультимодальное слияние: объединение возможностей понимания трёх модальностей — изображения, речи и текста — обеспечивает более реалистичные детали в генерируемом контенте. Например, выражения лиц персонажей становятся более живыми, изменения света и тени — более естественными, а движущиеся объекты — более плавными и реалистичными.
Гибкие режимы работы: доступны базовая версия (генерация за 50 шагов) и версия Turbo (ускорение с дистилляцией до 15 шагов), что удовлетворяет потребности разных пользователей в различных сценариях. На практике генерация 204 кадров видео требует примерно 4 GPU с 80 ГБ видеопамяти и занимает около 12 минут.
Сценарии применения Step-Video-T2V
Создание креативного видео: помогает видеографам генерировать сложные сцены и детализированный креативный видеоконтент, что идеально подходит для производства рекламы, создания коротких видео и других областей.
Анимация и кинопроизводство: может использоваться в индустрии анимации и кино для генерации высококачественных виртуальных персонажей, динамических сцен и сложных движений.
Образование и обучение: позволяет создавать интерактивные учебные видео, делая процесс обучения более живым и интересным, повышая вовлечённость учащихся и эффективность обучения.
Индустрия развлечений: может автоматически генерировать игровые CG-ролики, трейлеры фильмов и другой развлекательный контент, экономя значительное количество времени и трудозатрат.
Распространение культуры: особенно эффективна в области эстетики китайского стиля, позволяя генерировать内容 в стиле туши, древние пейзажи и т.д., что способствует цифровому распространению традиционной культуры и придаёт ей новую жизнь в современную эпоху.
Инструкция по использованию Step-Video-T2V:
1. Установка зависимостей:
Установите необходимые библиотеки Python и зависимости. Обычно установка выполняется через pip или другие менеджеры пакетов — инструменты.
pip install transformers torch torchvision torchaudio
2. Настройка среды:
Настройте аппаратное окружение, необходимое для работы: рекомендуется минимум 4 GPU NVIDIA с 80 ГБ видеопамяти.
3. Загрузка модели:
Используйте библиотеку Hugging Face Transformers для загрузки предобученной модели Step-Video-T2V.
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "stepfun-ai/Step-Video-T2V"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
4. Генерация видео:
Подготовьте текстовую подсказку и преобразуйте её в формат, пригодный для модели.
Запустите скрипт генерации и дождитесь результата.
input_text = "A red-haired woman performing on stage."
inputs = tokenizer(input_text, return_tensors="pt")
# Generate video frames (this is a simplified example; actual implementation may vary)
outputs = model.generate(**inputs, max_length=204)  # Adjust parameters as needed
# Save or display the generated video frames
5. Постобработка:
Выполните постобработку сгенерированных видеокадров, например, склейку их в полноценное видео, добавление аудио и т.д.
Доступ к ресурсам:
Репозиторий на GitHub: https://github.com/stepfun-ai/Step-Video-T2V
Демо на Hugging Face: https://huggingface.co/stepfun-ai














