
 Помощник сценариста▸
 AI Приложения
 AI Новости
Moshi: преобразователь голоса в реальном времени с открытым исходным кодом
Moshi: преобразователь голоса в реальном времени с открытым исходным кодомОписание
Moshi — это многонаправленная модель Transformer для генерации речи в реальном времени, поддерживающая полнодуплексный голосовой диалог. Её основные особенности — одновременный голосовой ввод и вывод (полный дуплекс), а также способность обрабатывать сложные сценарии диалога, включая перекрывающуюся речь, перебивания и невербальную информацию, такую как выражение эмоций.
Это означает, что она может одновременно слушать и говорить, и призвана решить некоторые проблемы традиционных диалоговых систем, такие как задержка, потеря невербальной информации (например, эмоций) и жёсткая структура очерёдности в диалоге.
Полнодуплексная связь: традиционные диалоговые системы основаны на принципе очерёдности (один человек заканчивает говорить, прежде чем начинает другой). Moshi преодолевает это ограничение и поддерживает полнодуплексную связь. Это означает, что Moshi может генерировать голосовой ответ во время речи пользователя, не ограничиваясь очерёдностью, и обрабатывать сложную динамику диалога, такую как перекрывающаяся речь, перебивания и быстрая обратная связь.
Многонаправленная обработка: Moshi обрабатывает несколько аудиопотоков для одновременного прослушивания и генерации речи. Эта многонаправленная архитектура позволяет гибко обрабатывать голосовое взаимодействие между пользователем и системой, не прерывая естественный ход разговора.
По сравнению с традиционными системами голосового диалога Moshi обладает рядом заметных преимуществ:
Отклик в реальном времени: Moshi отвечает очень быстро, с задержкой всего 160–200 мс, что близко к скорости реакции в естественном разговоре, поэтому обеспечивает более плавный диалоговый опыт.
Обработка «речь-в-речь»: традиционные системы обычно полагаются на процесс преобразования речи в текст и затем в речь, тогда как Moshi может напрямую обрабатывать голосовой ввод и генерировать голосовой вывод, сохраняя невербальную информацию, такую как тон и эмоции.
Полнодуплексный диалог: Moshi не зависит от строгой очерёдности в диалоге и может одновременно обрабатывать речь пользователя и системы, а значит, способен обрабатывать перекрывающуюся речь и перебивания, что ближе к естественной форме человеческого разговора.
Основные особенности Moshi:
Голосовой диалог в реальном времени: Moshi напрямую генерирует аудиовыход из аудиовхода, а не полагается на традиционный процесс «речь-в-текст-в-речь». Благодаря прямой обработке голосовых данных Moshi сохраняет невербальную информацию, такую как тон, эмоции, перекрывающуюся речь и перебивания, обеспечивая более естественный и плавный диалог.
Полнодуплексная связь: Moshi способен одновременно слушать и говорить, а значит, может генерировать голосовой ответ во время речи пользователя без строгой очерёдности в диалоге. Он может обрабатывать сложные сценарии разговора, такие как перекрывающаяся речь и возможность в любой момент вставлять непрерывную обратную связь (например, «хм» или «понимаю»).
Низкая задержка: Moshi спроектирован с очень низкой задержкой — теоретически всего 160 мс, а на практике около 200 мс. Это означает, что Moshi может реагировать на ввод пользователя почти в реальном времени, обеспечивая более плавный диалоговый опыт.
Метод внутреннего монолога: Moshi предсказывает текстовые метки перед генерацией речи, что значительно повышает языковое качество и согласованность генерируемой речи. Это не только делает сгенерированную речь более чёткой, но и улучшает способность системы к распознаванию речи и преобразованию текста в речь в потоковой среде. Moshi, вводя механизм «внутреннего монолога», реализует функции потокового распознавания речи (ASR) и преобразования текста в речь (TTS), поддерживая одновременную обработку языка и аудио в непрерывном потоке диалога.
Параллельная обработка нескольких аудиопотоков: Moshi способен одновременно обрабатывать голосовые потоки пользователя и системы. Эта способность к многонаправленной обработке позволяет Moshi не только генерировать собственную речь, но и в реальном времени понимать и реагировать на речь пользователя.
Обработка эмоций и речевой динамики: благодаря прямой обработке речи, а не промежуточного текста, Moshi способен понимать и генерировать эмоционально окрашенную речь, а также обрабатывать сложную динамику диалога, такую как выражение эмоций, изменение голоса и т. д.
Поддержка сложной динамики диалога: Moshi способен обрабатывать сложную динамику естественного разговора, такую как перебивания, перекрытие, междометия и отклики. Традиционные системы полагаются на чёткую очерёдность в диалоге (один говорит, прежде чем наступает очередь другого), но Moshi устраняет это ограничение, делая разговор более естественным.
Архитектура модели Moshi
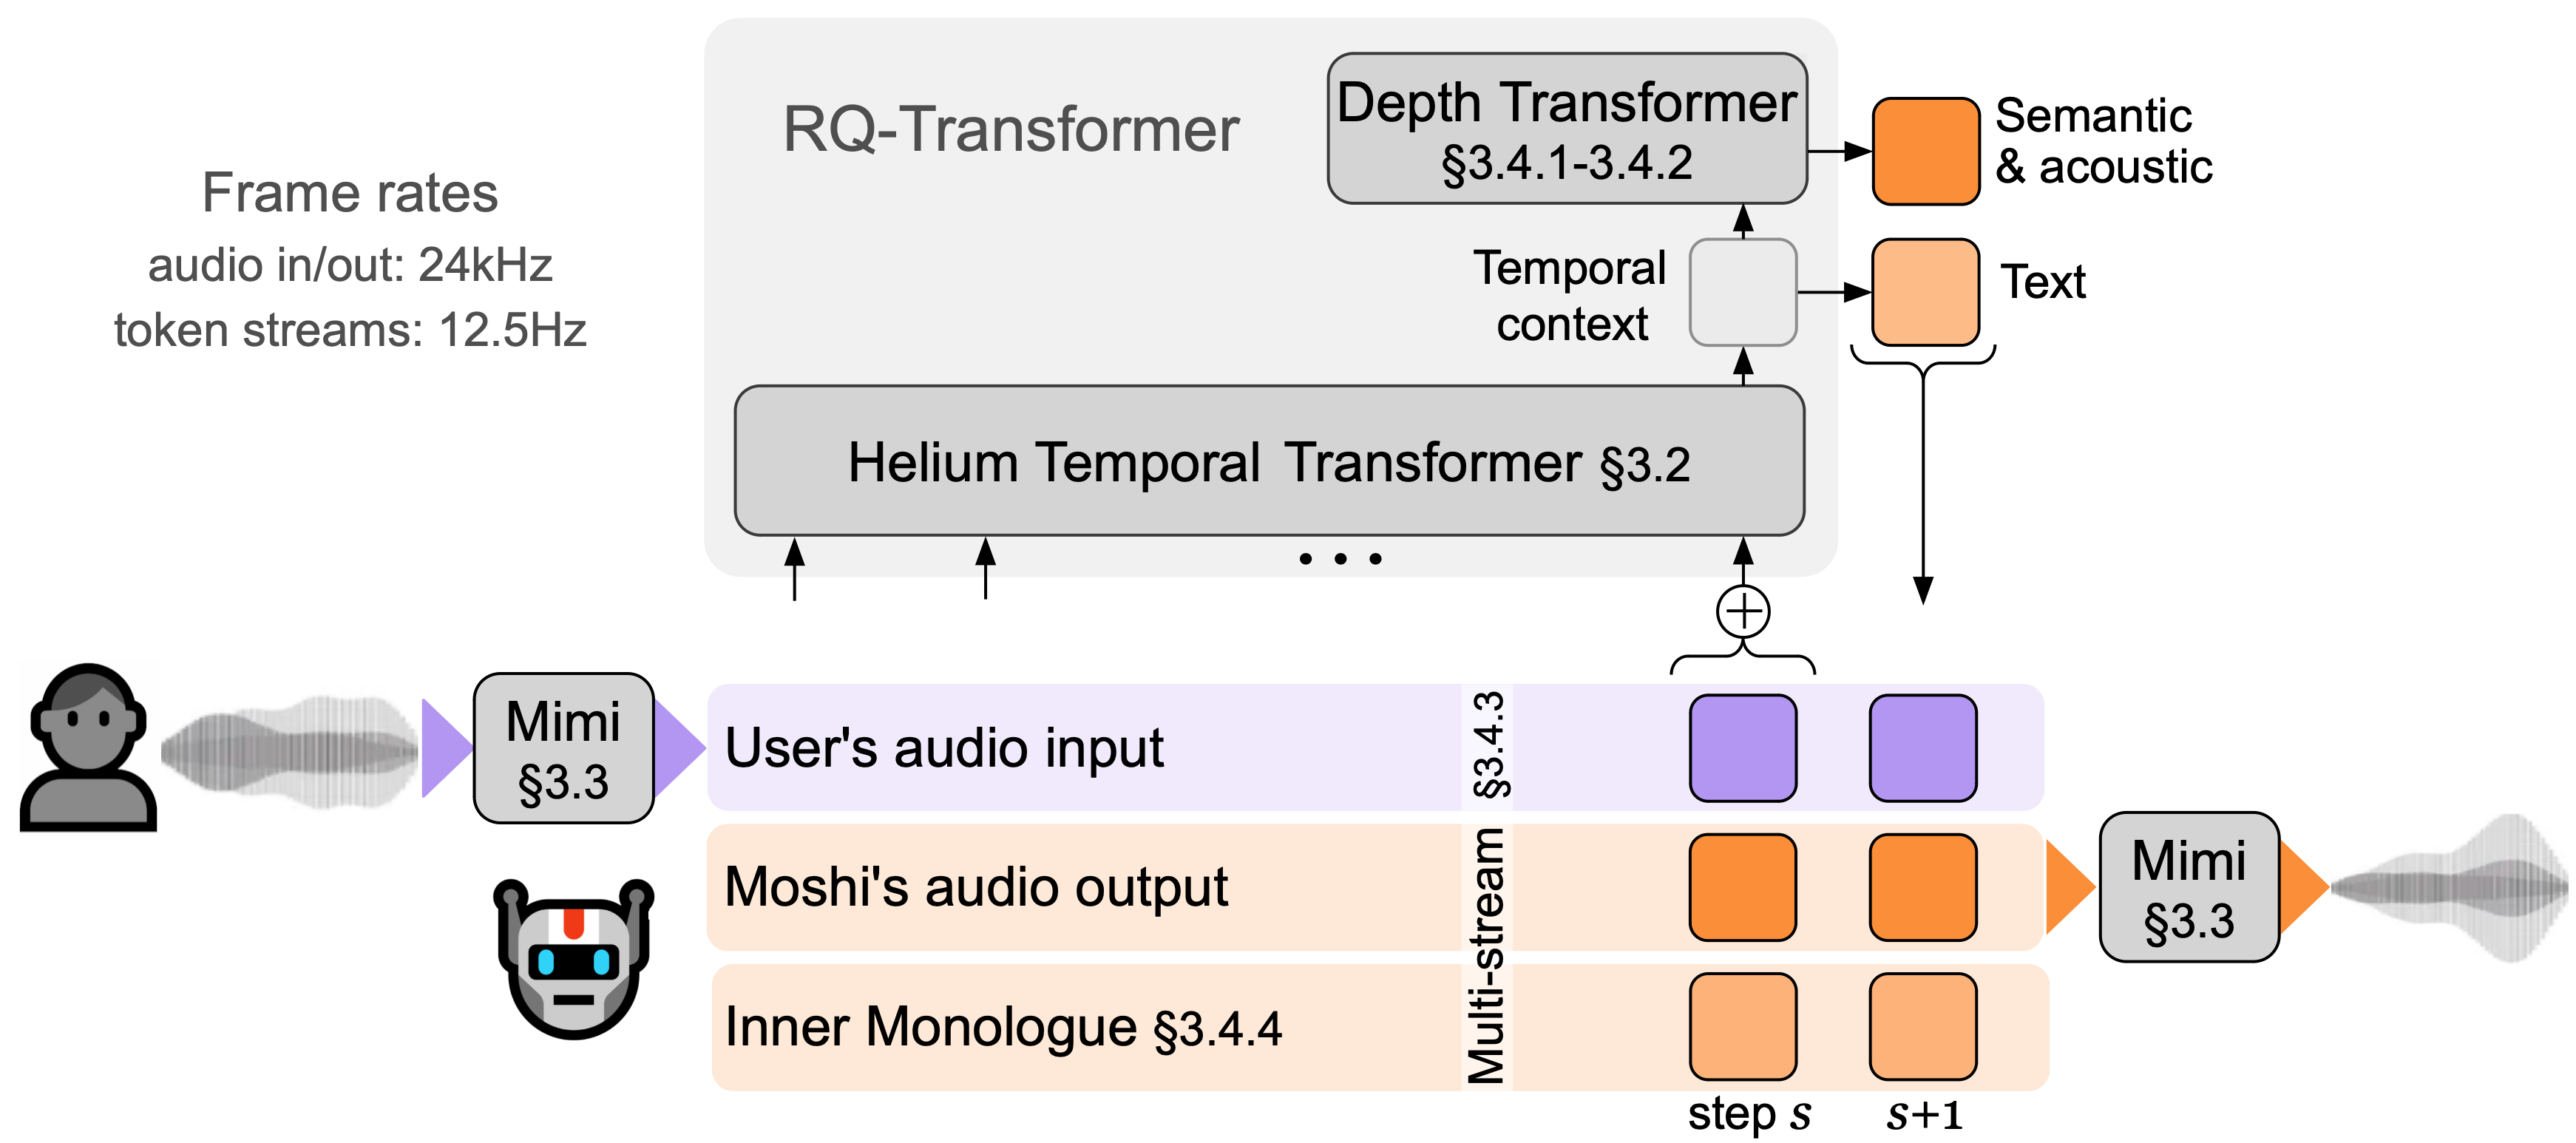
Moshi состоит из трёх основных компонентов: Helium — языковая модель на 7B, обученная на 2,1 триллиона токенов; Mimi — нейронный аудиокодек, моделирующий семантическую и акустическую информацию; а также новая многонаправленная архитектура, позволяющая моделировать аудио пользователя и Moshi по отдельности.
Благодаря совместной работе эти модули обеспечивают плавный полнодуплексный диалог, выражение эмоций и обработку сложной динамики разговора.
Текстовая языковая модель Helium
Helium является ядром Moshi. Это текстовая языковая модель на основе архитектуры Transformer (аналогичная GPT) с 7 миллиардами параметров. Helium обеспечивает Moshi мощными возможностями понимания и генерации языка, способными обрабатывать сложные задачи текстового рассуждения и диалога.
Обучающие данные включают 2,1 триллиона английских слов, что придаёт модели обширные знания и языковые способности.
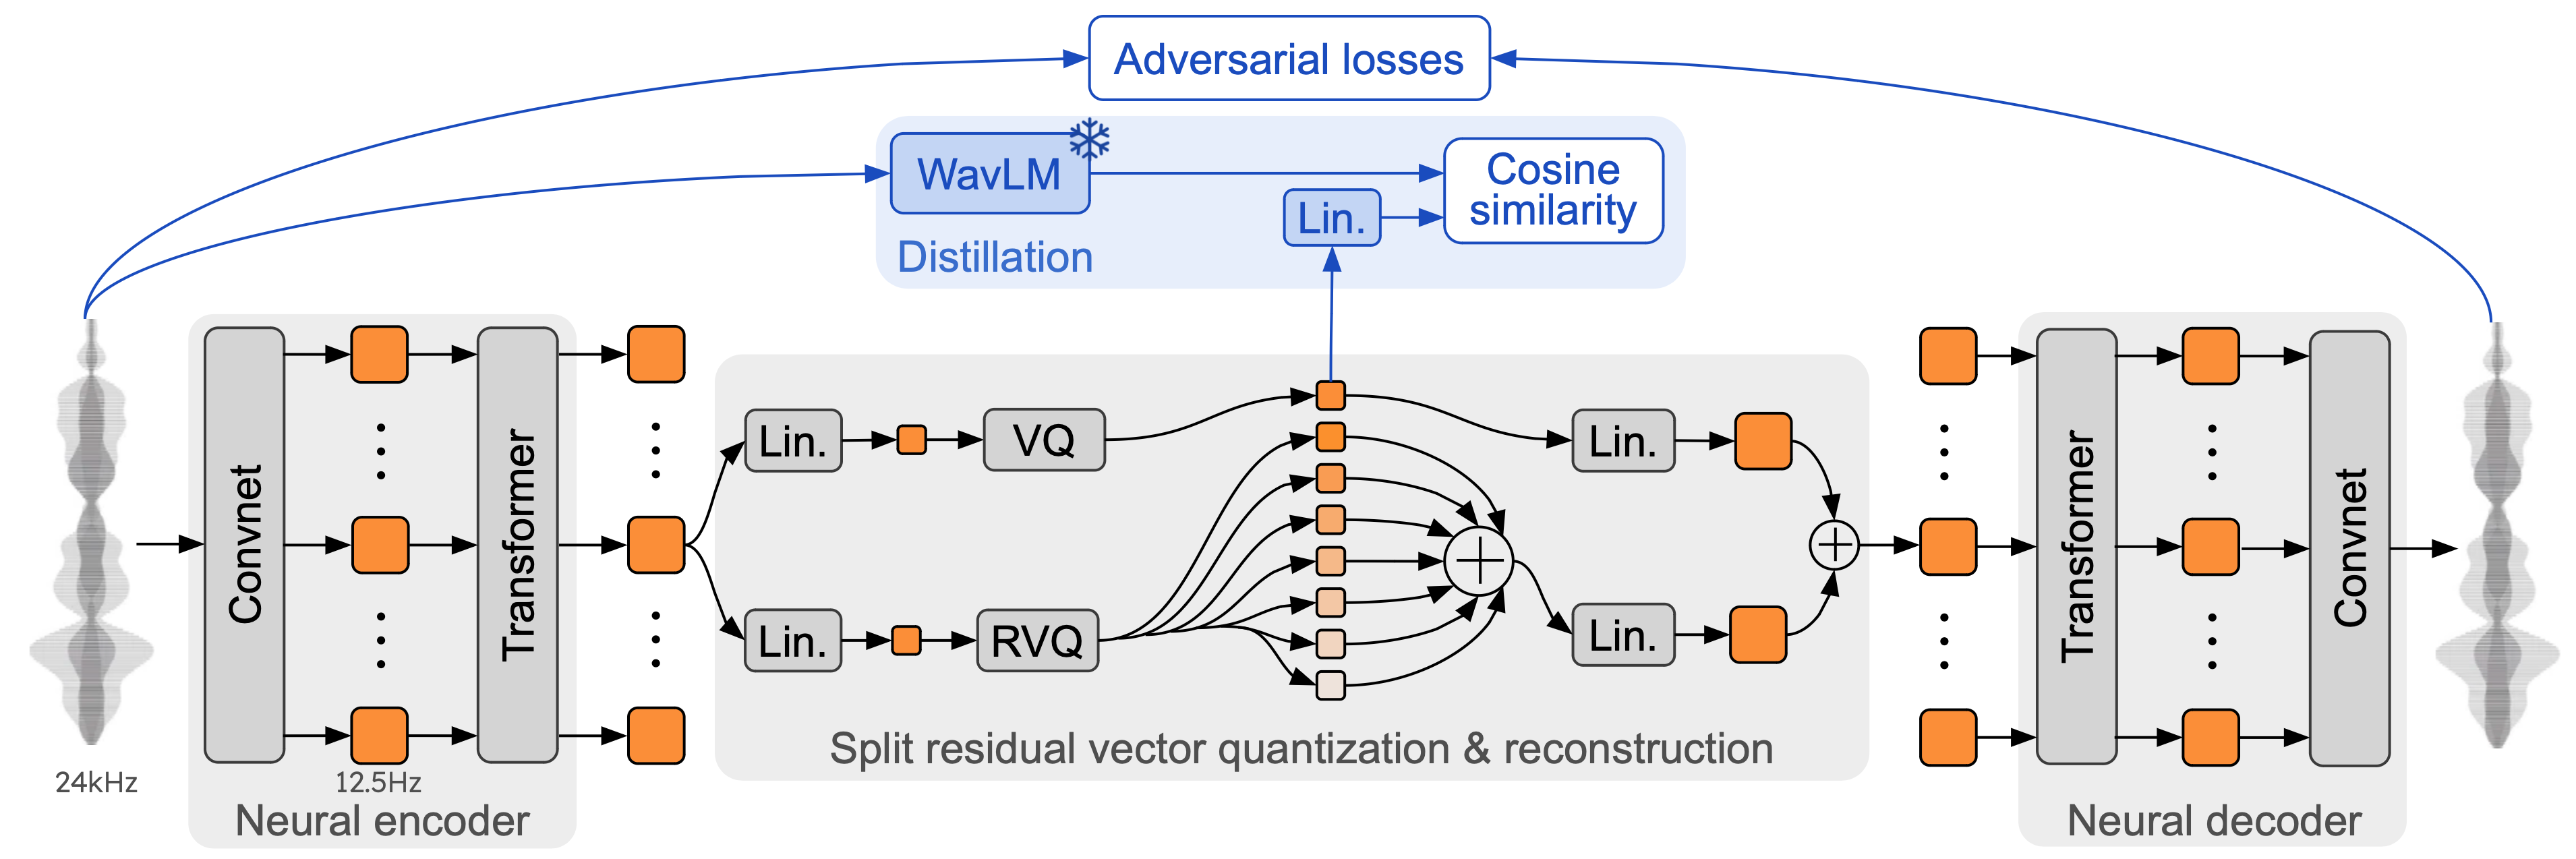
Нейронный аудиокодек Mimi:Mimi — это компонент обработки аудио в Moshi. Это нейросетевой аудиокодек, отвечающий за преобразование аудио в дискретные речевые метки и способный обратно генерировать высококачественный речевой выход.
Mimi использует технологию остаточного векторного квантования (RVQ) для кодирования речевых данных в дискретные речевые и семантические метки, обеспечивая высокую верность голоса и языковую согласованность.
Благодаря сочетанию семантических и акустических меток Mimi способен не только генерировать естественную речь, но и обрабатывать сложный речевой контекст и эмоциональную информацию.
Метод внутреннего монолога:Метод внутреннего монолога является ключевой технологией генерации речи в Moshi, позволяющей модели предсказывать текстовые метки, синхронизированные с аудио, до генерации самой речи. Этот метод не только повышает языковое качество сгенерированной речи, но и позволяет Moshi реализовать функции распознавания речи и преобразования текста в речь в потоковой среде.
Синхронная генерация текста и речи: перед генерацией аудио Moshi создаёт поток текста, соответствующий его речевому выходу. Этот текстовый поток служит основой для генерации речи, делая её более точной и помогая обрабатывать сложные сценарии диалога.
Совместимость с потоковой передачей: этот метод позволяет Moshi обрабатывать речь, сохраняя при этом эффективное распознавание речи и преобразование текста в речь (TTS) в потоковой среде.
Архитектура модели спроектирована для обработки нескольких параллельных аудиопотоков и генерации речи и текста в реальном времени. Moshi может генерировать системную речь одновременно с обработкой речи пользователя, что позволяет поддерживать непрерывный естественный диалог.
Подробные технические методы Moshi
1. Архитектура генерации «речь-в-речь»
Ключевая инновация Moshi заключается в рассмотрении голосового диалога как задачи генерации «речь-в-речь», а не традиционного многокомпонентного процесса «текст-в-речь-в-речь». Традиционные системы голосового диалога включают несколько отдельных модулей: обнаружение голосовой активности (VAD), распознавание речи (ASR), понимание естественного языка (NLU), генерация естественного языка (NLG) и преобразование текста в речь (TTS).
Moshi напрямую генерирует речевые метки, благодаря чему речь при понимании и генерации не зависит от промежуточного текстового представления, что позволяет избежать потери информации (например, эмоций, тона и невербальных звуков).
2. Текстовая языковая модель Helium
Moshi основана на текстовой языковой модели Helium — крупной модели генерации текста с 7B параметров. Helium предварительно обучен на 2,1 триллиона английских данных и обладает мощными возможностями понимания, рассуждения и генерации языка. Он составляет семантическую основу Moshi и поддерживает сложные функции обработки естественного языка, включая открытый диалог и ответы на вопросы.
Основные особенности Helium:
Авторегрессионная архитектура Transformer: Moshi основана на Helium — текстовой языковой модели на базе архитектуры Transformer. Как и классический Transformer, Helium использует многослойные механизмы внимания и методы авторегрессионного моделирования для обработки текстового ввода и генерации вывода. Модель имеет 7B параметров, чего достаточно для обучения на крупномасштабных корпусах.
RMS-нормализация: применяется в модулях внимания, прямого распространения и выходном слое, повышая стабильность обучения модели.
Вращательное позиционное кодирование (RoPE): используется для обработки более длинных контекстных окон (4096 токенов), чтобы модель могла улавливать долгосрочные зависимости в диалоге.
Эффективный FlashAttention: за счёт оптимизированного вычисления внимания повышается эффективность логического вывода модели при длинных входных последовательностях.
3. Нейронный аудиокодек Mimi
Mimi — это нейронный аудиокодек, используемый в Moshi для обработки речи. Его задача — дискретизировать непрерывные речевые сигналы в аудиометки. Эти дискретные аудиометки аналогичны текстовым меткам и могут представлять детальную информацию в речи. Mimi использует технологию остаточного векторного квантования (RVQ), сохраняя высококачественное аудио при низком битрейте и поддерживая генерацию и обработку речи в реальном времени.
Ключевые технологии Mimi:
Остаточное векторное квантование (RVQ): Mimi использует многоуровневое остаточное векторное квантование для дискретизации сложных аудиосигналов в аудиометки нескольких уровней. Этот метод позволяет эффективно кодировать семантическую и акустическую информацию речи на каждом временном шаге, обеспечивая при этом качество восстановления аудио.
Сочетание семантических и акустических меток: используемые Mimi аудиометки включают семантическую и акустическую информацию. Семантические метки сохраняют содержание речи (например, конкретные произнесённые слова), тогда как акустические метки описывают аудиохарактеристики голоса, такие как тембр, эмоции и интонация.
Потоковое кодирование и декодирование: Mimi поддерживает потоковую передачу, обеспечивая непрерывную генерацию и распознавание речи в диалогах в реальном времени. Это делает скорость отклика Moshi очень близкой к скорости естественного разговора.
4. Архитектура RQ-Transformer
Moshi использует многоуровневую потоковую архитектуру генерации, которая позволяет параллельно обрабатывать несколько аудиопотоков. Moshi моделирует одновременно голосовой поток пользователя и собственный голосовой поток системы, обеспечивая гибкое взаимодействие в диалоге и допуская сложную динамику разговора, такую как перекрестные реплики, перебивания и междометия между говорящими.
Это ранее предложенная архитектура для дискретной генерации изображений, которая позволяет моделировать иерархию семантических и акустических токенов без увеличения длины последовательности Helium. Это означает, что для каждой секунды аудио достаточно всего 12,5 проходов через 7B базовую модель, чтобы работать в реальном времени на L4 или Macbook Pro M3! В сочетании с задержкой токенов из MusicGen это обеспечивает самые современные характеристики для аудио-языкового моделирования.
Иерархическое авторегрессионное моделирование: Moshi использует RQ-Transformer (Residual Quantizer Transformer) для разложения аудио токенов на несколько уровней и генерации аудио с помощью иерархического авторегрессионного моделирования. В частности, модель сначала использует более крупный Temporal Transformer для обработки временной последовательности, а затем применяет меньший Depth Transformer для обработки нескольких подпоследовательностей на каждом временном шаге. Такая конструкция значительно повышает эффективность генерации длинных аудиопоследовательностей.
Мультимодальная генерация последовательностей: модель одновременно генерирует несколько последовательностей (включая текст, семантические токены и аудио токены) и обеспечивает их точное временное выравнивание с помощью механизма внутреннего монолога. Содержимое, генерируемое на каждом временном шаге, включает не только текущую речь, но и соответствующий текстовый префикс, что делает генерируемую речь более логически связной по смыслу.
Architecture of RQ-Transformer
5. Механизм «внутреннего монолога»
Механизм «внутреннего монолога» Moshi является одним из ключевых инноваций в генерации речи. Благодаря этому механизму Moshi предсказывает соответствующие временно выровненные текстовые токены перед генерацией аудио. Это не только повышает языковую согласованность генерируемой речи, но и поддерживает распознавание речи в реальном времени (ASR) и преобразование текста в речь (TTS).
Особенности механизма «внутреннего монолога»:
Выровненная генерация текста и аудио: Moshi сначала предсказывает текст, а затем генерирует аудио, благодаря чему синтезированная речь становится более точной и плавной в грамматике и содержании.
Механизм задержки: вводя задержку между текстом и аудио, Moshi может выполнять задачи ASR и TTS по отдельности. Например, если сначала генерируется текст, а затем аудио, модель работает в режиме TTS; иначе — в режиме ASR. Moshi может бесшовно переключаться между этими двумя режимами, гарантируя, что модель способна как генерировать, так и распознавать речь.
Moshi: Delay mechanism
Moshi: TTS mode
6. Многоуровневое потоковое моделирование
Архитектура Moshi позволяет одновременно обрабатывать несколько аудиопотоков, отслеживая как речь пользователя, так и генерируя собственную речь системы. В ходе диалога Moshi может динамически обрабатывать перекрывающиеся участки аудио (например, перебивания, перекрестные реплики) без необходимости явного предварительного разделения ходов говорящих. Эта технология делает разговор более естественным.
Синхронная генерация семантических и акустических токенов: Moshi использует механизм параллельной генерации семантических и акустических токенов, оптимизируя зависимости между ними путем введения временной задержки. Точно моделируя аудиопотоки пользователя и системы, Moshi способен гибко справляться со сложными сценариями диалога.
Двухпотоковая обработка аудио: Moshi одновременно обрабатывает речевые потоки пользователя и системы, реализуя полнодуплексный разговор посредством параллельного моделирования двух авторегрессионных аудиопотоков. Такая конструкция позволяет модели справляться с перекрывающейся речью и перебиваниями, характерными для естественного диалога.
Задержка выравнивания семантики и аудио: введение задержки между семантическими и акустическими токенами обеспечивает связность и эффективность генерируемой речи. Задержка может составлять от 1 до 2 кадров в зависимости от динамики разговора.
Moshi: Multi-stream modeling
7. Обучение и дообучение модели
Крупномасштабное предобучение: текстовая языковая модель Moshi (Helium) была предобучена на более чем 2,1 триллиона английских токенов и обладает богатыми возможностями понимания и генерации языка. Модель обучена на крупных массивах текстовых и речевых данных и способна справляться с различными сложными сценариями диалога.
Многоэтапное обучение без учителя и с учителем: Moshi сначала проходит предобучение на крупномасштабных неразмеченных речевых данных, затем постобучение на многопотоковых данных, содержащих естественный диалог, и, наконец, дообучение на инструкциях, что улучшает её поведение в реальных разговорах.
Предобучение Helium: сначала модель текстового языка Helium предобучается на крупных текстовых наборах данных для повышения её способностей к пониманию и рассуждению на естественном языке.
Предобучение Moshi: многопотоковая аудио-модель обучается на неразмеченных аудиоданных для обработки генерации речи и понимания семантики.
Многопотоковое дообучение: модель дообучается на наборе данных Fisher (содержащем данные двухканальных речевых диалогов) для повышения способности обработки многопотоковых речевых входов.
Инструкционное дообучение: наконец, дообучение проводится на сгенерированных данных диалогов с инструкциями для улучшения производительности модели в сценариях естественного разговора.
Аугментация данных: в процессе обучения Moshi использует методы аугментации данных, такие как добавление фонового шума, моделирование эха пользователя и т.д., что позволяет модели стабильно работать в различных акустических условиях и повышает её устойчивость.
Оценка производительности Moshi
1. Качество и согласованность генерации речи
Чёткость речи: Moshi демонстрирует превосходные результаты в генерации речи; эксперименты показывают, что она способна создавать высококачественную и легко понимаемую речь. Она поддерживает связность речи в процессе генерации, особенно в длительных диалогах, что является важным показателем производительности моделей диалога в сложных контекстах.
Естественность и согласованность речи: благодаря использованию нейронного аудиокодека Mimi Moshi может генерировать высококачественную речь и поддерживать согласованность голоса системы. Кроме того, модель способна генерировать подходящую эмоциональную интонацию в зависимости от контекста разговора, повышая естественность пользовательского опыта.
2. Производительность отклика в реальном времени
Низкая задержка: теоретическая задержка Moshi составляет 160 миллисекунд, а в реальных тестах — около 200 миллисекунд. Это означает, что Moshi может почти в реальном времени реагировать на ввод пользователя, значительно повышая плавность взаимодействия и качество диалога.
Возможность полнодуплексной связи: в ходе тестирования Moshi продемонстрировала способность одновременно принимать и генерировать речь. Эта функция полнодуплексной связи позволяет ей обрабатывать перекрывающуюся речь и перебивания, показывая скорость отклика, близкую к естественному человеческому диалогу.
3. Распознавание речи и понимание диалога
Автоматическое распознавание речи (ASR): благодаря методу внутреннего монолога Moshi объединяет текстовые и речевые потоки, значительно повышая точность распознавания речи. Модель не только фиксирует речевой ввод пользователя, но и повышает точность реакции системы за счёт предварительного предсказания текста.
Способности к пониманию и рассуждению в диалоге: Moshi использует языковую модель Helium для понимания текста и рассуждений, что обеспечивает хорошие результаты при работе со сложными вопросами, открытыми диалогами и ответами на вопросы на основе знаний. Экспериментальные результаты показывают, что Moshi способна эффективно понимать контекст и предоставлять обоснованные ответы.
4. Устойчивость обработки многопотоковой речи
Обработка перекрывающейся речи: Moshi способна обрабатывать сложные сценарии диалога, такие как перекрытие нескольких речевых потоков, во время оценки. Это очень важно для многозадачности в реальных приложениях, поскольку естественный разговор обычно включает перебивания и перекрывающуюся речь.
Обработка диалогов в нескольких контекстах: Moshi обучена на нескольких потоках данных и способна хорошо работать в различных сценариях диалога, будь то речевой поток одного пользователя или одновременный разговор с несколькими пользователями.
5. Ответы на вопросы и извлечение знаний
Moshi превосходит другие современные системы речевого диалога в задачах ответов на вопросы и извлечения знаний. Благодаря мощным возможностям понимания текста и генерации речи в реальном времени Moshi может вести многоэтапные диалоги в формате вопрос-ответ, точно извлекая вопросы пользователя и предоставляя на них ответы.
Языковые рассуждения и вопросы на основе здравого смысла: модель способна справляться со сложными задачами на рассуждение и показывает хорошие результаты в различных стандартных оценках обработки естественного языка (NLP), таких как вопросы на основе здравого смысла, понимание прочитанного и открытые вопросы.
6. Эмоциональная и персонализированная генерация речи
Эмоциональная генерация речи: Moshi продемонстрировала в оценках способность генерировать эмоциональную речь. Она способна создавать речевой вывод с различными эмоциями, такими как гнев, радость или грусть, в зависимости от контекста разговора.
Персонализированный стиль речи: благодаря инструкционному дообучению в процессе обучения Moshi может генерировать речь в различных стилях или с определёнными ролевыми характеристиками в соответствии с потребностями пользователя. Эта возможность персонализации делает её поведение более разнообразным в конкретных сценариях диалога.
7. Безопасность и надёжность
Оценка безопасности диалога: Moshi демонстрирует хорошую безопасность при работе с диалогами, содержащими чувствительный или неуместный контент. Она способна эффективно распознавать и избегать генерации неуместного контента, обеспечивая безопасность и этичность диалога.
Устойчивость и адаптация к шумовой среде: в оценках в условиях шума и сложной обстановки Moshi показала хорошую устойчивость. Благодаря методам аугментации данных (таким как добавление шума и обработка эха) модель способна справляться с различными акустическими средами и гарантировать высокое качество вывода в шумных условиях.
8. Общие результаты тестирования
Комплексные тесты производительности Moshi показывают, что она достигла ведущих результатов в генерации речи, понимании диалога, отклике в реальном времени и обработке сложных диалогов. В частности, Moshi значительно превосходит традиционные системы диалога в обработке перекрывающихся разговоров, перебиваний речи и генерации эмоций.
Технический отчёт: https://kyutai.org/Moshi.pdf
GitHub: https://github.com/kyutai-labs/moshi
Скачать модель: https ://huggingface.co/collections/kyutai/moshi-v01-release-66eaeaf3302bef6bd9ad7acd
Попробовать онлайн: https://moshi.chat/
Связанные новости:














