
 Помощник сценариста▸
 AI Приложения
 AI Новости
StoryDiffusion: создание связных историй в изображениях и видео, а также комиксов
StoryDiffusion: создание связных историй в изображениях и видео, а также комиксовОписание
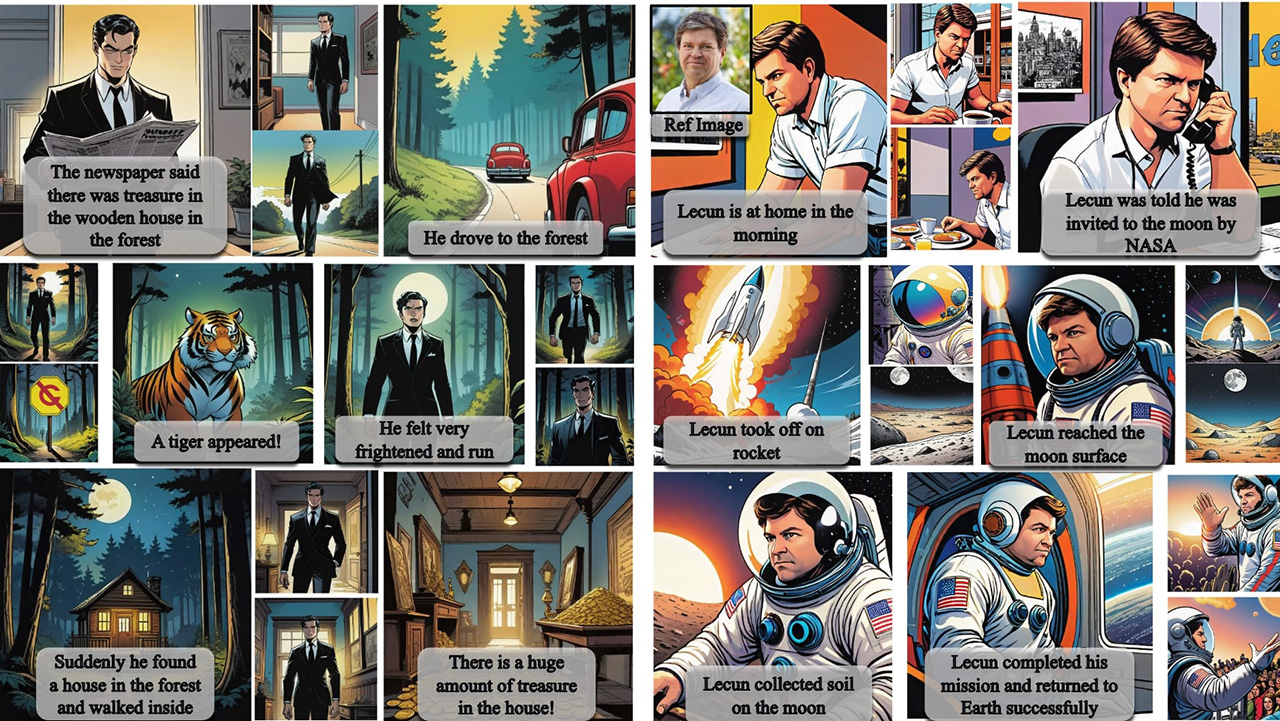
StoryDiffusion — это инструмент искусственного интеллекта, разработанный командой HVision из Университета Нанкай, который служит инструментом для создания видео-историй, а также для генерации комиксов. Основные функции StoryDiffusion включают создание связных изображений и видеоисторий. StoryDiffusion использует технологию Consistent Self-Attention (согласованного само-внимания), которая позволяет генерировать изображения с единой тематикой без необходимости обучения, и эти изображения могут использоваться для повествования историй или в качестве входных данных для дальнейшей генерации контента.
StoryDiffusion способен сохранять согласованность персонажей, генерировать многокадровые комиксы и длинные видеоролики, что особенно важно для таких областей, как реклама и кинематограф, где требуется связное повествование.
Основные функциональные характеристики StoryDiffusion:
Сохранение согласованности персонажей: StoryDiffusion способен генерировать тематически единообразные изображения и видео с помощью механизма согласованного само-внимания, обеспечивая единообразие стиля и одежды персонажей в многокадровых комиксах и длинных видеороликах для связного повествования.
Многосценарное применение: этот инструмент подходит не только для генерации комиксов, но и для различных сценариев, таких как преобразование изображений в видео. Пользователи могут предоставить серию условных изображений и с помощью модели Image-to-Video генерировать видео, что открывает новые возможности для творчества и производства в рекламе и кинематографе.
Разработка учебных материалов: преподаватели могут использовать StoryDiffusion для создания учебных видео или интерактивных историй, которые помогают повысить вовлечённость и интерес учащихся.
Генерация изображений большой протяжённости: особенно подходит для создания связных рекламных историй и укрепления имиджа бренда. Эта функция даёт StoryDiffusion значительное преимущество в рекламе и продвижении брендов.
Подключаемый модуль без обучения: исследовательская группа интегрировала согласованное само-внимание в архитектуру U-Net существующих моделей генерации изображений и повторно использовала исходные веса само-внимания, сохраняя тем самым возможности plug-and-play и отсутствие необходимости в обучении.
Высокая производительность и устойчивость: StoryDiffusion не только сохраняет характеристики персонажей, но и хорошо соответствует текстовым описаниям, демонстрируя свою устойчивость. Это говорит о том, что метод достигает наилучших результатов по количественным показателям.
Благодаря механизму согласованного само-внимания StoryDiffusion способен не только генерировать связные изображения и видео, но и применяться в различных практических сценариях, таких как образование, реклама и развлечения, обладая при этом высокой производительностью и устойчивостью.
Проект на GitHub: соответствующий проект уже получил 1k звёзд на GitHub, адрес GitHub: https://github.com/HVision-NKU/StoryDiffusion.
Статья и демонстрация: более подробные технические детали и результаты экспериментов по StoryDiffusion можно найти в статье «StoryDiffusion: Consistent Self-Attention for long-range image and video generation», адрес статьи: https://arxiv.org/pdf/2405.01434v1














