
 Asistente de guiones▸
 Apps AI
 Noticias AI
DreamTalk: framework de código abierto para hacer que las fotos de personas hablen
DreamTalk: framework de código abierto para hacer que las fotos de personas hablenIntroducción
DreamTalk, un framework basado en modelos de difusión desarrollado conjuntamente por la Universidad de Tsinghua, Alibaba y la Universidad de Ciencia y Tecnología de Huazhong, que permite que las fotografías de personas hablen. Es compatible con varios tipos de sonido para que los retratos hablen, incluyendo canciones, voces en múltiples idiomas y audio con ruido.
Dirección de demostración de DreamTalk:https://dreamtalk-project.github.io
Dirección del proyecto DreamTalk:https://dreamtalk-project.github.io/
Dirección del artículo de DreamTalk:https://arxiv.org/abs/2312.09767
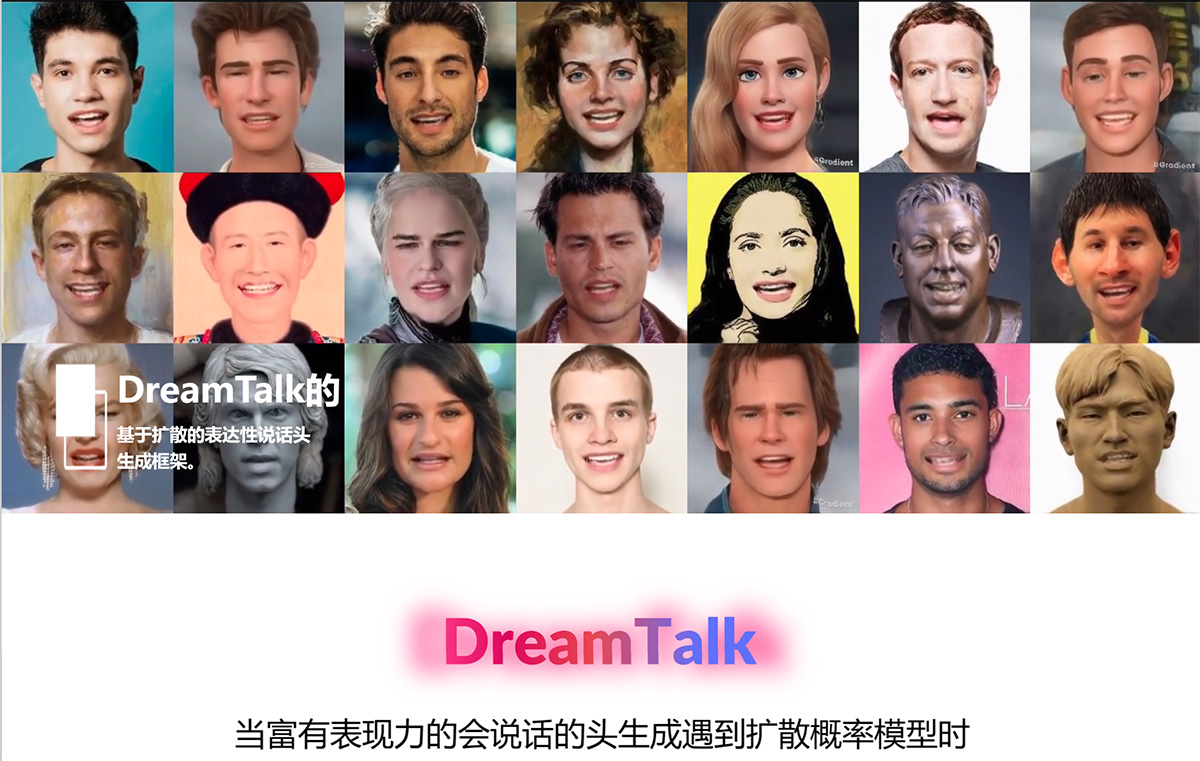
Casos de uso de DreamTalk:
Uso de DreamTalk para generar rostros parlantes con diversos idiomas y estilos de expresión
Aplicación de DreamTalk en la producción cinematográfica para lograr expresiones y movimientos realistas de personajes virtuales
Uso de DreamTalk en escenarios de interacción persona-ordenador para lograr expresiones faciales y movimientos de labios naturales
Funciones de DreamTalk:
En concreto, DreamTalk consta de tres componentes clave: una red de eliminación de ruido, un experto en labios con conciencia de estilo y un predictor de estilo. La red de eliminación de ruido basada en difusión es capaz de sintetizar de forma coherente movimientos faciales de alta calidad impulsados por audio en distintas expresiones. Para mejorar la expresividad y precisión de los movimientos de los labios, introducimos un experto en labios con conciencia de estilo que puede guiar la sincronización labial prestando atención al estilo del habla. Para eliminar la necesidad de vídeos de referencia de expresiones o texto, se utiliza un predictor de estilo adicional basado en difusión que predice directamente la expresión objetivo a partir del audio.
1. Red de eliminación de ruido: este es uno de los componentes principales, responsable de generar los movimientos faciales impulsados por audio. La red de eliminación de ruido utiliza un modelo de difusión para eliminar progresivamente el ruido y generar expresiones faciales claras y de alta calidad. Este proceso consiste en recuperar gradualmente movimientos faciales claros a partir de datos con ruido.
2. Experto en labios con conciencia de estilo: este componente se centra en mejorar la expresividad y precisión de los movimientos de los labios. Analiza el estilo del habla para guiar la sincronización labial, garantizando que la animación generada sea natural y se ajuste al estilo del hablante.
3. Predictor de estilo: para eliminar la dependencia de vídeos de referencia de expresiones o texto, DreamTalk introduce un predictor de estilo basado en difusión. Este predictor puede predecir la expresión objetivo directamente a partir del audio, sin necesidad de vídeos o texto de referencia de expresiones adicionales.
4. Procesamiento de audio y vídeo: procesa la entrada de audio, extrae características clave de audio y utiliza dichas características para impulsar la animación facial. Al mismo tiempo, también puede procesar la entrada de vídeo para extraer e imitar expresiones y estilos específicos.
5. Datos y entrenamiento del modelo: para lograr estas funciones, DreamTalk necesita una gran cantidad de datos para entrenar su modelo, incluyendo datos de animación facial con diferentes expresiones y estilos de habla. A través de estos datos, el modelo aprende a generar con precisión movimientos faciales que coincidan con el audio de entrada.
DreamTalk puede aprovechar potentes modelos de difusión para generar eficazmente rostros expresivos, reduciendo la dependencia de costosas referencias de estilo. Los resultados experimentales muestran que DreamTalk es capaz de generar rostros parlantes realistas con distintos estilos de habla y lograr movimientos precisos de los labios, superando a los productos同类 más avanzados existentes.
DreamTalk no solo es capaz de procesar y generar los tipos de rostro y expresiones que ha visto durante el proceso de entrenamiento, sino que también puede procesar y generar de forma eficaz tipos de rostro y expresiones que no ha visto antes y que provienen de distintos conjuntos de datos.
Incluye retratos de personas de diferentes etnias, edades y sexos, así como diversas expresiones y emociones.














