
 Помощник сценариста▸
 AI Приложения
 AI Новости
YOLO-World: обнаружение объектов в реальном времени с открытым словарём
YOLO-World: обнаружение объектов в реальном времени с открытым словарёмОписание
YOLO-World — это инструмент обнаружения объектов в реальном времени, разработанный лабораторией ИИ компании Tencent, который способен автоматически распознавать и определять местоположение различных объектов на изображениях. YOLO-World превосходит многие самые современные методы как по скорости, так и по точности.
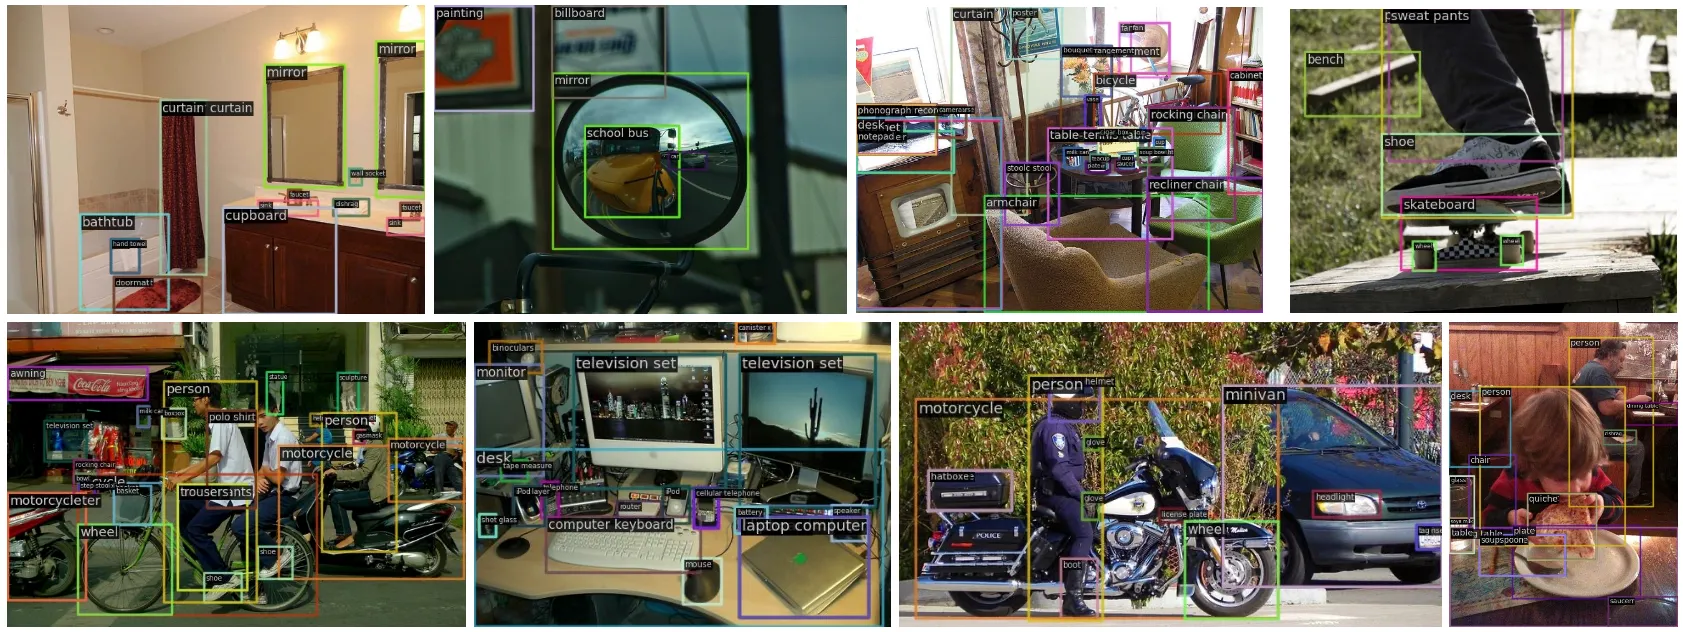
YOLO-World — это детектор следующего поколения семейства YOLO, предназначенный для обнаружения объектов в реальном времени по открытому словарю. YOLO-World был предобучен на крупномасштабных наборах визуально-языковых данных (включая Objects365, GQA, Flickr30K и CC3M), что обеспечивает ему мощные возможности обнаружения с нулевым количеством примеров по открытому словарю и привязки изображений, позволяя выполнять обнаружение объектов в реальном времени без обучения. Даже если некоторые объекты ранее не встречались, YOLO-World подходит для задач обнаружения объектов и сегментации实例 по открытому словарю.
Функциональные особенности YOLO-World:
1. Крупномасштабное обучение: YOLO-World приобретает обширные визуальные и языковые знания, обучаясь на большом количестве изображений и соответствующих описаний (например, названий объектов), что позволяет ему распознавать широкий спектр объектов.
Проект был предобучен на крупномасштабных визуально-языковых наборах данных, включая Objects365, GQA, Flickr30K и CC3M, что наделило YOLO-World мощными возможностями обнаружения с нулевым количеством примеров по открытому словарю и привязки объектов на изображениях.
2. Быстрота и точность: YOLO-World достигает показателя 35,4 AP при оценке с нулевым количеством примеров на наборе данных LVIS и обеспечивает скорость обработки 52,0 FPS на V100, превосходя по скорости и точности многие самые передовые методы. Высокая точность сохраняется даже на изображениях со сложными сценами. YOLO-World заявляет, что работает в 20 раз быстрее, чем GroundingDINO.
3. Обнаружение с нулевым количеством примеров: наиболее впечатляющим является то, что даже если некоторые объекты ранее не встречались YOLO-World, он способен, опираясь на полученные ранее знания и понимание, успешно распознавать и определять местоположение этих новых объектов с помощью визуальных подсказок и контекстной информации на изображении. Это означает, что нам не нужно обучать его, чтобы он обнаруживал новый класс объектов. Достаточно указать имя класса в качестве текстовой подсказки, и модель вернёт ограничивающие рамки этих объектов (при их наличии).
4. Понимание объектов: YOLO-World опирается не только на визуальную информацию, но и использует языковую информацию. Он понимает описания на естественном языке, что позволяет ему распознавать даже те объекты, которые ранее не встречались напрямую.
5. По сравнению с существующими методами обнаружения по открытому словарю модель YOLO-World работает как минимум в 20 раз быстрее. Она способна обрабатывать примерно 52 кадра в секунду.
6. Устанавливает новый передовой результат на наборе данных для обнаружения объектов LVIS.














