
 Asistente de guiones▸
 Apps AI
 Noticias AI
Step-Audio: primer modelo de interacción por voz de código abierto de Stepfun
Step-Audio: primer modelo de interacción por voz de código abierto de StepfunIntroducción
Step-Audio, como el primer modelo de interacción por voz de nivel de producto y código abierto del sector, es capaz de generar expresiones de voz diversificadas según las necesidades del escenario, abarcando emociones, dialectos, idiomas, canto y estilos personalizados, con una interacción natural y fluida. En la evaluación del Examen de Nivel de Chino (HSK) de sexto nivel, Step-Audio tuvo un rendimiento excepcional y fue reconocido como el modelo de código abierto que mejor entiende el chino. Este modelo de ia fue desarrollado conjuntamente por StepFun y el Grupo Automotriz Geely, y fue publicado como código abierto el 18 de febrero de 2025.
Características y funciones de Step-Audio:
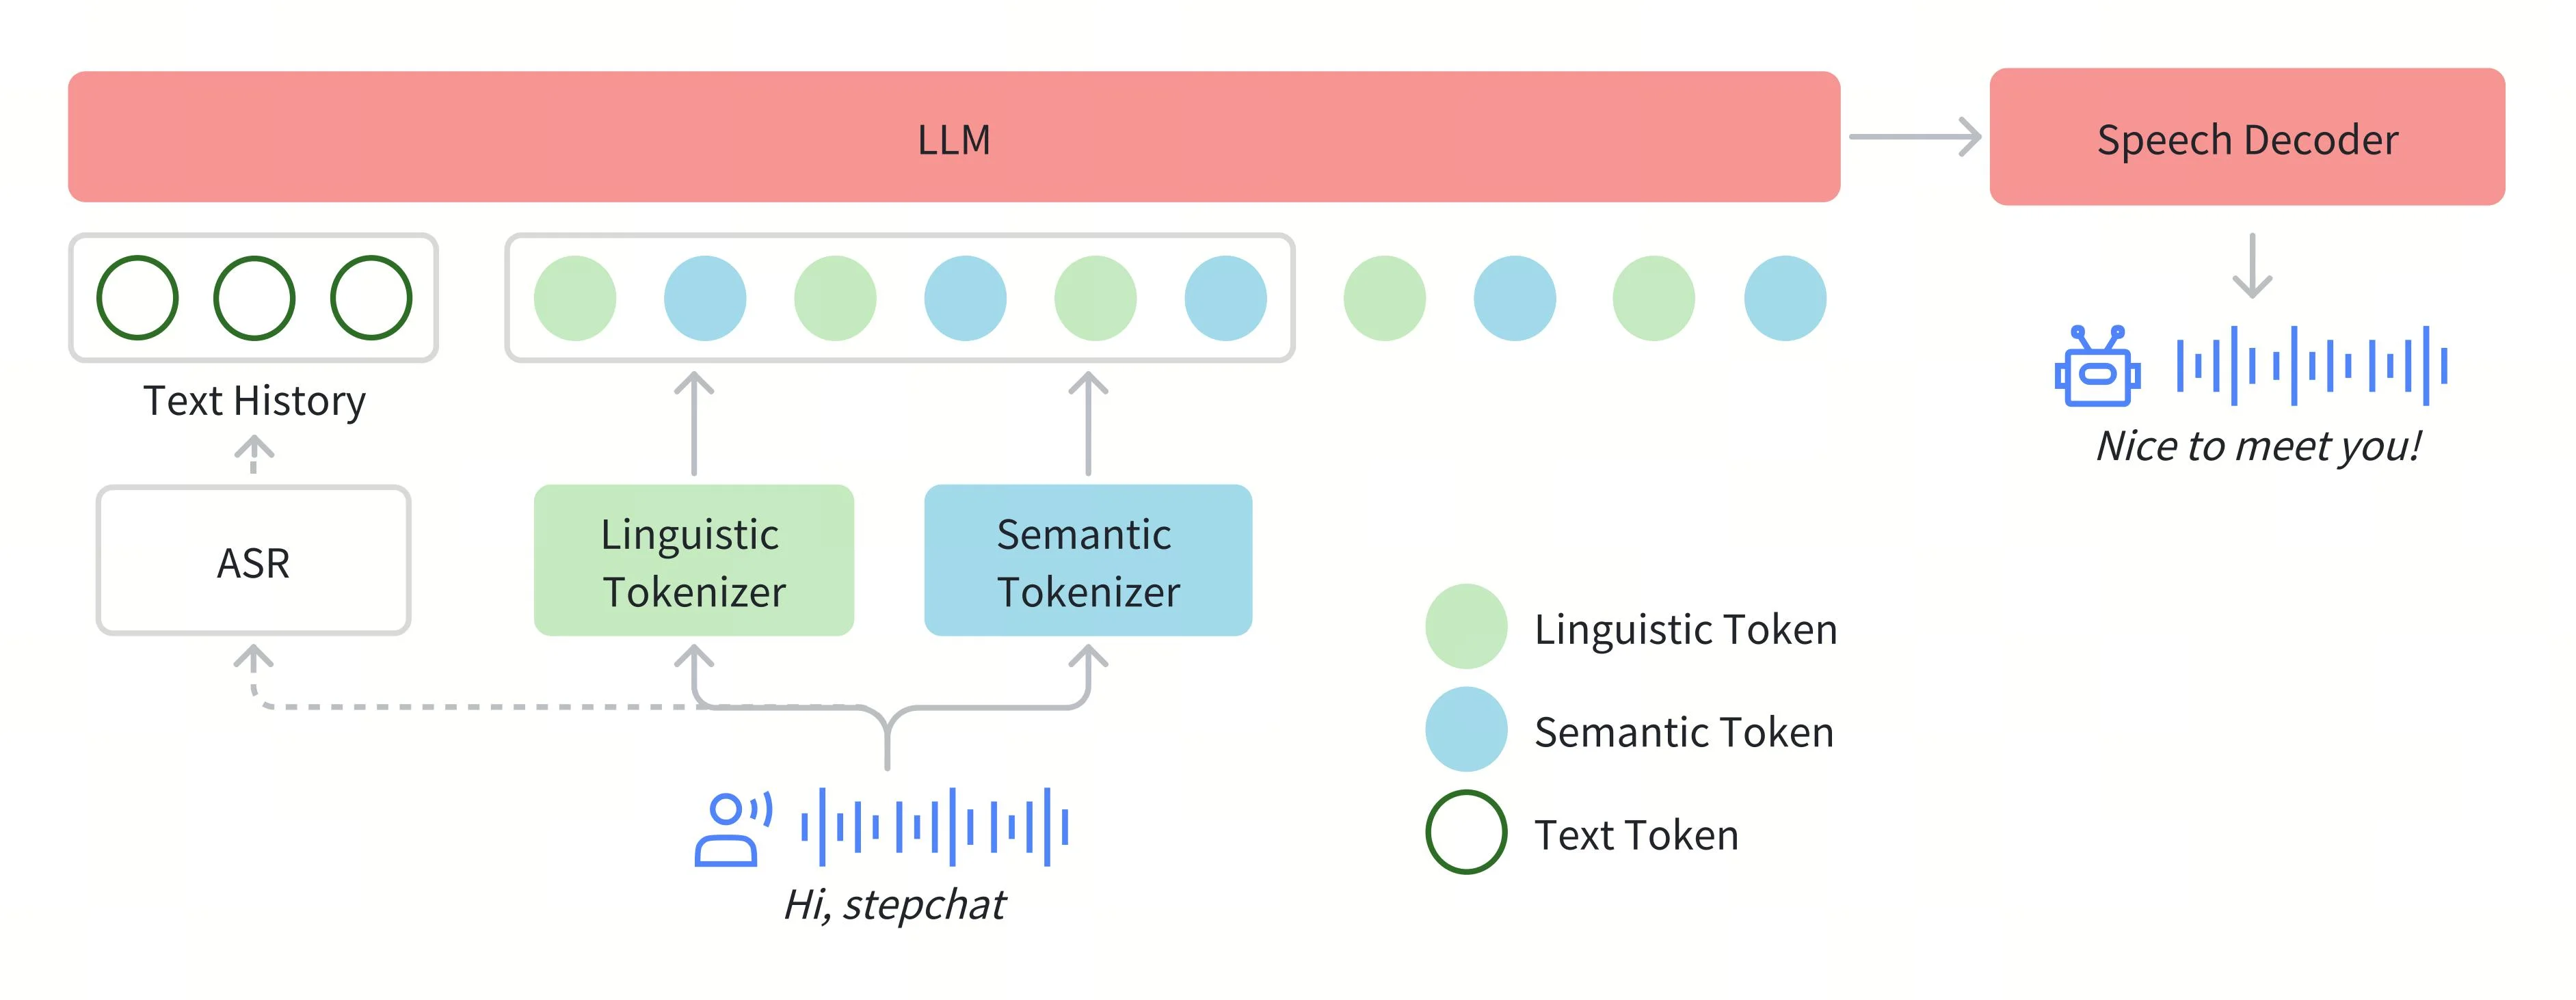
Modelo unificado: basado en un modelo multimodal de 13.000 millones de parámetros, logra la unificación entre la comprensión y la generación de voz, y puede procesar simultáneamente reconocimiento de voz, comprensión semántica, diálogo, clonación de voz, edición y síntesis de audio.
Diversidad de emociones y estilos: genera voces con distintas emociones (enfado/felicidad/tristeza), dialectos (cantonés/sichuanés, etc.), idiomas, cantos (RAP/canturreo) y estilos personalizados según las necesidades, controlando con precisión las emociones, dialectos, idiomas y cantos.
Diálogo de alta calidad: ofrece una experiencia de diálogo natural y de alta calidad, con una interacción tan fluida como una conversación real.
Interacción inteligente: dispone de capacidades avanzadas de interacción como razonamiento lógico, creación, control de instrucciones, lenguaje, interpretación de roles y juegos de texto.
Escenarios de aplicación de Step-Audio:
Atención al cliente inteligente: ofrece servicios personalizados y emocionales, mejorando la experiencia del usuario.
Lectura en voz alta: genera lecturas expresivas que aumentan la inmersión en los audiolibros.
Creación de contenido de vídeo y audio: genera automáticamente locuciones para vídeos o personajes de animación.
PNJ de videojuegos: proporciona interacción por voz natural y fluida para los personajes del juego.
Actas de reuniones: convierte voz a texto en tiempo real y proporciona retroalimentación vocal.
Apoyo educativo: asistente de enseñanza personalizado que adapta el estilo y el tono de la instrucción.
Características técnicas de Step-Audio:
Tecnología de alta compresión: utiliza tecnologías de compresión eficientes como Video-VAE para optimizar el procesamiento de datos.
Capacidad de procesamiento bilingüe: utiliza Hunyuan-CLIP y Step-LLM para procesar instrucciones en chino e inglés.
Arquitectura DIT y algoritmo Video-DPO: optimiza el procesamiento de datos complejos de vídeo y audio.
Entrenamiento con conjuntos de datos a gran escala: se construye un gran conjunto de datos para garantizar la generalización del modelo y el detalle de su rendimiento.
Métodos de uso de Step-Audio:
Obtener el modelo: accede a la versión de código abierto de Step-Audio en plataformas como la APP YueWen o Hugging Face.
Informe técnico: consulta los informes técnicos disponibles en arxiv.org o GitHub para obtener más detalles.
Interfaz API: implementa la interacción por voz mediante llamadas a la API, bajo la licencia de código abierto MIT.
Desarrollo integrado: intégralo en tus aplicaciones siguiendo la documentación oficial o el código de ejemplo.
Entrenamiento personalizado: los usuarios avanzados pueden realizar fine-tuning del modelo para adaptarlo a escenarios específicos o mejorar su rendimiento.
Cómo obtener Step-Audio
GitHub: https://github.com/stepfun-ai/Step-Audio
ModelScope: [Hacer clic para acceder]
Informe técnico: [Hacer clic para acceder]
Compatible con el despliegue con un solo clic en PAI Model Gallery [Hacer clic para acceder]














