
 Помощник сценариста▸
 AI Приложения
 AI Новости
MoshiVis: визуально-речевая модель, которая слушает, видит и обсуждает изображения естественным голосом
小编 ·

MoshiVis: визуально-речевая модель, которая слушает, видит и обсуждает изображения естественным голосом
Что такое MoshiVis?
MoshiVis — это визуально-голосовая модель, разработанная на основе Moshi, которая сохраняет низкую задержку и способность к естественному диалогу, присущие Moshi, и может обсуждать содержимое изображений в стиле естественной беседы. Она поддерживает многотуровый диалог, способна описывать текстовое содержимое изображений и отвечать на вопросы, связанные с изображениями.
Она интегрирует визуальную информацию в речевой поток с помощью механизма перекрёстного внимания, сохраняя при этом низкую задержку и низкое потребление памяти. MoshiVis поддерживает несколько бэкендов (таких как PyTorch, Rust, MLX) и выпускает предобученные модели, а также синтетический набор данных визуального диалога, что делает её пригодной для сценариев голосового взаимодействия в реальном времени.
Ключевые функции MoshiVis
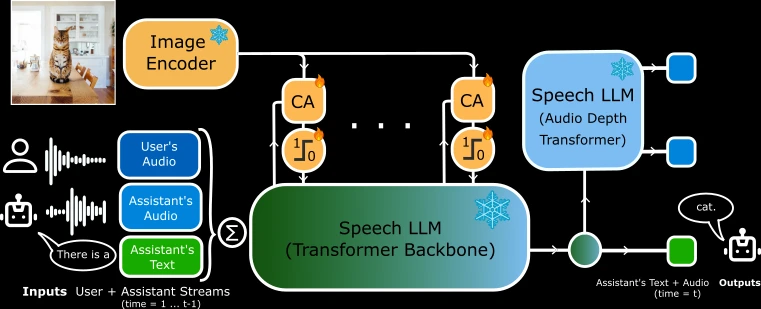
Сочетание визуального и голосового каналов: MoshiVis расширяет Moshi возможностями визуального понимания, позволяя интегрировать информацию об изображении в голосовой диалог. За счёт расширения базовой архитектуры Transformer вводится механизм перекрёстного внимания, посредством которого визуальная информация внедряется в речевой поток.
Низкая задержка и низкое потребление памяти: для сохранения низкой задержки и снижения расхода памяти проектные веса перекрёстного внимания MoshiVis распределяются между слоями, а влияние визуального входного потока регулируется с помощью механизма стробирования (gating).
Естественный стиль диалога: при интеграции визуальных возможностей модель сохраняет свойственный Moshi естественный стиль ведения беседы.
Техническая архитектура MoshiVis
Базовая модель: основана на Moshi — голосово-текстовой базовой модели с 7B параметров.
Визуальный кодировщик: используется предобученный замороженный визуальный кодировщик на 400M параметров из семейства PaliGemma2.
Параметры адаптера: поверх Moshi добавлено около 206M параметров адаптера для обработки визуальной информации.
Механизм перекрёстного внимания: визуальная информация внедряется в речевой поток через модуль перекрёстного внимания, при этом влияние визуального входа регулируется с помощью механизма стробирования.
Выпуск модели MoshiVis
Вариант модели: выпущена модель MoshiVis на основе Moshika (женский голос), включающая полные веса модели, в том числе речевой кодек, текстовый токенизатор, кодировщик изображений и базовую модель Moshi.
Поддержка бэкендов: предоставляется поддержка трёх бэкендов — PyTorch, Rust и MLX, с различными форматами квантования (например, BF16, Q8_0 и др.).
Лицензия: веса модели (за исключением визуального кодировщика) распространяются по лицензии CC-BY 4.0; визуальный кодировщик распространяется по лицензии Gemma.
Как использовать MoshiVis
WebUI-фронтенд: предоставляется WebUI-фронтенд с поддержкой эхоподавления для повышения качества работы модели. Пользователи могут воспользоваться готовой собранной статической версией либо собрать её самостоятельно из исходного кода.
Запуск бэкенда:
PyTorch: требуется около 24 ГБ памяти GPU, квантование не поддерживается.
Rust: поддерживает GPU-ускорение, требуется инструментарий Rust и CUDA (или Metal на macOS).
MLX: поддерживает форматы bfloat16 и квантование (q4, q8).
Команды запуска: предоставлены подробные команды запуска, позволяющие выбирать различные бэкенды и форматы квантования в зависимости от потребностей.
Полезные ссылки:
Репозиторий на GitHub:https://github.com/kyutai-labs/moshivis
Модель на HuggingFace:https://huggingface.co/collections/kyutai/moshivis-v01-67cef4acae6a5d75d6d6c883









