
 Помощник сценариста▸
 AI Приложения
 AI Новости
Umi-OCR: бесплатный открытый офлайн-инструмент OCR для пакетной обработки
小编 ·

Umi-OCR: бесплатный открытый офлайн-инструмент OCR для пакетной обработки
Что такое Umi-OCR?
Umi-OCR — это бесплатный офлайн-инструмент OCR с открытым исходным кодом, разработанный на базе фреймворка PaddleOCR от Baidu. Он поддерживает распознавание текста со скриншотов и пакетный импорт изображений, распознавание PDF-документов, удаление водяных знаков/колонтитулов, сканирование и генерацию QR-кодов, содержит встроенные языковые библиотеки для многих стран и отличается высокой точностью распознавания, работой в офлайне, многоязыковой поддержкой и эффективной пакетной обработкой.
Функциональные особенности Umi-OCR
Офлайн-работа: полностью автономное использование без подключения к сети, что защищает конфиденциальность пользователя.
Многоязыковая поддержка: встроенные языковые библиотеки для многих стран, поддержка распознавания текста на разных языках.
Разнообразные функции распознавания:
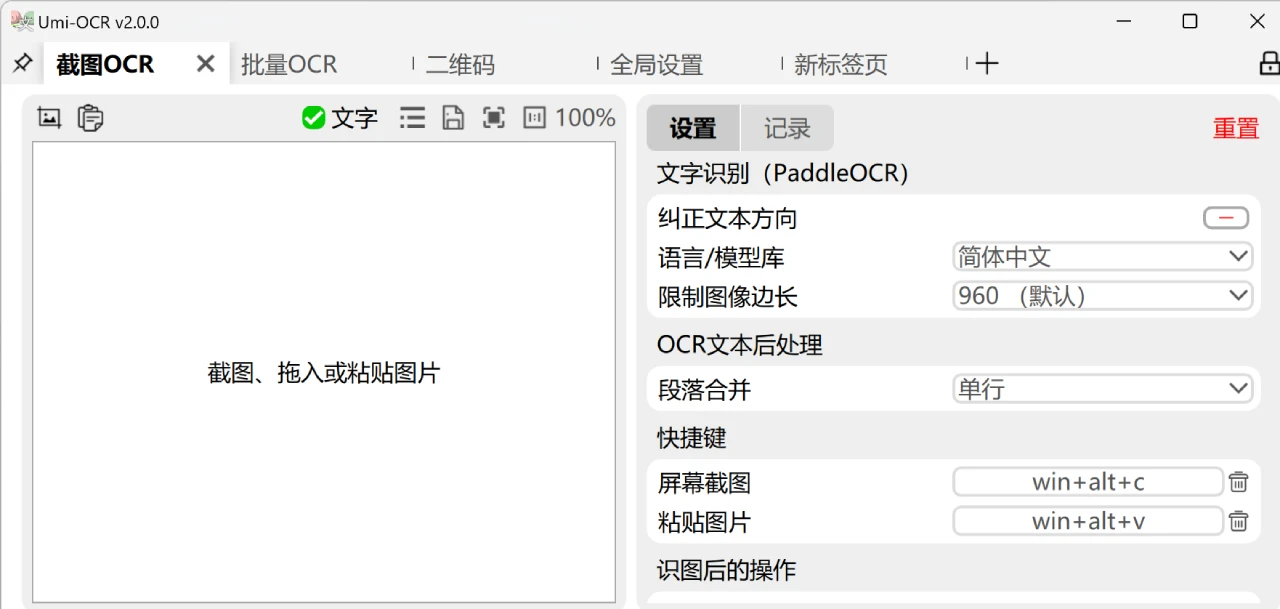
OCR скриншотов: поддержка скриншотов экрана и вставленных изображений для распознавания текста.
Пакетный OCR: возможность пакетного импорта изображений для распознавания текста с поддержкой различных графических форматов.
Распознавание PDF: поддержка извлечения текста из PDF-документов с возможностью исключения колонтитулов и прочего.
Распознавание QR-кодов: поддержка сканирования и генерации QR-кодов.
Распознавание формул: поддержка распознавания математических формул (в тестовом режиме).
Постобработка текста: поддержка форматирования результатов распознавания и исключения мешающего текста.
Гибкий вызов: поддержка вызова через командную строку и HTTP-интерфейс для удобной интеграции разработчиками.
Технические характеристики Umi-OCR
Высокая точность распознавания: встроены несколько языковых моделей, поддерживается распознавание упрощённого и традиционного китайского, английского, японского, корейского и распространённых европейских языков, совместимо с распознаванием текста со смешанной вёрсткой.
Анализ сложной вёрстки: точное распознавание вертикального текста, таблиц и простых математических формул.
Оптимизация изображений низкого качества: предварительная обработка размытых, наклонных и плохо освещённых изображений для повышения точности распознавания.
Эффективная пакетная обработка и гибкий вывод: поддержка перетаскивания папок или пакетного импорта изображений для распознавания сотен файлов в один клик.
Сценарии использования Umi-OCR
Офисные задачи: быстрое извлечение текста из отсканированных PDF и изображений отчётов с преобразованием в редактируемые документы.
Научные исследования: распознавание иностранной литературы и древних текстов для помощи в переводе и цитировании.
Мультимедийная обработка: извлечение текста для видео-скриншотов, перевода манги и игровых субтитров.
Автоматизация процессов: интеграция в другие цепочки инструментов через интерфейс командной строки для пакетной автоматизации OCR.
Загрузка и использование Umi-OCR
Ссылки для скачивания:
Lanzou Cloud (рекомендуется для Китая, без регистрации и без ограничения скорости): https://hiroi-sora.lanzoul.com/s/umi-ocr
GitHub Release: https://github.com/hiroi-sora/Umi-OCR/releases/tag/v2.1.4
Способ установки: распаковать и пользоваться, установка не требуется. Поддерживаются платформы Windows 7 x64 и Linux x64.
Установка через командную строку: установка через Scoop (Windows):
scoop install extras/umi-ocr
Планы на будущее
Рефакторинг механизма плагинов нижнего уровня.
Добавление плагина онлайн OCR API.
Реализация отдельного плагина для распознавания математических формул.
Поддержка перевода изображений и офлайн-перевода.
Совместимость с MacOS и большим количеством дистрибутивов Linux
Ещё один olmOCR, о котором рассказывалось пару дней назад, тоже неплох — если вас в первую очередь интересует конвертация PDF, можно попробовать и его.









