
 Помощник сценариста▸
 AI Приложения
 AI Новости
olmOCR: мощный инструмент OCR с открытым исходным кодом для высокоточной конвертации PDF и документов
小编 ·

olmOCR: мощный инструмент OCR с открытым исходным кодом для высокоточной конвертации PDF и документов
Что такое OLMOCR?
OLMOCR — это инструмент с открытым исходным кодом, способный с высокой точностью преобразовывать файлы PDF в текст. Преобразование сохраняет порядок чтения документа и поддерживает распознавание таблиц, формул и рукописного содержимого, обладая возможностями высокопроизводительной обработки документов, преобразованием текста с сохранением естественного порядка чтения и высокой точностью, снижающей количество ошибок.
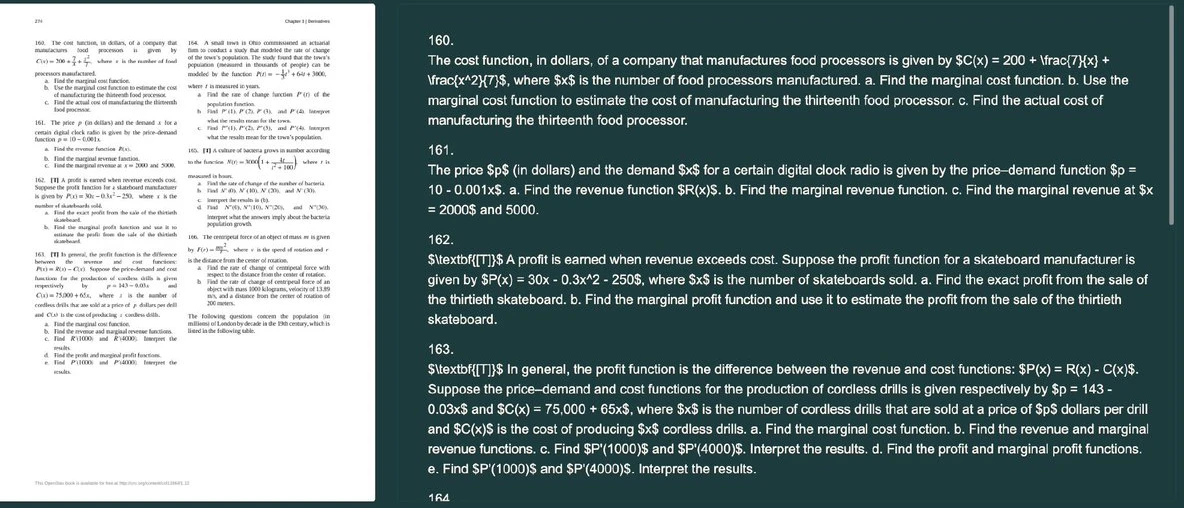
Функции и особенности olmOCR
Высокая точность: OLMOCR предоставляет передовую технологию OCR, обеспечивающую максимальное сохранение точности содержимого в процессе преобразования.
Поддержка различных форматов: этот инструмент может обрабатывать разные типы PDF, включая документы со сложным форматированием.
Набор инструментов для разработки: помимо базовых функций OCR, OLMOCR также включает набор инструментов для линеаризации PDF, удобных для создания наборов данных, подходящих для обучения языковых моделей ai.
Сценарии использования olmOCR
Может использоваться для оцифровки изображений бумажных документов в текст, что удобно для управления документами.
Встроенные функции помогают пользователям извлекать ключевые данные, такие как содержимое таблиц, для последующего анализа и использования.
Подходит для предприятий и исследовательских учреждений, которым требуется массовая обработка документов.
Может применяться в сфере образования для оцифровки экзаменационных материалов и преобразования рукописных заметок.
В медицинской отрасли этот инструмент может использоваться для обработки отсканированных медицинских записей и таблиц.
В юридической сфере может применяться для эффективного управления и поиска юридических документов.
Подходит для исторических исследовательских проектов, где требуется оцифровка и архивирование бумажных документов.
Преимущества olmOCR
Высокоточное распознавание: способность распознавать сложные структуры (такие как таблицы, уравнения и т. д.).
Экономичность: стоимость преобразования PDF составляет всего 190 долларов за миллион страниц.
Возможность крупномасштабной обработки: позволяет выполнять массовое пакетное преобразование файлов.
Совместимость с различным оборудованием: может работать с разными аппаратными конфигурациями.
Предоставление полного комплекта компонентов: включает веса модели, данные и код обучения, предоставляя пользователю гибкий выбор.
Часто задаваемые вопросы об olmOCR
В: Поддерживается ли распознавание рукописного текста?
О: Да, olmOCR может распознавать рукописный текст.
В: Есть ли ограничения на пакетную обработку?
О: olmOCR поддерживает крупномасштабную пакетную обработку и гибко адаптируется к различным аппаратным средам.
В: Предоставляется ли бесплатная пробная версия?
О: Обзор и все компоненты имеют открытый исходный код и доступны на GitHub.
В: Каково среднее время обработки одной страницы PDF?
О: Конкретное время зависит от аппаратной конфигурации, но общие эксплуатационные расходы очень низкие.
В: Какие языки поддерживаются?
О: olmOCR поддерживает множество языков, включая содержимое со сложной структурой.
Онлайн-демонстрация:посетите olmocr.allenai.org
Репозиторий на GitHub:https://github.com/allenai/olmocr









