
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Step-Video-T2V: 최첨단 텍스트-동영상 생성 모델
Step-Video-T2V: 최첨단 텍스트-동영상 생성 모델소개
Step-Video-T2V는阶跃星辰(StepFun)과 吉利汽车가 협력하여 오픈소스로 공개한 첨단 텍스트-투-비디오 생성 모델입니다. 다양한 뛰어난 특성을 갖추고 있어 비디오 생성 분야에서 강력한 역량을 보여줍니다.
Step-Video-T2V 모델의 하이라이트
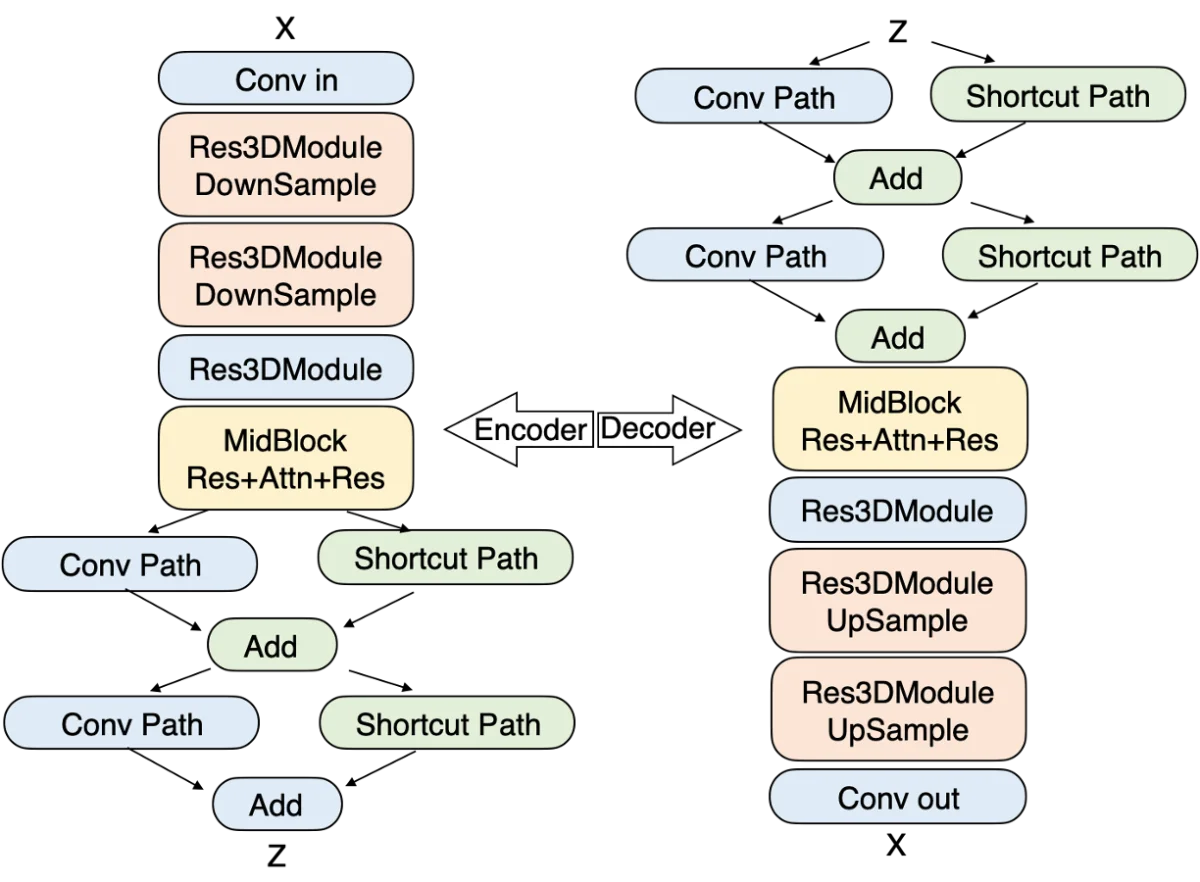
DiT 모델과 플로우 매칭 학습 방식을 활용하여 16×16의 공간 압축과 8배의 시간 압축을 실현함으로써 대규모 비디오 생성의 효율을 크게 향상시켰습니다.
300억 개의庞大 파라미터를 보유하고 있어 해상도 544x992에 이르는 고해상도 고품질 비디오를 생성할 수 있습니다.
중국어와 영어 프롬프트 입력을 지원하여 다양한 언어 배경의 사용자가 이용할 수 있습니다.
Step-Video-T2V의 기능적 특징
대규모 파라미터: 파라미터 수가 300억 개에 달하여 모델에 매우 높은 생성 능력과 정확성을 부여하므로, 텍스트 설명을 보다 정확하게 이해하고 고품질 비디오로 변환할 수 있습니다.
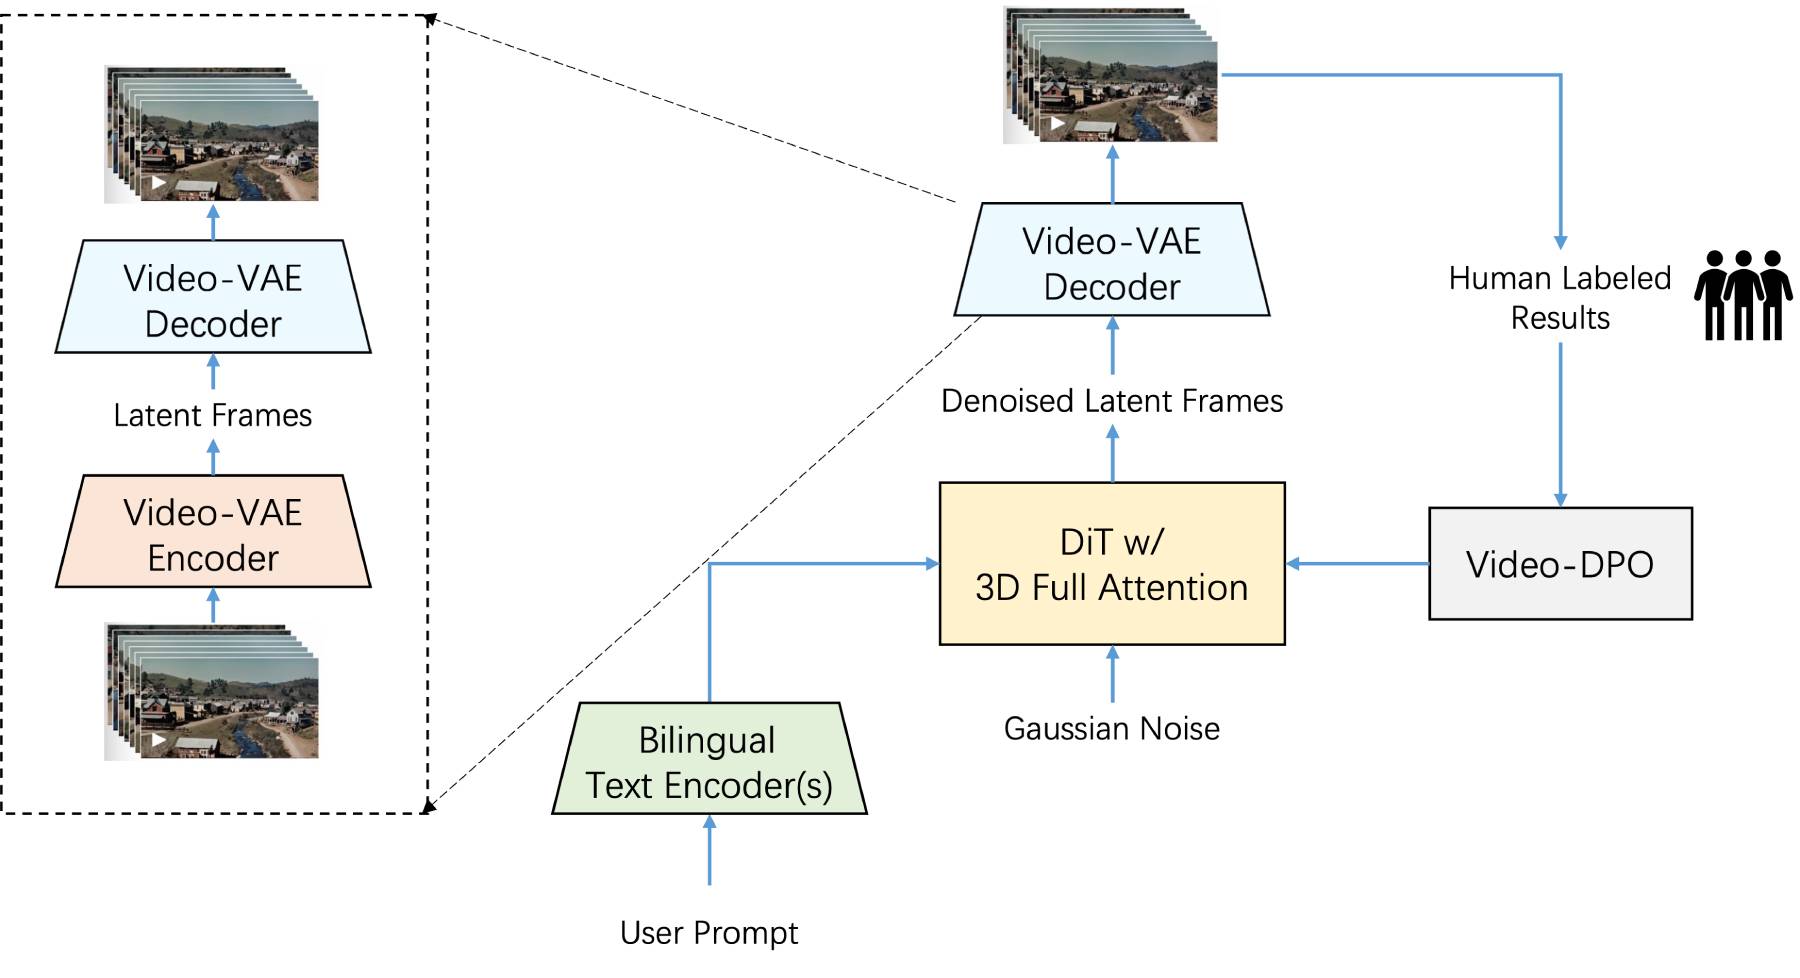
효율적인 비디오 생성: 최대 204프레임(544x992 픽셀)의 고품질 비디오 생성을 지원하여 다양한 창작 수요를 충족합니다. 깊이 압축된 변분 오토인코더(Video-VAE)를 채택하여 16×16의 공간 압축과 8배의 시간 압축을 달성함으로써, 비디오 품질을 보장하는 동시에 학습과 추론 비용을 효과적으로 절감합니다.
이중 언어 텍스트 인코더: 중국어와 영어 입력을 지원하여 텍스트 설명에 부합하는 비디오 콘텐츠를 깊이 있게 이해하고 생성할 수 있으며, 다양한 언어의 사용자가 편리하게 모델을 이용할 수 있게 합니다.
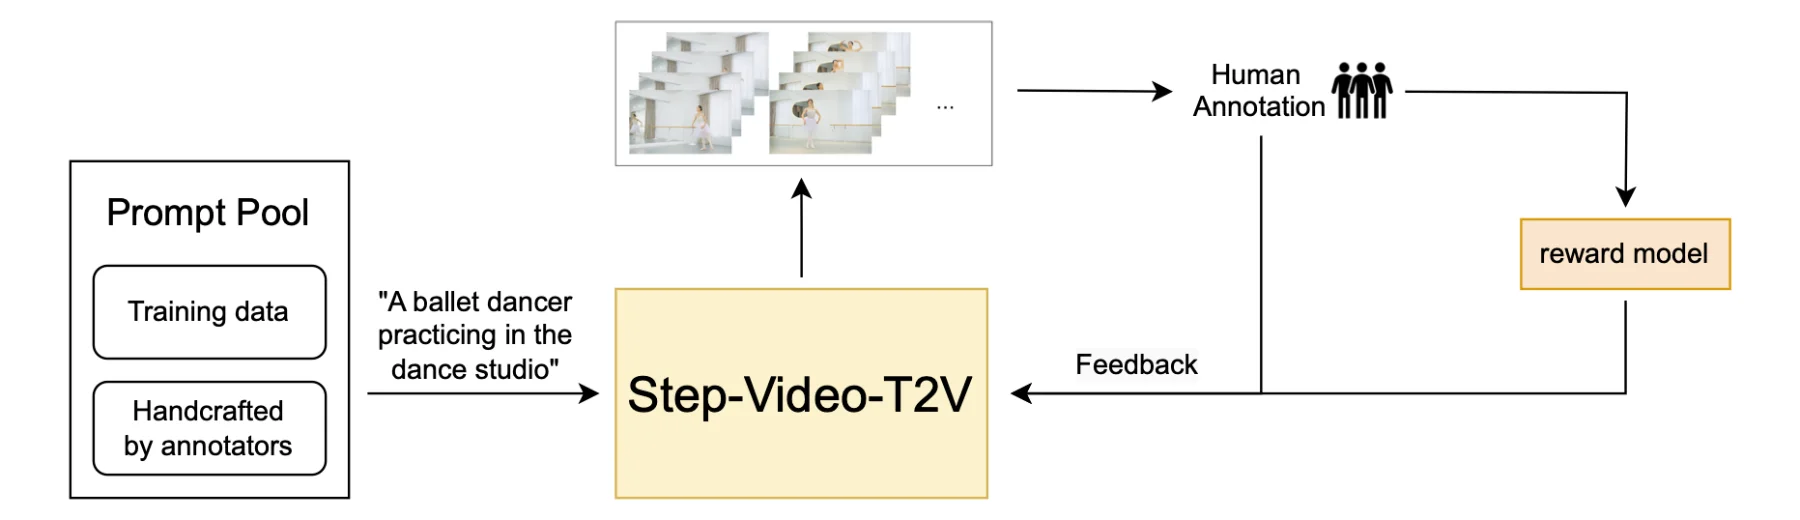
先进的 아키텍처: 3D 풀 어텐션 DiT 아키텍처를 사용하여 동적 해상도 변화에 유연하게 적응하고, 비디오 생성의 안정성과 고품질을 보장합니다. 또한 인간 피드백 메커니즘을 통한 비디오 선호도 최적화(DPO, Direct Preference Optimization)를 도입하여 생성된 비디오의 품질과 부드러움을 한층 더 향상시켜 사용자의 기대에 더 부합하도록 합니다.
다중 모달 융합: 이미지, 음성, 텍스트 세 가지 모달의 이해 능력을 결합하여 생성되는 콘텐츠의 디테일을 더욱 사실적으로 만듭니다. 예를 들어, 생성되는 인물 표정이 더욱 생동감 있고, 빛과 그림자의 변화가 더욱 자연스러우며, 동적 사물의 표현이 더욱 매끄럽고 사실적입니다.
유연한 운영 모드: 베이직 버전(50단계 생성)과 Turbo 버전(15단계 증류 가속)을 제공하여 다양한 사용자의 다양한 시나리오별 성능 요구를 충족합니다. 실제 운영 시 204프레임 비디오를 생성하는 데 대략 80GB显存(VRAM)의 GPU 4개가 필요하며, 약 12분이 소요됩니다.
Step-Video-T2V의 활용 시나리오
크리에이티브 비디오 제작: 비디오 크리에이터가 복잡한 장면과 정교한 크리에이티브 비디오 콘텐츠를 생성할 수 있도록 지원하며, 광고 제작, 쇼츠 비디오 제작等领域에 매우 적합합니다.
애니메이션 및 영화·TV 제작: 애니메이션과 영화·TV 업계에서 고품질의 가상 캐릭터, 동적 장면, 복잡한 동작을 생성하는 데 활용될 수 있습니다.
교육 및 훈련: 상호작용성이 강한 교육용 비디오를 제작하여 수업 과정을 더욱 생동감 있고 흥미롭게 만들며, 학생의 참여도와 학습 효과를 높일 수 있습니다.
엔터테인먼트 산업: 게임 CG, 영화 예고편 및 기타 엔터테인먼트 콘텐츠를 자동으로 생성하여 시간과 인적 비용을 대폭 절감할 수 있습니다.
문화 전파: 특히 중국풍 미학方面에서 두드러진 성능을 보여, 수묵화, 古風(고풍) 장면 등 콘텐츠를 생성할 수 있어 전통 문화의 디지털 전파에 기여하며, 전통 문화가 새로운 시대에 새로운 활력을 불어넣도록 합니다.
Step-Video-T2V 사용 방법:
1. 의존성 설치:
필요한 Python 라이브러리와 의존성 패키지를 설치합니다. 일반적으로 pip 또는 기타 패키지 관리 도구를 통해 설치할 수 있습니다.
pip install transformers torch torchvision torchaudio
2. 환경 구성:
실행에 필요한 하드웨어 환경을 설정하며, 최소 80GB VRAM의 NVIDIA GPU 4개 이상을 권장합니다.
모델 가중치 파일을 다운로드하여 지정된 디렉터리에 압축 해제합니다.
3. 모델 로드:
Hugging Face Transformers 라이브러리를 사용하여 사전 학습된 Step-Video-T2V 모델을 로드합니다.
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "stepfun-ai/Step-Video-T2V"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
4. 비디오 생성:
텍스트 프롬프트를 준비하여 모델이 사용할 수 있는 형태로 변환합니다.
생성 스크립트를 실행하고 출력 결과를 기다립니다.
input_text = "A red-haired woman performing on stage."
inputs = tokenizer(input_text, return_tensors="pt")
# Generate video frames (this is a simplified example; actual implementation may vary)
outputs = model.generate(**inputs, max_length=204)  # Adjust parameters as needed
# Save or display the generated video frames
5. 후처리:
생성된 비디오 프레임에 대해 후속 처리를 수행합니다. 예를 들어 하나의 완성된 비디오로 연결하거나 오디오를 추가하는 등의 작업입니다.
리소스 접근:
GitHub 저장소: https://github.com/stepfun-ai/Step-Video-T2V
Hugging Face 데모: https://huggingface.co/stepfun-ai














