
 대본 기획 도우미▸
 AI 앱
 AI 뉴스

Story Flicks - AI로 HD 스토리 쇼츠를 생성하는 오픈소스 도구
Story Flicks - AI로 HD 스토리 쇼츠를 생성하는 오픈소스 도구소개
Story Flicks는 오픈 소스 기반의 ai 대형 모델로 만든 스토리 짧은 동영상 생성 도구입니다. 최첨단 언어 모델과 이미지 생성 기술을 융합하여, 사용자가 입력한 스토리 주제에 따라 AI가 생성한 이미지, 스토리 내용, 오디오가 포함된 동영상을 빠르게 생성합니다. 주로 원클릭으로 고화질 짧은 동영상을 생성하는 서비스를 제공하며, 시각적 콘텐츠를 빠르게 제작하고자 하는 크리에이터, 교육자, 마케팅 담당자에게 매우 적합합니다.
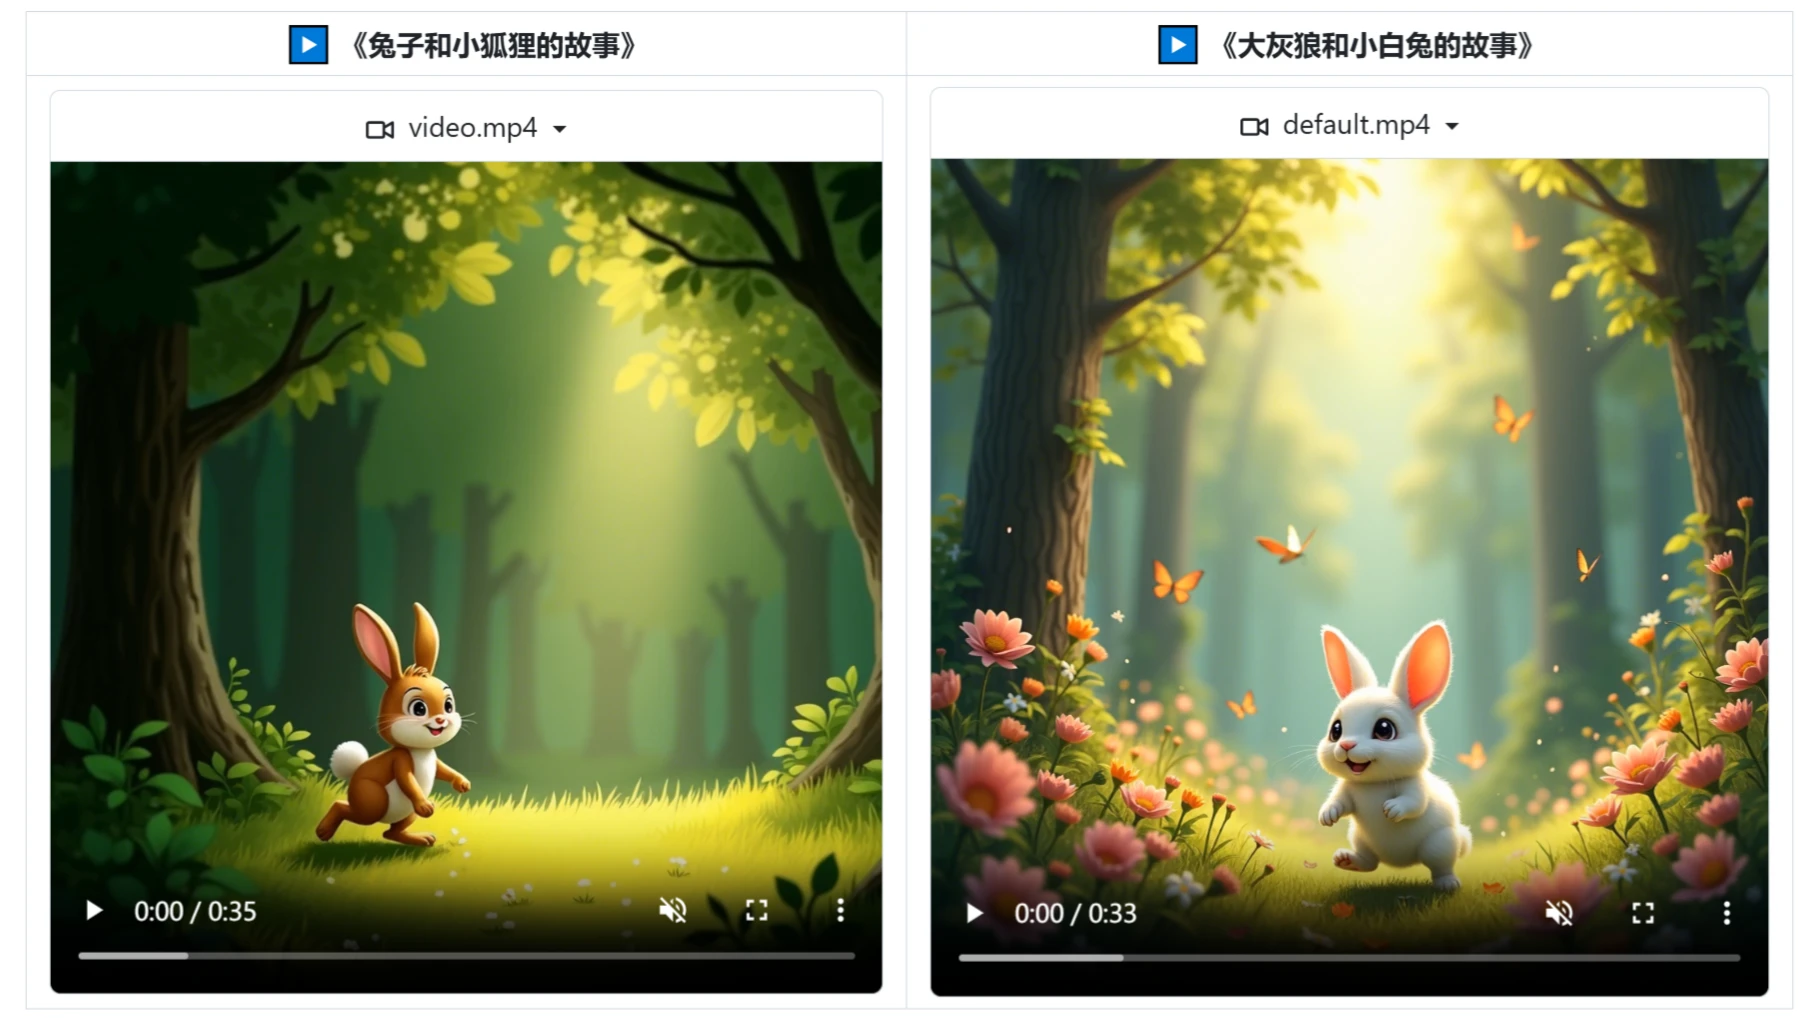
주요 기능 및 특징:
지능형 생성: 사용자가 스토리 주제나 키워드만 입력하면 시스템이 자동으로 해당 짧은 동영상을 생성하며, 짧은 시간 안에 다양한 창의적인 결과물을 제공합니다.
다국어 지원: Story Flicks는 다양한 언어를 지원하며, 사용자는 자신의 필요에 따라 적합한 언어를 선택하여 콘텐츠를 생성할 수 있어 사용의 편의성과 유연성을 높여줍니다.
이미지와 오디오 결합: Story Flicks는 텍스트 콘텐츠와 스토리 플롯을 생성할 뿐만 아니라, 동영상에 AI가 생성한 이미지와 배경 음향 효과를 추가하여 동영상의观赏성을 전반적으로 향상시킵니다.
멀티모달 생성: Story Flicks는 대규모 언어 모델(LLM)을 통해 지능적으로 분석하여 내러티브 프레임워크를 종합적으로 구축하고, 시각, 청각, 텍스트 요소를 동기식으로 융합합니다. 즉, 텍스트 스토리를 생성할 뿐만 아니라, 스토리와 일치하는 AI 이미지, 동적 음성 나레이션, 지능형 자막을 자동으로 만들 수 있습니다.
AI 이미지 생성: Story Flicks는 이미지 생성 기술을 활용하여 스토리 속 장면과 캐릭터에 생생한 시각적 효과를 부여하여, 생성된 동영상 콘텐츠가 시각적으로 강한 매력을 갖도록 합니다.
일체형 오디오 제작: 동적 음성 나레이션이 포함되어 있어, 사용자가 별도로 음성을 녹음하거나 오디오 자료를 찾을 필요가 없으며, 시스템이 스토리 내용에 따라 자동으로 음성을 생성합니다.
지능형 자막: 자막을 자동으로 편집할 수 있어, 청각 장애 사용자가 동영상 콘텐츠를 이해하는 데 편의를 제공할 뿐만 아니라 동영상의 접근성을 높여줍니다.
기술 스택: 백엔드는 Python과 FastAPI를 사용하고, 프런트엔드는 React, Ant Design, Vite를 채택하여 시스템이 효율적이고 안정적으로 작동하도록 보장하며, 사용자에게良好的한 개발 경험을 제공합니다.
활용 시나리오:
창의적 콘텐츠 제작: 짧은 동영상 블로거,自媒体 인터넷 셀러리티, 마케팅 담당자에게 적합하며, 풍부한 시각적 스토리를 빠르게 제작하여 효율성을 높일 수 있습니다.
교육 및 훈련: 교육 분야에서 매우 유용하며, 학습자 직관적인 학습 자료를 제공할 수 있습니다(예: 교육용 짧은 동영상 콘텐츠).
엔터테인먼트 및 광고: 엔터테인먼트 업계 종사자 및 광고 제작자는 이를 활용하여 홍보 동영상을 빠르게 제작할 수 있습니다.
개인 용도: 일반 개인 사용자도 기념 동영상을 제작하거나 스토리를 공유하는 등을 쉽게 할 수 있습니다.
Story Flicks 사용 방법:
1. 본 프로젝트 다운로드:
git clone https://github.com/alecm20/story-flicks.git
2. 모델 정보 설정
# 先切换到项目的 backend 目录下
cd backend
cp .env.example .env
text_provider="openai"    # 文本生成模型的提供商,目前支持 openai和 aliyun、deepseek、ollama、siliconflow,阿里云文档:https://www.aliyun.com/product/bailian
image_provider="aliyun"   # 图片生成模型的提供商,目前支持 openai和 aliyun、siliconflow
openai_base_url="https://api.openai.com/v1" # openai 的 baseUrl
aliyun_base_url="https://dashscope.aliyuncs.com/compatible-mode/v1" # 阿里云的 baseUrl
deepseek_base_url="https://api.deepseek.com/v1" # deepseek 的 baseUrl
ollama_base_url="http://localhost:11434/v1" # ollama 的 baseUrl
siliconflow_base_url="https://api.siliconflow.cn/v1" # siliconflow 的 baseUrl
openai_api_key= # openai 的 api key,可以只填一个
aliyun_api_key= # 阿里云百炼的 api key,可以只填一个
deepseek_api_key= # deepseek 的 api key,目前该 api_key 只支持文本生成
ollama_api_key= # 如果需要使用的话,请填写ollama,目前该 api_key 只支持文本生成,并且不能用参数量太小的模型,推荐qwen2.5:14b 或者更大的模型。
siliconflow_api_key= # siliconflow 的文本模型目前只支持兼容 OpenAI 格式的大模型,如:Qwen/Qwen2.5-7B-Instruct。图像模型只测试了:black-forest-labs/FLUX.1-dev
text_llm_model=gpt-4o # 如果 text_provider 设置为 openai,这里只能填 OpenAI 的模型,如:gpt-4o。如果设置了 aliyun,可以填阿里云的大模型,如:qwen-plus 或者 qwen-max。ollama 的模型不能使用体积太小的模型,否则无法输出正确的 json,可以使用如:qwen2.5:14b 或更大的模型。
image_llm_model=flux-dev # 如果 image_provider 设置为 openai,这里只能填 OpenAI 的模型,如:dall-e-3。如果设置了 aliyun,可以填阿里云的大模型,阿里云推荐使用:flux-dev,目前可以免费试用,具体参考:https://help.aliyun.com/zh/model-studio/getting-started/models#a1a9f05a675m4。
3. docker를 통해 프로젝트 시작
프로젝트 루트 디렉터리에서 다음을 실행합니다:
docker-compose up --build
4. 사용 시작
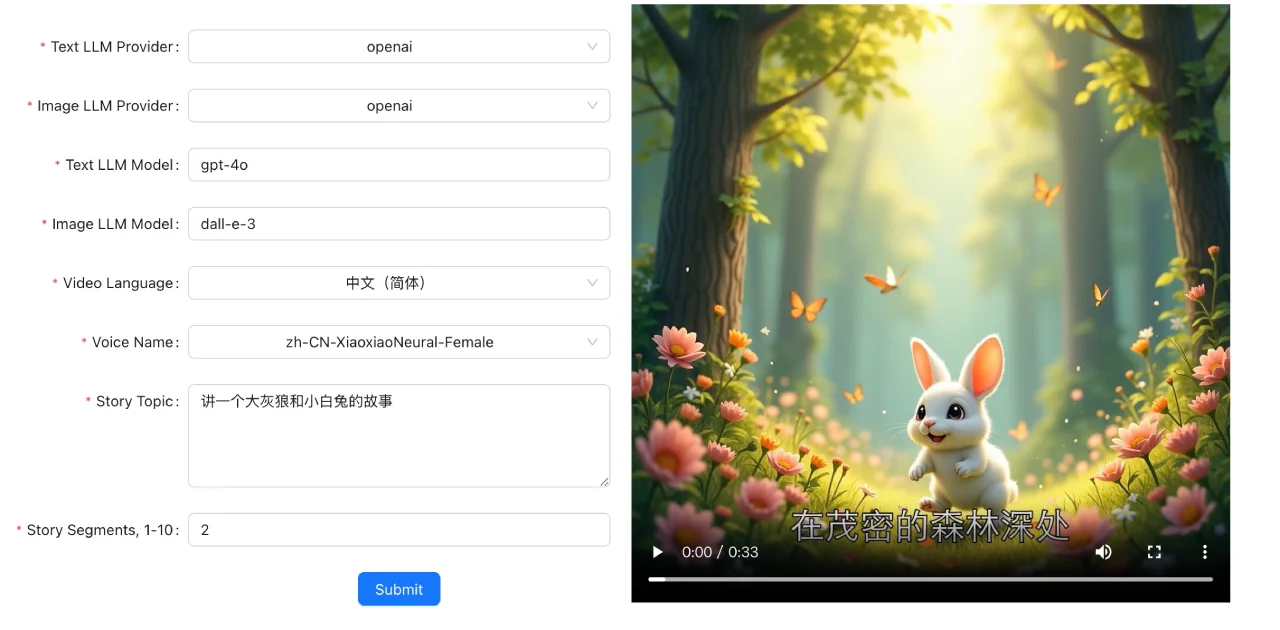
스토리 주제 입력: 생성 도구 인터페이스에서 텍스트 생성 모델 제공자, 이미지 생성 모델 제공자, 텍스트 모델, 이미지 생성 모델, 동영상 사용 언어, 음성, 스토리 주제 및 스토리 단락을 선택합니다.
동영상 생성: 생성 버튼을 클릭하면 시스템이 AI 기술을 기반으로 처리를展开하고, 몇 초 내에 최종 동영상을 생성할 수 있습니다.
관련 정보:












