
 脚本プランナー▸
 AIアプリ
 AIニュース
Etna:テキストから動画を生成するAIGCモデル
Etna:テキストから動画を生成するAIGCモデル紹介
Etnaモデルは七火山科技が開発した高度なテキストから動画への変換モデルソフトウェアであり、自然言語処理、生成的敵対ネットワーク、コンピュータビジョン技術分野で深い研究と応用を行っています。
Etnaモデルは最新のニューラルネットワークアーキテクチャを採用しており、Transformerモデルの意味理解能力とDiffusionモデルのコンテンツ生成戦略を巧みに融合させ、テキストから動画への効率的な変換を実現しています。このモデルは8~15秒の動画生成をサポートしており、毎秒60フレームという極めて高いなめらかさを実現しています。
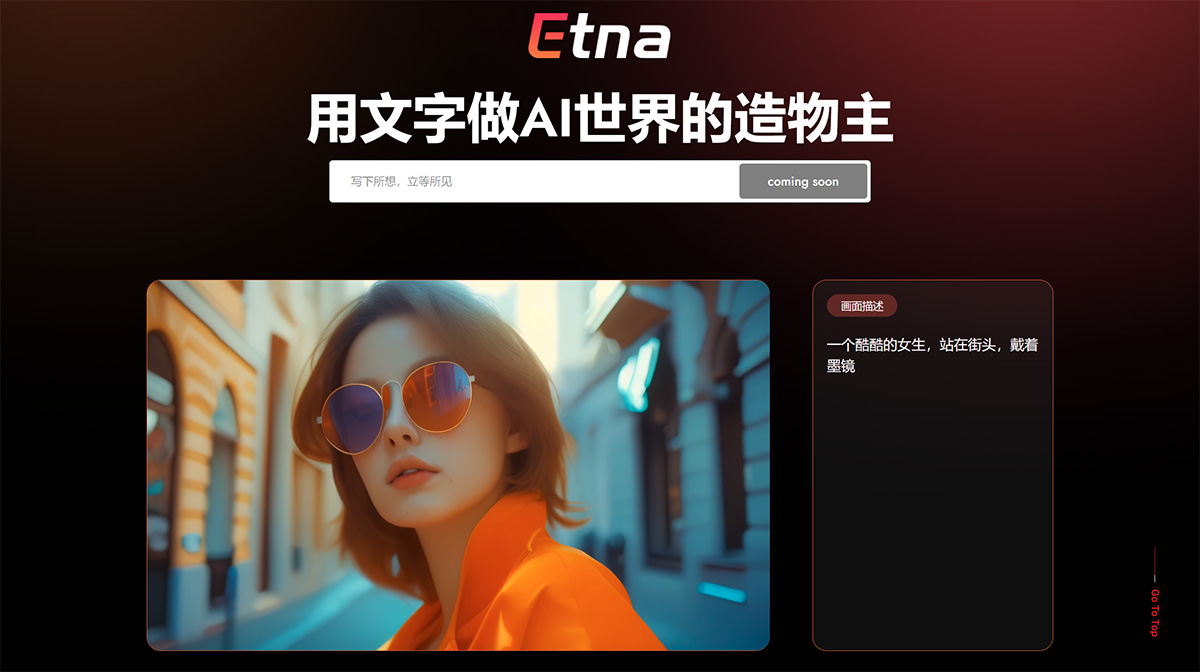
Etnaモデルの技術的特徴:
最新のニューラルネットワークアーキテクチャを採用
Transformerモデルの意味理解能力とDiffusionモデルのコンテンツ生成戦略を融合
テキストから動画への効率的な変換をサポート
Etnaモデルの応用シーン:
Etnaモデルの応用シーンは非常に広く、動画コンテンツ制作、ゲーム開発、アート・エンターテインメント、教育・トレーニングなどの分野を含みますが、これらに限定されません。
動画コンテンツ制作:映画、アニメーション、広告、ソーシャルメディアプラットフォーム
ゲーム開発:ゲーム内のアニメーションやシーンの制作
アート・エンターテインメント:独自のビジュアルアート作品の創造
教育・トレーニング:教育映像の制作による学習意欲と効果の向上
これらの応用シーンは、異なる分野におけるEtnaモデルの幅広い応用の可能性と革新能力を示しています。
Etnaモデル FAQs:
Etnaは何ができますか?
七火山科技のEtnaは、テキストから動画を生成するAIGCモデルであり、短いテキストの説明に基づいて対応する動画コンテンツを生成することができます。
Etnaはどのような技術アーキテクチャを採用していますか?
Etnaモデルの現在のバックボーンネットワークはDiffusionアーキテクチャを採用しており、同時にSoraに類似したDiffusion+Transformアーキテクチャをより大規模なデータセットで実験・適応しています。
Etnaの技術原理は何ですか?
Etnaモデルは、言語モデルと画像モデルに時空間畳み込みとアテンション層を挿入することで、画像シーケンス内の時間的連続性を考慮した動画データを処理できます。これは、Etnaが一定の時空間理解能力を持ち、時間的な次元を持つ動画コンテンツを理解・生成できることを意味します。
Etnaはどのようにモデルを訓練しますか?
Etnaモデルは、大規模な動画データセットで十分に訓練されており、その過程ではLDS大規模訓練、複雑なHPOハイパーパラメータ最適化、DPOファインチューニングを含む高度なdeep-learning技術戦略を採用しており、モデルの強力な性能と生成能力を保証しています。
Etnaモデルは、七火山科技のAI動画技術分野における重要な革新成果として、最新のニューラルネットワークアーキテクチャと技術戦略を組み合わせることで、テキストから高品質な動画への効率的な変換を実現し、幅広い応用シーンと商業的可能性を示しています。











