
 대본 기획 도우미▸
 AI 앱
 AI 뉴스

LiberSonora: AI 기반 오픈소스 오디오북 툴킷
LiberSonora: AI 기반 오픈소스 오디오북 툴킷소개
LiberSonora는 오픈 소스 오디오북 도구 모음으로, 그 이름은 "자유로운 소리"라는 의미를 담고 있습니다. LiberSonora 도구 모음은 스마트 자막 추출, ai 제목 생성 및 다국어 번역을 포함한 다양한 기능을 제공합니다.
LiberSonora 주요 기능:
스마트 자막 추출: LiberSonora는 오디오 파일에서 자동으로 자막을 추출할 수 있어 오디오북 제작 과정을 크게 간소화합니다.
AI 제목 생성: LiberSonora는 오디오 콘텐츠에 적합한 제목을 자동으로 생성하여 사용자가 자신의 작품을 더 잘 정리하고 관리할 수 있도록 도와줍니다.
다국어 번역: LiberSonora는 다양한 언어의 번역 기능을 지원합니다.
GPU 가속: LiberSonora는 GPU 가속을 지원하여 처리 속도가 더 빠릅니다.
다중 모델 선택: 유연한 모델 선택으로 로컬 Ollama, DeepSeek 및 OpenAI 등 다양한 대형 모델을 지원합니다.
오디오북 일괄 처리: 강력한 일괄 처리 기능으로 대량의 오디오북을 쉽게 처리할 수 있습니다.
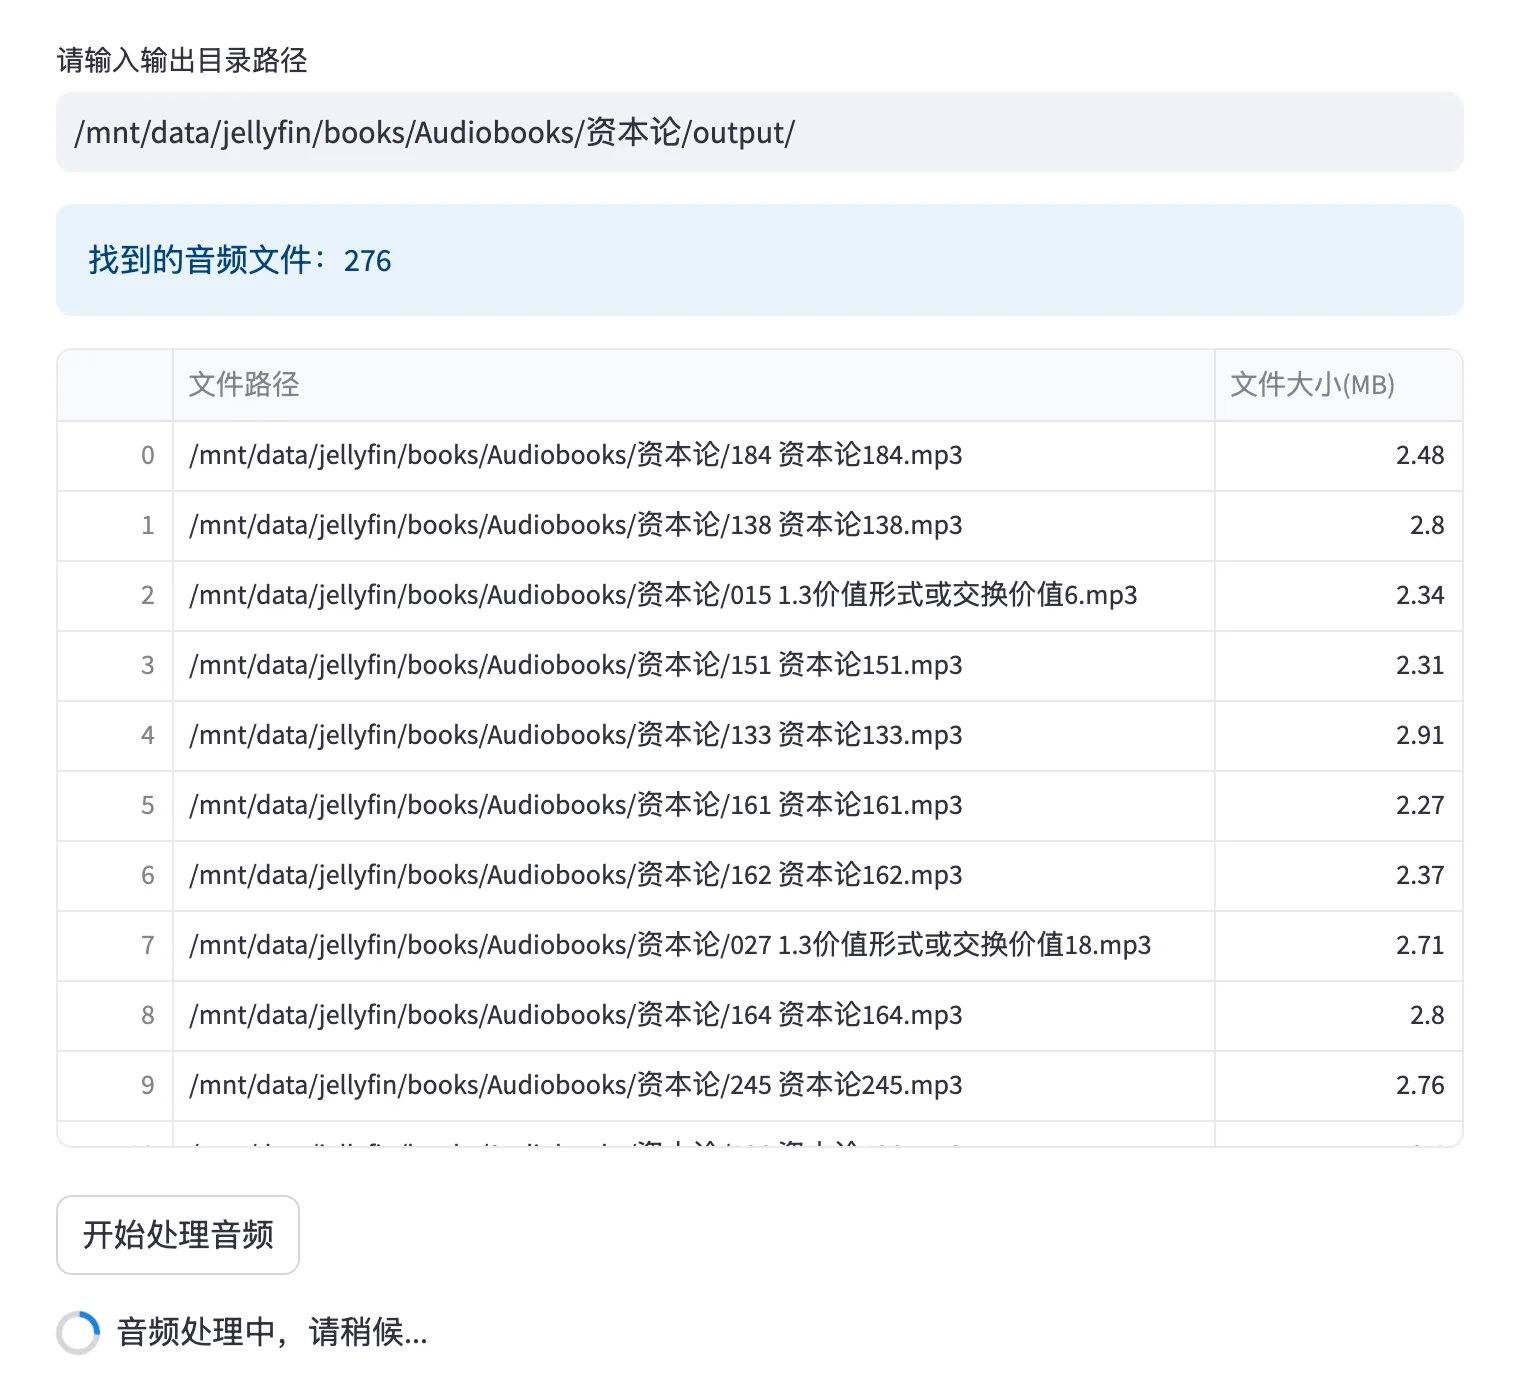
로컬 오디오 처리: 서버의 로컬 오디오 파일을 오프라인으로 처리하여 파일 전송 단계를 생략할 수 있습니다.
출력 결과 수동 확인: 편리한 수동 확인 기능으로 수동으로 이름을 지정하거나 AI가 다시 생성하도록 할 수 있습니다.
LiberSonora 주요 장점:
오픈 소스 자유: MIT 라이선스를 채택한 진정한 오픈 소스 무료 소프트웨어로, 오디오 처리와 대형 모델 추론이 전체적으로 로컬에서 오프라인으로 실행되어 자율적으로 제어할 수 있으며 데이터 안전이 보장됩니다.
기능 혁신: 오디오와 텍스트 생성을 처리하는 독특한 AI 기술을 제공합니다.
편리한 배포: 프로젝트 컨테이너화로 개발과 배포가 편리하며, API를 지원하여 개인 워크플로에 쉽게 통합할 수 있습니다.
모듈식 설계: 각 기능 모듈이 독립적이어서 특정 서비스(예: 오디오 향상, 자막 인식 등)를单独 시작할 수 있습니다.
유연한 맞춤 설정: 사용자 정의 대형 모델을 지원하여 특정 작업에 대한 효과를 향상시키고, 다양한 구성을 통해 여러 요구 사항을 충족합니다.
LiberSonora 사용 시나리오:
LiberSonora는 콘텐츠 제작자, 소규모 출판사, 비디오 블로거, 팟캐스트 제작자 및 오디오 콘텐츠 제작에 관심이 있는 모든 사람에게 매우 적합합니다.
사용 방법:
1. 프로젝트 저장소 복제:
먼저 LiberSonora의 GitHub 저장소를 로컬로 복제해야 합니다. 터미널 또는 명령 프롬프트를 열고 다음 명령을 실행합니다:
git clone https://github.com/LiberSonora/LiberSonora
2. 프로젝트 디렉토리로 이동:
cd LiberSonora
3. Docker 컨테이너 시작:
docker-compose -f docker-compose.gpu.yml up -d
4. 컨테이너 실행 로그 확인:
docker-compose -f docker-compose.gpu.yml logs -f
5. 인터페이스 접속:
브라우저를 열고 xxx.xxx.xxx.xxx:8651에 접속합니다(xxx.xxx.xxx.xxx을 서버 IP 주소로 교체). LiberSonora의 웹 인터페이스가 표시됩니다. 이 인터페이스를 통해 오디오북 파일을 관리하고, 자막을 추출하며, 제목을 생성하고, 다국어 번역을 수행할 수 있습니다.
6. API 사용:
API를 통해 LiberSonora를 통합하려면 프로젝트 문서의 API 인터페이스 설명을 참조할 수 있습니다. HTTP 요청을 사용하여 LiberSonora와 상호 작용하여 자동화된 처리를 구현할 수 있습니다.
7. 오디오 파일 처리:
오디오북 오디오 파일을 지정된 디렉토리에 넣으면 LiberSonora가 자동으로 이러한 파일을 처리하여 자막과 제목을 생성하며 다국어 번역을 지원합니다.
GitHub:https://github.com/LiberSonora/LiberSonora














