
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Moshi: 오픈소스 실시간 음성 변환기
Moshi: 오픈소스 실시간 음성 변환기소개
Moshi는 풀듀플렉스 음성 대화를 지원하는 다중 스트림 실시간 음성 생성 트랜스포머 모델입니다. 주요 특징은 동시에 음성을 입력하고 출력하는 것(풀듀플렉스), 그리고 겹치는 음성, 중단, 감정 표현과 같은 비언어적 정보를 포함하여 복잡한 대화 상황을 처리하는 능력입니다.
이는 Moshi가 동시에 듣고 말할 수 있음을 의미하며, 지연 시간, 비언어적 정보(예: 감정) 손실, 대화 교대의 경직된 구조와 같은 기존 대화 시스템의 일부 문제를 해결하는 것을 목표로 합니다.
풀듀플렉스 통신: 전통적인 대화 시스템은 교대 방식입니다(한 사람이 다른 사람이 말하기 시작하기 전에 말을 마칩니다). Moshi는 이러한 제한을打破하고 풀듀플렉스 통신을 지원합니다. 이는 Moshi가 사용자가 말하는 동안 라운드 제한 없이 음성 응답을 생성할 수 있으며, 겹치는 음성, 중단 및 빠른 피드백과 같은 복잡한 대화 역학을 처리할 수 있음을 의미합니다.
다중 스트림 처리: Moshi는 여러 오디오 스트림을 처리하여 동시에 듣고 음성을 생성합니다. 이러한 다중 스트림 아키텍처는 대화의 자연스러운 흐름을 중단하지 않고 사용자와 시스템 간의 음성 상호 작용을 유연하게 처리할 수 있게 합니다.
전통적인 음성 대화 시스템에 비해 Moshi에는 몇 가지 뚜렷한 장점이 있습니다.
실시간 응답: Moshi의 응답 속도는 매우 빠르며, 지연 시간은 단 160~200밀리초로 자연스러운 대화의 반응 속도에 가까워 더 부드러운 대화 경험을 제공할 수 있습니다.
음성 대 음성 처리: 전통적인 시스템은 일반적으로 음성-텍스트-음성 프로세스에 의존하지만, Moshi는 음성 입력을 직접 처리하고 음성 출력을 생성하여 어조와 감정과 같은 비언어적 정보를 보존합니다.
풀듀플렉스 대화: Moshi는 엄격한 대화 교대에 의존하지 않고 사용자 및 시스템 음성을 동시에 처리할 수 있습니다. 이는 겹치는 음성과 중단을 처리하여 인간 대화의 자연스러운 형태에 더 가깝게 만들 수 있음을 의미합니다.
Moshi의 주요 특징:
실시간 음성 대화: Moshi는 전통적인 음성-텍스트-음성 프로세스에 의존하지 않고 오디오 입력에서 직접 오디오 출력을 생성합니다. 음성 데이터를 직접 처리함으로써 Moshi는 어조, 감정, 겹치는 음성 및 중단과 같은 비언어적 정보를 보존하여 더 자연스럽고 부드러운 대화를 보장합니다.
풀듀플렉스 통신: Moshi는 동시에 듣고 말할 수 있으며, 이는 엄격한 대화 교대 없이도 사용자가 말하는 동안 음성 응답을 생성할 수 있음을 의미합니다. 겹치는 음성 및 언제든지 삽입될 수 있는 중단 없는 피드백(예: "음" 또는 "알겠습니다")과 같은 복잡한 대화 상황을 처리할 수 있습니다.
낮은 지연 시간: Moshi는 설계상 지연 시간이 매우 낮으며, 이론적으로는 160밀리초, 실제로는 약 200밀리초입니다. 이는 Moshi가 사용자 입력에 거의 실시간으로 응답하여 더 부드러운 대화 경험을 제공할 수 있음을 의미합니다.
내면 독백 방법: Moshi는 음성을 생성하기 전에 텍스트 토큰을 예측하며, 이는 생성된 음성의 언어 품질과 일관성을 크게 향상시킵니다. 이는 생성된 음성을 더 명확하게 만들 뿐만 아니라 스트리밍 환경에서 시스템의 음성 인식 및텍스트 음성 변환 능력을 향상시킵니다. Moshi는 "내면 독백" 메커니즘을 도입하여 스트리밍 음성 인식(ASR) 및 텍스트 음성 변환(TTS) 기능을 구현하고 연속 대화 스트림에서 언어와 오디오를 동시에 처리할 수 있도록 지원합니다.
여러 오디오 스트림의 병렬 처리: Moshi는 사용자 및 시스템의 음성 스트림을 동시에 처리할 수 있습니다. 이러한 다중 스트림 처리 기능을 통해 Moshi는 자신의 음성을 생성할 뿐만 아니라 사용자의 음성을 실시간으로 이해하고 응답할 수 있습니다.
감정 및 발화 역학 처리: 중간 텍스트가 아닌 음성을 직접 처리함으로써 Moshi는 감정이 풍부한 음성을 이해하고 생성할 수 있으며, 감정 표현, 음성 변화 등과 같은 복잡한 대화 역학을 처리할 수 있습니다.
복잡한 대화 역학 지원: Moshi는 중단, 교차, 감탄사 및 응답과 같은 자연스러운 대화의 복잡한 역학을 처리할 수 있습니다. 전통적인 시스템은 명확한 대화 교대(한 사람이 다른 사람 차례 전에 말함)에 의존하지만, Moshi는 이러한 제한을 제거하여 대화를 더 자연스럽게 만듭니다.
Moshi의 모델 아키텍처
Moshi는 세 가지 주요 부분으로 구성됩니다. 2.1조 개의 토큰으로 학습된 7B 언어 모델인 Helium, 의미 및 음향 정보를 모델링하는 신경 오디오 코덱인 Mimi, 그리고 사용자와 Moshi의 오디오를 각각 모델링할 수 있는 새로운 다중 스트림 아키텍처입니다.
이러한 모듈은 협력하여 매끄러운 풀듀플렉스 대화, 감정 표현 및 복잡한 대화 역학 처리를 달성합니다.
Helium 텍스트 언어 모델
Helium은 Moshi의 핵심입니다. 이는 트랜스포머 아키텍처(GPT와 유사)를 기반으로 한 70억 개의 매개변수를 가진 텍스트 언어 모델입니다. Helium은 Moshi에 강력한 언어 이해 및 생성 기능을 제공하여 복잡한 텍스트 추론 및 대화 작업을 처리할 수 있습니다.
학습 데이터에는 2.1조 개의 영어 단어가 포함되어 있어 광범위한 지식과 언어 능력을 부여합니다.
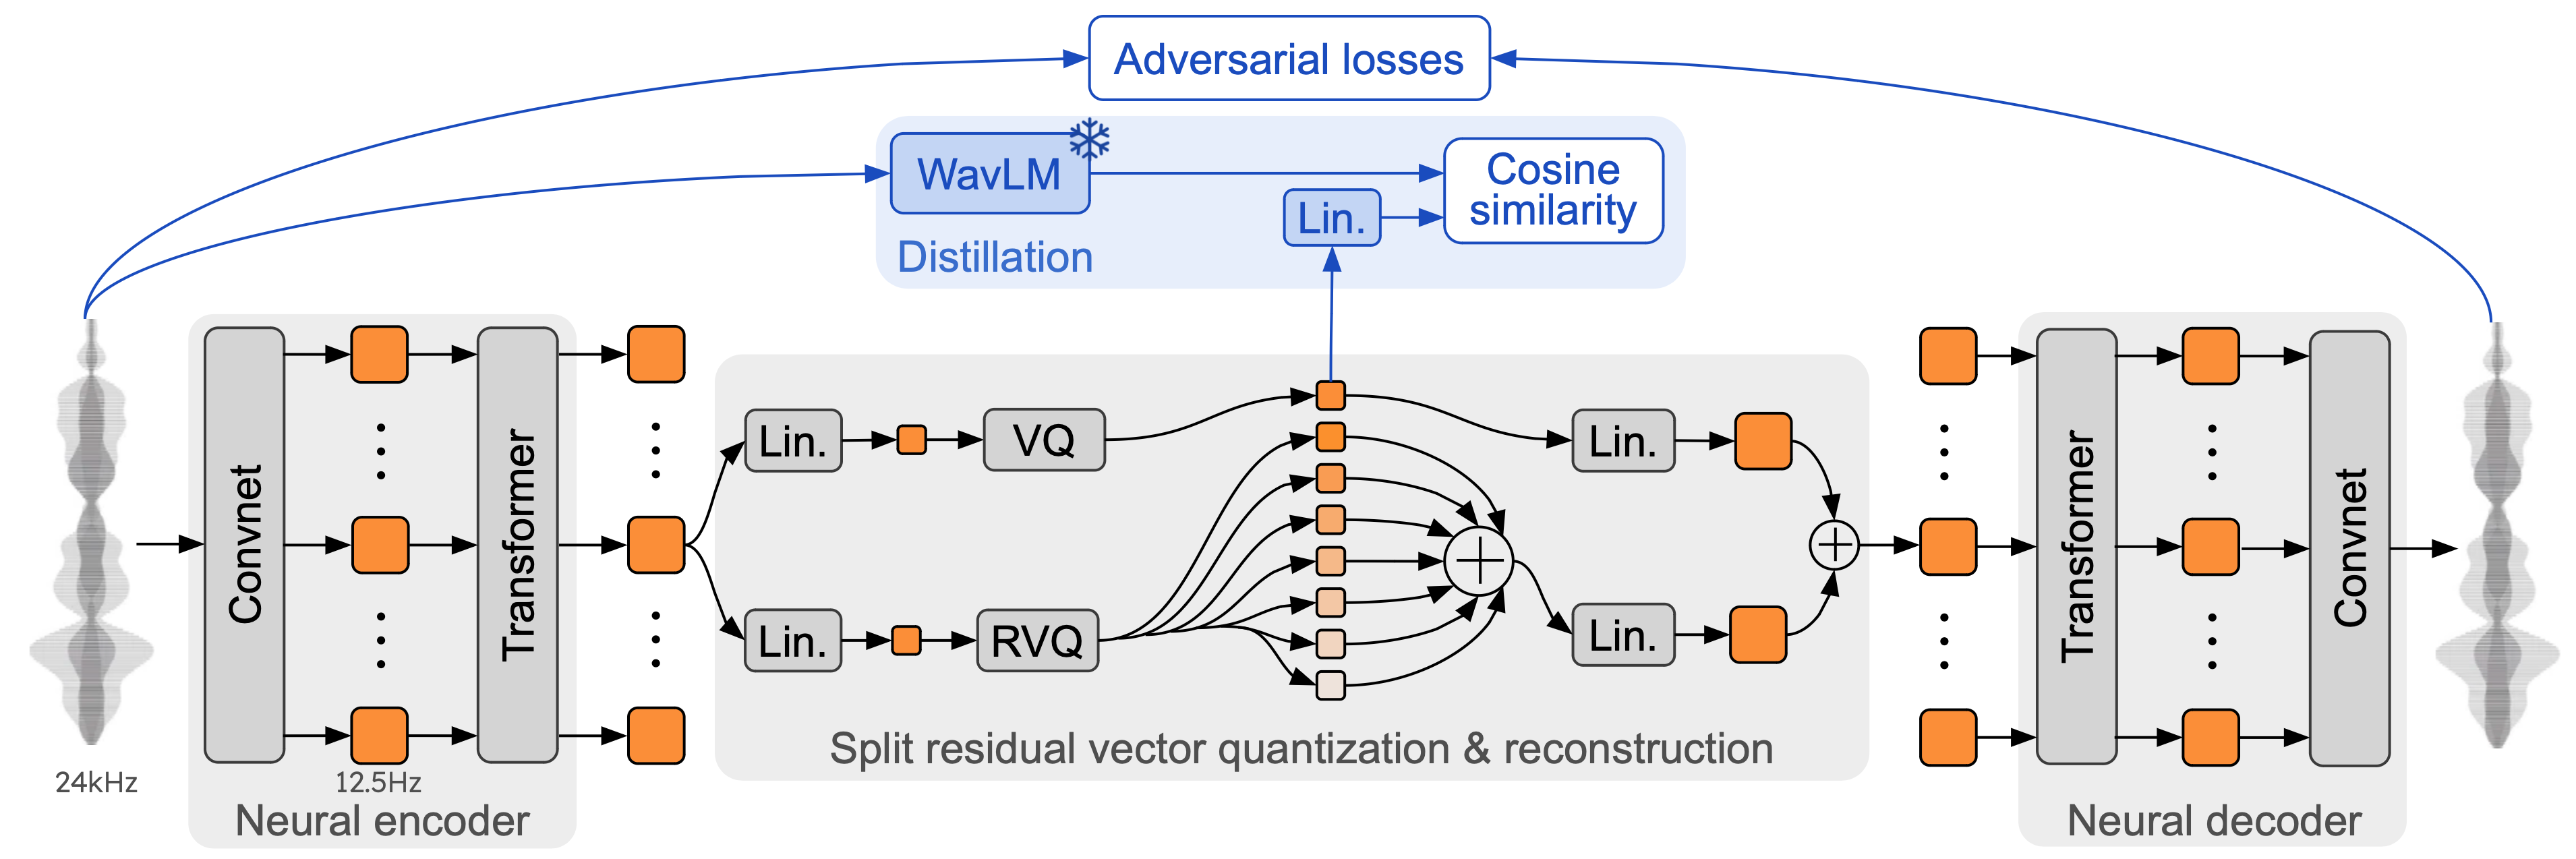
Mimi 신경 오디오 코덱:Mimi는 Moshi의 오디오 처리 구성 요소입니다. 이는 신경망 오디오 코덱으로, 오디오를 개별 음성 토큰으로 변환하고 역방향으로 고품질 음성 출력을 생성할 수 있습니다.
Mimi는 잔차 벡터 양자화(RVQ) 기술을 사용하여 음성 데이터를 개별 음성 및 의미 토큰으로 인코딩하여 높은 음성 충실도와 언어 일관성을 보장합니다.
의미 및 음향 토큰을 결합함으로써 Mimi는 자연스러운 음성을 생성할 뿐만 아니라 복잡한 음성 맥락 및 감정 정보를 처리할 수 있습니다.
내면 독백 방법:내면 독백 방법은 Moshi 음성 생성의 핵심 기술로, 모델이 음성을 생성하기 전에 오디오와 동기화된 텍스트 토큰을 예측할 수 있도록 합니다. 이 방법은 생성된 음성의 언어 품질을 향상시킬 뿐만 아니라 Moshi가 스트리밍 환경에서 음성 인식 및 텍스트 음성 변환 기능을 구현할 수 있도록 합니다.
텍스트와 음성의 동기 생성: 오디오를 생성하기 전에 Moshi는 음성 출력에 해당하는 텍스트 스트림을 생성합니다. 이 텍스트 스트림은 음성 생성의 기초 역할을 하여 음성 생성을 더 정확하게 만들고 복잡한 대화 시나리오를 처리하는 데 도움이 됩니다.
스트리밍 호환성: 이 방법을 통해 Moshi는 스트리밍 환경에서 효율적인 음성 인식 및 텍스트 음성 변환(TTS)을 구현하면서 음성을 처리할 수 있습니다.
이 모델 아키텍처는 여러 병렬 오디오 스트림을 처리하고 음성 및 텍스트를 실시간으로 생성하도록 설계되었습니다. Moshi는 사용자 음성을 처리하는 동시에 시스템 음성을 생성할 수 있어 중단 없는 자연스러운 대화를 지원합니다.
Moshi의 상세 기술 방법
1. 음성 대 음성 생성 아키텍처
Moshi의 핵심 혁신은 음성 대화를 전통적인 텍스트 대 음성 그 다음 음성의 다중 구성 요소 프로세스가 아닌 음성 대 음성 생성 작업으로 간주한다는 것입니다. 전통적인 음성 대화 시스템은 음성 활동 감지(VAD), 음성 인식(ASR), 자연어 이해(NLU), 자연어 생성(NLG) 및 텍스트 음성 변환(TTS)과 같은 여러 독립적인 모듈을 포함합니다.
Moshi는 음성 토큰을 직접 생성하여 이해 및 생성 과정에서 중간 텍스트 표현에 의존하지 않음으로써 정보(예: 감정, 어조 및 비언어적 음성)의 손실을 방지합니다.
2. Helium 텍스트 언어 모델
Moshi는 Helium 텍스트 언어 모델을 기반으로 하며, 이는 7B 매개변수를 가진 대규모 텍스트 생성 모델입니다. Helium은 2.1조 개의 영어 데이터로 사전 학습되어 강력한 언어 이해, 추론 및 생성 능력을 갖추고 있습니다. 이는 Moshi의 의미 이해 기반이며, 개방형 대화 및 질의응답을 포함하는 복잡한 자연어 처리 기능을 지원합니다.
Helium의 주요 특징:
자기회귀 트랜스포머 아키텍처: Moshi는 트랜스포머 아키텍처를 기반으로 한 텍스트 언어 모델인 Helium을 기반으로 합니다. 고전적인 트랜스포머와 유사하게, Helium은 다층 어텐션 메커니즘과 자기회귀 모델링 방법을 사용하여 텍스트 입력을 처리하고 출력을 생성합니다. 이 모델은 7B 개의 매개변수를 가지고 있어 대규모 말뭉치 학습을 지원하기에 충분합니다.
RMS 정규화: 어텐션 모듈, 피드포워드 모듈, 출력 계층에서 RMS 정규화를 사용하여 모델의 학습 안정성을 향상시킵니다.
회전 위치 인코딩(RoPE): 긴 컨텍스트 창(4096 토큰)을 처리하여 모델이 대화의 장기 의존성을 포착할 수 있도록 합니다.
효율적인 FlashAttention: 최적화된 어텐션 계산을 통해 긴 시퀀스 입력에서 모델 추론이 더 효율적입니다.
3. Mimi 신경 오디오 코덱
Mimi는 Moshi에서 음성 처리에 사용되는 신경 오디오 코덱입니다. 그 작업은 연속적인 음성 신호를 오디오 토큰으로 이산화하는 것입니다. 이러한 개별 오디오 토큰은 텍스트 토큰과 유사하며 음성의 자세한 정보를 나타낼 수 있습니다. Mimi는 잔차 벡터 양자화(RVQ) 기술을 사용하여 낮은 비트레이트로 고품질 오디오를 보존하여 실시간 음성 생성 및 처리를 지원합니다.
Mimi의 핵심 기술:
잔차 벡터 양자화(RVQ): Mimi는 다단계 잔차 벡터 양자화를 사용하여 복잡한 오디오 신호를 여러 수준의 오디오 토큰으로 이산화합니다. 이 방법을 통해 각 시간 단계에서 음성의 의미 및 음향 정보를 효율적으로 인코딩하면서 오디오 재구성의 품질을 보장할 수 있습니다.
의미 및 음향 토큰의 결합: Mimi에서 사용하는 오디오 토큰에는 의미 및 음향 정보가 모두 포함됩니다. 의미 토큰은 음성의 내용(예: 특정 단어)을 보존하고 음향 토큰은 음색, 감정 및 억양과 같은 음성의 오디오 특성을 설명합니다.
스트리밍 인코딩 및 디코딩: Mimi는 스트리밍을 지원하여 실시간 대화에서 연속적인 음성 생성 및 인식을 구현할 수 있습니다. 이는 Moshi가 자연스러운 대화에 매우 가까운 반응 속도를 가질 수 있게 합니다.
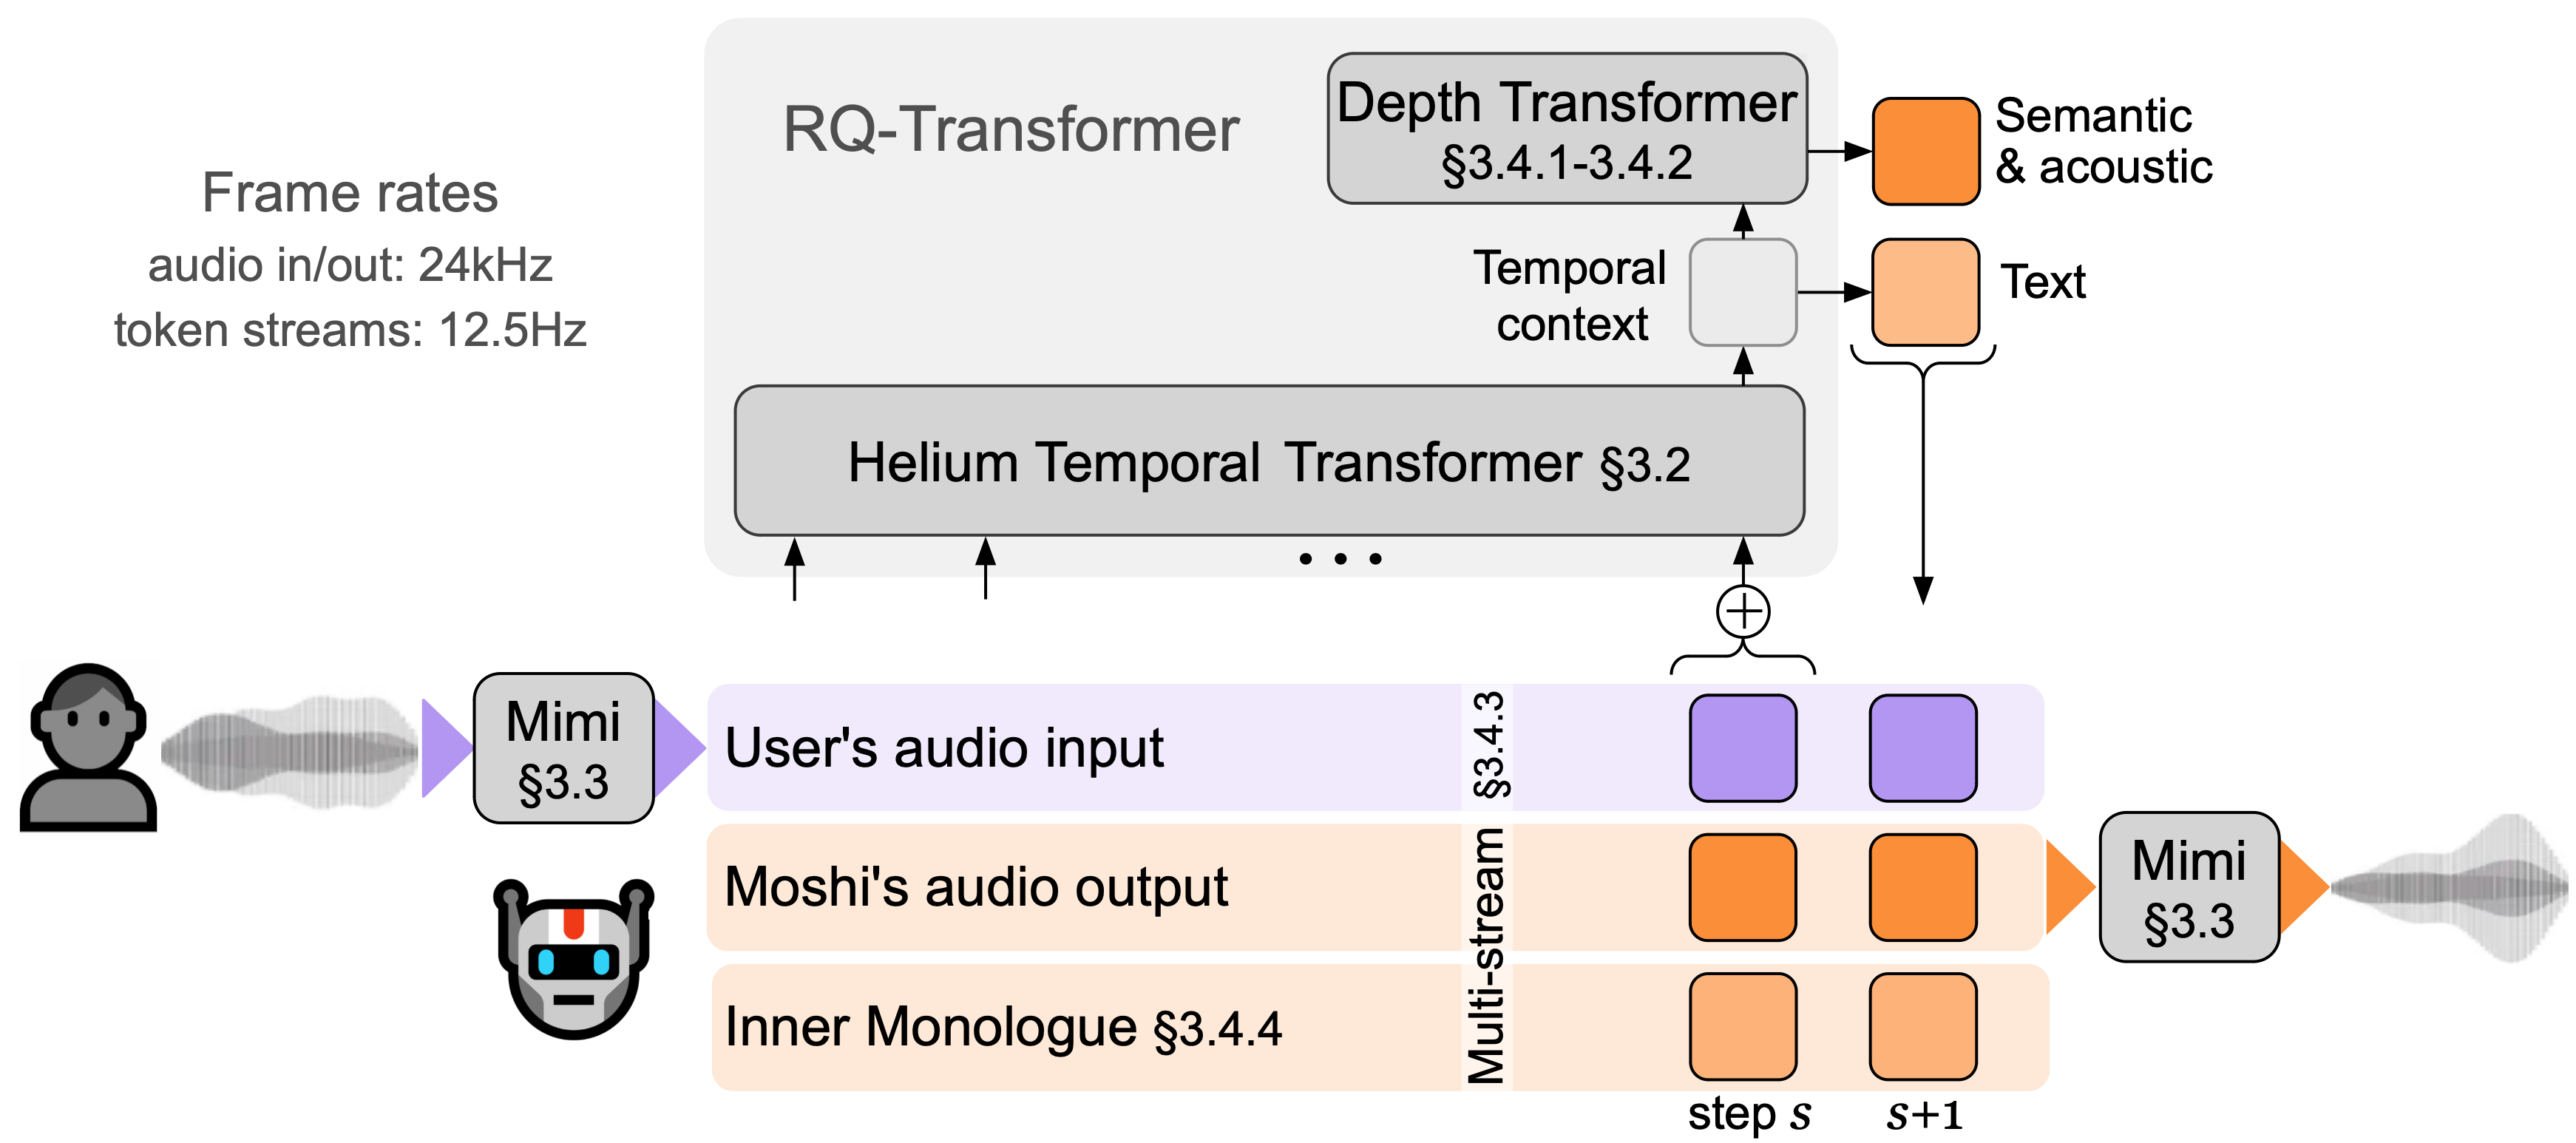
pan style="text-indent:2em;">4. RQ-Transformer의 아키텍처Moshi는 다중 스트림 계층적 생성 아키텍처를 채택하여 여러 오디오 스트림을 병렬로 처리할 수 있습니다. Moshi는 사용자의 음성 스트림과 시스템 자체의 음성 스트림을 동시에 모델링함으로써 대화에서의 유연한 상호작용을 구현하며, 발화자 간의 교차发言, 중단 및 감탄사와 같은 복잡한 대화 역학을 허용합니다.
이는 이전에 제안된 이산(discrete) 이미지 생성을 위한 아키텍처이며, Helium 시퀀스 길이를 늘리지 않고도 의미 및 음향 토큰의 계층 구조를 모델링할 수 있습니다. 즉, 1초의 오디오당 7B 백본 모델을 12.5회만 통과시키면 L4 또는 M3 Macbook Pro에서 실시간으로 실행할 수 있습니다! MusicGen의 토큰 지연과 결합되어, 이는 오디오 언어 모델링에 최첨단 성능을 제공합니다.
계층적 자기회귀 모델링: Moshi는 RQ-Transformer(Residual Quantizer Transformer)를 사용하여 오디오 토큰을 여러 레벨로 분해하고, 계층적 자기회귀 모델링을 통해 오디오를 생성합니다. 구체적으로, 모델은 먼저 더 큰 Temporal Transformer를 사용하여 시계열을 처리한 다음, 더 작은 Depth Transformer를 사용하여 각 시간 단계에서 여러 하위 시퀀스를 처리합니다. 이러한 설계는 긴 오디오 시퀀스를 생성하는 효율성을 크게 향상시킵니다.
다중 모달 시퀀스 생성: 모델은 동시에 여러 시퀀스(텍스트, 의미 토큰 및 오디오 토큰 포함)를 생성하며, 내부 독백 메커니즘을 통해 이들이 시간적으로 정확하게 정렬되도록 보장합니다. 각 시간 단계에서 생성된 내용은 현재 음성뿐만 아니라 해당 텍스트 접두사도 포함하므로, 생성된 음성 내용이 의미상 더 논리적으로 됩니다.
Architecture of RQ-Transformer
5. "내면의 독백(Inner Monologue)" 메커니즘
Moshi의 "내면의 독백" 메커니즘은 음성 생성의 핵심 혁신 중 하나입니다. 이 메커니즘을 통해 Moshi는 오디오를 생성하기 전에 해당 시간 정렬된 텍스트 토큰을 예측합니다. 이는 생성된 음성의 언어적 일관성을 향상시킬 뿐만 아니라 실시간 음성 인식(ASR) 및 텍스트 음성 변환(TTS)도 지원합니다.
"내면의 독백" 메커니즘의 특징:
정렬된 텍스트 및 오디오 생성: Moshi는 먼저 텍스트를 예측한 다음 오디오를 생성하여, 생성된 음성이 문법과 내용 면에서 더 정확하고 유창하게 만듭니다.
지연 메커니즘: 텍스트와 오디오 사이에 지연을 도입함으로써 Moshi는 ASR 및 TTS 작업을 별도로 수행할 수 있습니다. 예를 들어, 텍스트를 먼저 생성하고 오디오를 나중에 생성하면 모델은 TTS 모드가 되고, 그렇지 않으면 ASR 모드가 됩니다. Moshi는 이 두 모드 간을 원활하게 전환하여 모델이 음성을 생성하고 인식할 수 있도록 보장합니다.
Moshi: Delay mechanism
Moshi: TTS mode
6. 다중 스트림 모델링
Moshi의 아키텍처는 여러 오디오 스트림을 동시에 처리할 수 있도록 하며, 사용자의 음성을 모니터링하는 동시에 시스템 자신의 음성을 생성할 수 있습니다. 대화 과정에서 Moshi는 발화자 교대를 미리 명시적으로 나누지 않고도 오디오의 겹치는 부분(예: 중단, 교차发言)을 동적으로 처리할 수 있습니다. 이 기술은 대화를 더욱 자연스럽게 만듭니다.
의미 및 음성 토큰의 동기 생성: Moshi는 병렬 의미 및 오디오 토큰 생성 메커니즘을 사용하며, 시간 지연을 도입하여 이러한 토큰 간의 의존성을 최적화합니다. 사용자 및 시스템의 오디오 스트림을 정확하게 모델링함으로써 Moshi는 복잡한 대화 시나리오를 유연하게 처리할 수 있습니다.
듀얼 스트림 오디오 처리: Moshi는 사용자와 시스템의 음성 스트림을 동시에 처리하며, 두 개의 자기회귀 오디오 스트림을 병렬로 모델링하여 전이중(full-duplex) 대화를 구현합니다. 이러한 설계 덕분에 모델은 자연스러운 대화에서의 겹치는 음성과 중단을 처리할 수 있습니다.
의미 및 오디오의 지연 정렬: 의미 토큰과 오디오 토큰 사이에 지연을 도입하여 생성된 음성 내용이 응집력 있고 효율적임을 보장합니다. 지연은 대화 역학에 따라 1~2 프레임이 될 수 있습니다.
Moshi: Multi-stream modeling
7. 모델 학습 및 미세 조정
대규모 사전 학습: Moshi의 텍스트 언어 모델(Helium)은 2.1조 개 이상의 영어 토큰에 대한 사전 학습을 통해 풍부한 언어 이해 및 생성 능력을 갖추고 있습니다. 이 모델은 대규모 텍스트 및 음성 데이터로 학습되어 다양한 복잡한 대화 시나리오를 처리할 수 있습니다.
비지도 및 지도 다단계 학습: Moshi는 먼저 대규모 비지도 음성 데이터에 대해 사전 학습을 수행한 다음, 자연스러운 대화를 포함하는 다중 스트림 데이터에 대해 사후 학습을 수행하고, 마지막으로 실제 대화에서 더 나은 성능을 발휘하도록 지시 미세 조정을 수행합니다.
Helium 사전 학습: 먼저 대규모 텍스트 데이터셋에서 Helium 텍스트 언어 모델을 사전 학습하여 언어 이해 및 추론 능력을 향상시킵니다.
Moshi 사전 학습: 레이블이 없는 오디오 데이터셋에서 다중 스트림 오디오 모델을 학습시켜 음성 생성 및 의미 이해를 처리하도록 합니다.
다중 스트림 미세 조정: 두 채널의 음성 대화 데이터를 포함하는 Fisher 데이터셋을 사용하여 모델을 미세 조정하여 다중 스트림 음성 입력 처리 능력을 향상시킵니다.
지시 미세 조정: 마지막으로 생성된 지시 대화 데이터를 사용하여 미세 조정을 수행하여 자연스러운 대화 시나리오에서 모델의 성능을 향상시킵니다.
데이터 증강: 학습 과정에서 Moshi는 배경 소음 추가 및 사용자 에코 시뮬레이션과 같은 데이터 증강 기술을 사용하여 모델이 다양한 음성 환경에서도 안정적으로 작동하고 견고성을 강화하도록 했습니다.
Moshi의 성능 평가
1. 음성 생성의 품질 및 일관성
음성 명확도: Moshi는 음성 생성에서 뛰어난 성능을 보이며, 실험 결과 고품질이고 이해하기 쉬운 음성을 생성할 수 있음을 보여줍니다. 특히 긴 대화에서 생성 과정에서 음성의 응집력을 유지할 수 있으며, 이는 복잡한 컨텍스트에서 대화 모델의 중요한 성능 지표입니다.
음성의 자연스러움 및 일관성: Mimi 신경 오디오 코덱을 사용하여 Moshi는 고충실도 음성을 생성하고 시스템 음성의 일관성을 유지할 수 있습니다. 또한 모델은 다양한 대화 컨텍스트에 따라 적절한 감정적 어조를 생성하여 사용자 경험의 자연스러움을 향상시킬 수 있습니다.
2. 실시간 응답 성능
낮은 지연: Moshi의 지연 시간은 이론적으로 160밀리초이며, 실제 테스트에서는 약 200밀리초입니다. 이는 Moshi가 사용자 입력에 거의 실시간으로 응답하여 상호작용의 원활함과 사용자 대화 경험을 크게 향상시킬 수 있음을 의미합니다.
전이중 통신 능력: Moshi는 테스트에서 음성을 동시에 수신하고 생성하는 능력을 보여주었습니다. 이러한 전이중 기능을 통해 겹치는 음성과 대화 중단을 처리할 수 있으며, 자연스러운 인간 대화에 가까운 응답 속도를 보여줍니다.
3. 음성 인식 및 대화 이해
자동 음성 인식(ASR): 내면의 독백 방식을 통해 Moshi는 텍스트 및 음성 스트림을 결합하여 음성 인식 정확도를 크게 향상시킵니다. 이 모델은 사용자의 음성 입력을 캡처할 뿐만 아니라 텍스트 예측을 먼저 생성하여 시스템의 응답 정확성을 높입니다.
대화 이해 및 추론 능력: Moshi는 텍스트 이해 및 추론을 위해 Helium 언어 모델을 사용하여 복잡한 질문 처리, 개방형 대화 및 지식 질의응답에서 뛰어난 성능을 발휘합니다. 실험 결과는 Moshi가 컨텍스트를 효과적으로 이해하고 합리적인 답변을 제공할 수 있음을 보여줍니다.
4. 다중 스트림 음성 처리의 견고성
겹치는 음성 처리: Moshi는 평가에서 여러 음성 스트림의 겹치는 대화와 같은 복잡한 대화 시나리오를 처리할 수 있습니다. 이는 자연스러운 대화가 일반적으로 중단과 겹치는 음성을 포함하기 때문에 실제 애플리케이션의 다중 작업 처리에 매우 중요합니다.
다중 컨텍스트 대화 처리: Moshi는 여러 데이터 스트림에서 학습되어 단일 사용자의 음성 스트림이든 여러 사용자와의 동시 대화든 다양한 대화 시나리오에서 잘 수행됩니다.
5. 질의응답 및 지식 획득
Moshi는 질의응답 및 지식 획득 작업에서 현재 다른 음성 대화 시스템보다 우수한 성능을 보입니다. 강력한 텍스트 이해 능력과 실시간 음성 생성 능력을 바탕으로 Moshi는 다회전 질의응답을 처리하고 사용자 질문을 정확하게 추출하여 답변할 수 있습니다.
언어 추론 및 상식 질의응답: 이 모델은 복잡한 추론 작업을 처리할 수 있으며, 상식 질의응답, 독해 및 개방형 질의응답과 같은 자연어 처리(NLP)의 다양한 표준 평가에서 뛰어난 성능을 발휘합니다.
6. 음성 감정 및 개인화된 생성
감정적 음성 생성: Moshi는 평가에서 감정적 음성을 생성하는 능력을 보여주었습니다. 대화의 컨텍스트에 따라 분노, 기쁨, 슬픔과 같은 다양한 감정을 가진 음성 출력을 생성할 수 있습니다.
개인화된 음성 스타일: 학습 과정의 지시 미세 조정을 통해 Moshi는 사용자 요구에 따라 다양한 스타일이나 특정 캐릭터의 음성을 생성할 수 있습니다. 이러한 개인화 능력은 특정 대화 시나리오에서 더욱 다양하게 표현되도록 합니다.
7. 안전하고 신뢰할 수 있음
안전한 대화 평가: Moshi는 민감하거나 부적절한 콘텐츠가 포함된 대화를 처리할 때 양호한 안전성을 보여줍니다. 부적절한 콘텐츠 생성을 효과적으로 식별하고 회피하여 대화의 안전성과 윤리성을 보장합니다.
견고성 및 잡음 환경 적응: 잡음 및 복잡한 환경 평가에서 Moshi는 양호한 견고성을 보여주었습니다. 잡음 추가 및 에코 처리와 같은 데이터 증강 기술을 통해 이 모델은 다양한 음성 환경에 대응하고 잡음 환경에서도 고품질 출력을 보장할 수 있습니다.
8. 종합 테스트 결과
Moshi의 종합 성능 테스트 결과는 음성 생성, 대화 이해, 실시간 응답, 복잡한 대화 처리 등에서 선도적인 성과를 거두었음을 보여줍니다. 특히, Moshi는 겹치는 대화, 음성 중단, 감정 생성 처리 측면에서 전통적인 대화 시스템을 훨씬 능가합니다.
기술 보고서: https://kyutai.org/Moshi.pdf
GitHub: https://github.com/kyutai-labs/moshi
모델 다운로드: https ://huggingface.co/collections/kyutai/moshi-v01-release-66eaeaf3302bef6bd9ad7acd
온라인 체험: https://moshi.chat/
관련资讯:
MoshiVis: 보고 있는 내용을 보고 들을 수 있을 뿐만 아니라 유창한 음성으로 이미지 내용을 함께 논의할 수 있는 시각-음성 모델














