
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
MoshiVis: 듣고 보고, 자연스러운 음성으로 이미지를 토론하는 비전-스피치 모델
小编 ·

MoshiVis: 듣고 보고, 자연스러운 음성으로 이미지를 토론하는 비전-스피치 모델
MoshiVis란 무엇인가요?
MoshiVis는 Moshi를 기반으로 개발된 시각 음성 모델로, Moshi의 낮은 지연 시간과 자연스러운 대화 능력을 유지하면서 자연스러운 대화 스타일로 이미지 콘텐츠에 대해 논의할 수 있습니다. 다중 턴 대화를 지원하며 이미지의 텍스트 콘텐츠를 설명하고 이미지에 관한 질문에 답할 수 있습니다.
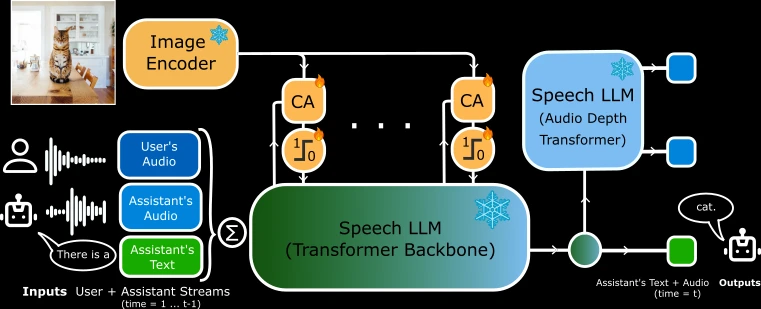
교차 어텐션 메커니즘을 통해 시각 정보를 음성 스트림에 통합하며, 동시에 낮은 지연 시간과 낮은 메모리 사용량을 유지합니다. MoshiVis는 PyTorch, Rust, MLX 등 다양한 백엔드를 지원하고, 사전 학습된 모델과 합성 시각 대화 데이터셋을 공개하여 실시간 음성 상호작용 시나리오에 적합합니다.
MoshiVis 핵심 기능
시각과 음성의 결합: MoshiVis는 Moshi에 시각 이해 능력을 추가하여 이미지 정보를 음성 대화에 통합할 수 있습니다. 핵심 Transformer 아키텍처를 확장하고 교차 어텐션 메커니즘을 도입하여 시각 정보를 음성 스트림에 주입합니다.
낮은 지연 시간과 낮은 메모리 사용량: 낮은 지연 시간을 유지하고 메모리 사용량을 줄이기 위해 MoshiVis의 교차 어텐션 프로젝션 가중치는 각 레이어 간에 공유되며 게이팅 메커니즘을 통해 시각 입력 스트림을 조절합니다.
자연스러운 대화 스타일: 모델은 시각 능력을 통합하면서도 Moshi의 원래 자연스러운 대화 스타일을 유지합니다.
MoshiVis 기술 아키텍처
기반 모델: 7B 파라미터의 음성-텍스트 기반 모델인 Moshi를 기반으로 합니다.
시각 인코더: PaliGemma2 계열의 사전 학습된 고정 400M 시각 인코더를 사용합니다.
어댑터 파라미터: 시각 정보 처리를 위해 Moshi에 약 206M의 어댑터 파라미터를 추가했습니다.
교차 어텐션 메커니즘: 교차 어텐션 모듈을 통해 시각 정보를 음성 스트림에 주입하고, 동시에 게이팅 메커니즘을 통해 시각 입력의 영향을 조절합니다.
MoshiVis 모델 공개
모델 변형: Moshika(여성 음성) 기반의 MoshiVis 모델을 공개했으며, 음성 코덱, 텍스트 토크나이저, 이미지 인코더 및 기본 Moshi 모델을 포함한 전체 모델 가중치가 포함됩니다.
백엔드 지원: PyTorch, Rust, MLX를 포함한 세 가지 백엔드를 지원하며, BF16, Q8_0 등 다양한 양자화 형식을 지원합니다.
라이선스: 모델 가중치(시각 인코더 제외)는 CC-BY 4.0 라이선스로 공개되며, 시각 인코더는 Gemma 라이선스로 공개됩니다.
MoshiVis 사용 방법
WebUI 프런트엔드: 에코 제거를 지원하여 모델 성능을 향상시키는 WebUI 프런트엔드를 제공합니다. 미리 빌드된 정적 버전을 사용하거나 소스 코드를 직접 컴파일하여 사용할 수 있습니다.
백엔드 실행:
PyTorch: 약 24GB GPU 메모리가 필요하며 양자화를 지원하지 않습니다.
Rust: GPU 가속을 지원하며 Rust 도구 체인과 CUDA(macOS의 경우 Metal)가 필요합니다.
MLX: bfloat16 및 양자화(q4, q8) 형식을 지원합니다.
실행 명령: 다양한 백엔드와 양자화 형식을 선택할 수 있는 자세한 실행 명령을 제공합니다.
관련 링크:
GitHub 프로젝트:https://github.com/kyutai-labs/moshivis
HuggingFace 모델:https://huggingface.co/collections/kyutai/moshivis-v01-67cef4acae6a5d75d6d6c883









