
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
바이트댄스 OmniHuman 모델, 지멍에서 내부 테스트 시작
小编 ·

바이트댄스 OmniHuman 모델, 지멍에서 내부 테스트 시작
字节跳动에서 출시한 OmniHuman 모델이 이미 即梦AI에서 베타 테스트 중입니다. 이 모델은全新的多模态비디오 생성 기술을 采用하며, 사용자는 단 한 장의 이미지와一段 오디오만 입력하면 매우 사실적인真人 비디오 애니메이션을 생성할 수 있습니다. 여기에는 facial 표정부터全身 동작까지, 말하기, 노래, 춤 등을 포함합니다.
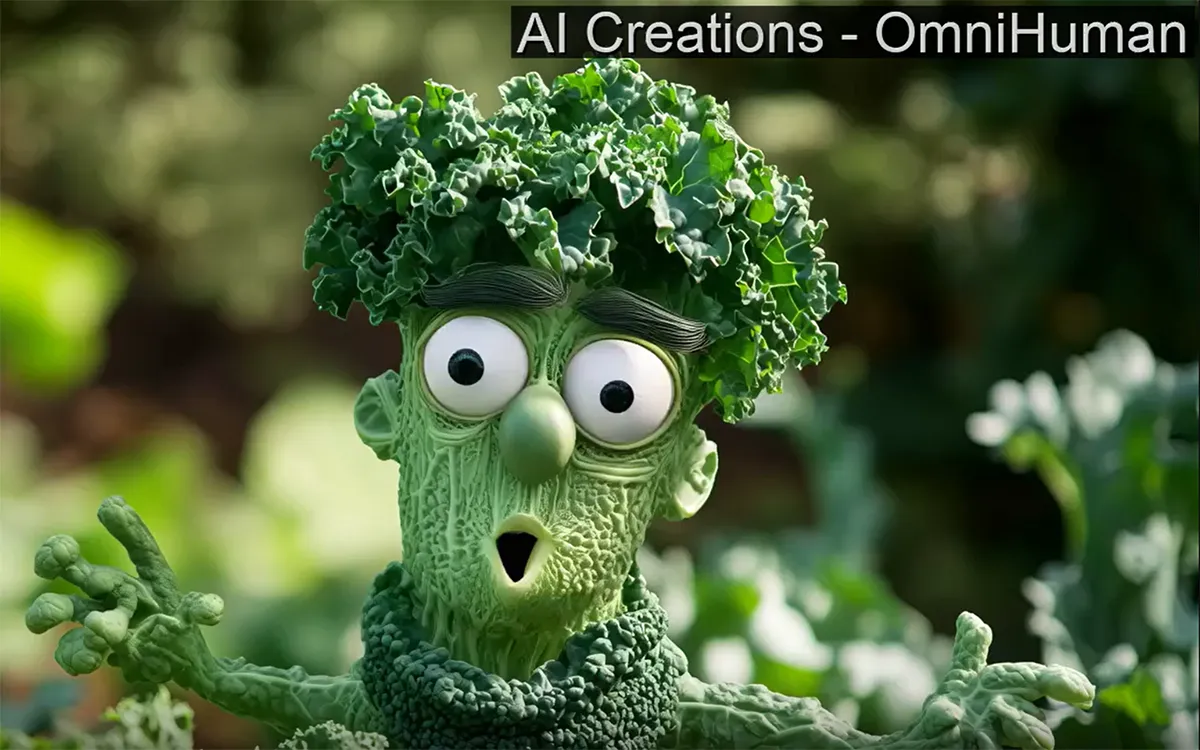
OmniHuman 모델의 주요 기능:
비디오 생성:입력된 단일 사진을 사실적인 전신 동적 비디오로 변환할 수 있으며, 디지털 휴먼이 말하기, 노래 등 다양한 자연스러운 동작을 수행할 수 있도록 합니다.
멀티모달 입력:초상, 반신 및 전신 등 다양한 크기의 이미지 입력을 동시에 지원하며, 오디오 콘텐츠와 결합하여 데이터 학습 효과가 우수하고 고품질의 애니메이션 비디오를 생성할 수 있습니다.
OmniHuman 모델은 초상 및 전신 비디오 생성을 지원할 뿐만 아니라 애니메이션 및 3D 카툰 등 비사실적 이미지를 포함한 다양한 유형의 이미지 입력에서도 만족스러운 성능을 보여줍니다. 即梦ai 관련 책임자는 OmniHuman이 이미 우수한 성능을 보여주었지만 영화급 사실적인 비디오 생성에는 여전히 개선할 여지가 있다고 말했습니다. OmniHuman은 점진적으로 사용이 개방될 예정이며, 현재는 소규모 베타 테스트가 진행 중이며 엄격한 보안 심사 메커니즘이 설정되어 있습니다.
OmniHuman은 어디에 있나요?
即梦AI에 로그인한 후 왼쪽 사이드바에서 비디오 생성을 선택하세요.
저는 현재 베타 테스트를 신청 중입니다...일부 사용자들은 립싱크 효과가 그다지 좋지 않다고 말하지만, 또 다른 사용자들은 매우 훌륭하다고 평가합니다.









