
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
OmniHuman: 엔드투엔드 멀티모달 디지털 휴먼 영상 생성 프레임워크
小编 ·

OmniHuman: 엔드투엔드 멀티모달 디지털 휴먼 영상 생성 프레임워크
OmniHuman은字节跳动의확산 Transformer 기반 멀티모달 디지털 휴먼비디오 생성 프레임워크입니다. 단 한 장의 사진과 한 오디오 클립만으로 비디오를 생성할 수 있으며, 동작, 입 모양, 표정이 거의 완벽에 가깝게 표현됩니다.
OmniHuman 프레임워크는 학습 단계에서 동작 관련 조건을 혼합하여 데이터 규모를 확장하며, 이 프레임워크의 핵심은 다양한 입력 모달리티를 처리하여 더욱 사실적이고 자연스러운 디지털 휴먼 비디오를 생성할 수 있다는 점입니다.
OmniHuman 주요 특징
멀티모달 입력: OmniHuman은 텍스트, 오디오, 비디오 등 다양한 입력 형태를 지원하여, 생성된 디지털 휴먼이 다양한 장면에서 더 풍부한 감정과 동작을 표현할 수 있게 하며, 서로 다른 모달리티 데이터를 융합하여 고품질 데이터 부족의 병목을 돌파합니다.
데이터 규모 확장: 동작 관련 조건을 도입함으로써, OmniHuman은 학습 과정에서 데이터셋을 효과적으로 확장하여 생성 모델의 일반화 능력과 표현력을 향상시킵니다.
고품질 출력: 이 프레임워크는 최첨단 딥러닝 기술을 활용하여 고품질 디지털 휴먼 비디오를 생성하며, 실은 물론 3D 캐릭터와 애니메이션 캐릭터까지 지원하여 라이브 스트리밍, 엔터테인먼트, 교육 등 다양한 분야에 적용할 수 있습니다.
실시간 생성: OmniHuman은 실시간 생성 능력도 갖추고 있어, 사용자가 인터랙티브 장면에서 디지털 휴먼의 피드백과 표현을 즉각적으로 얻을 수 있습니다.
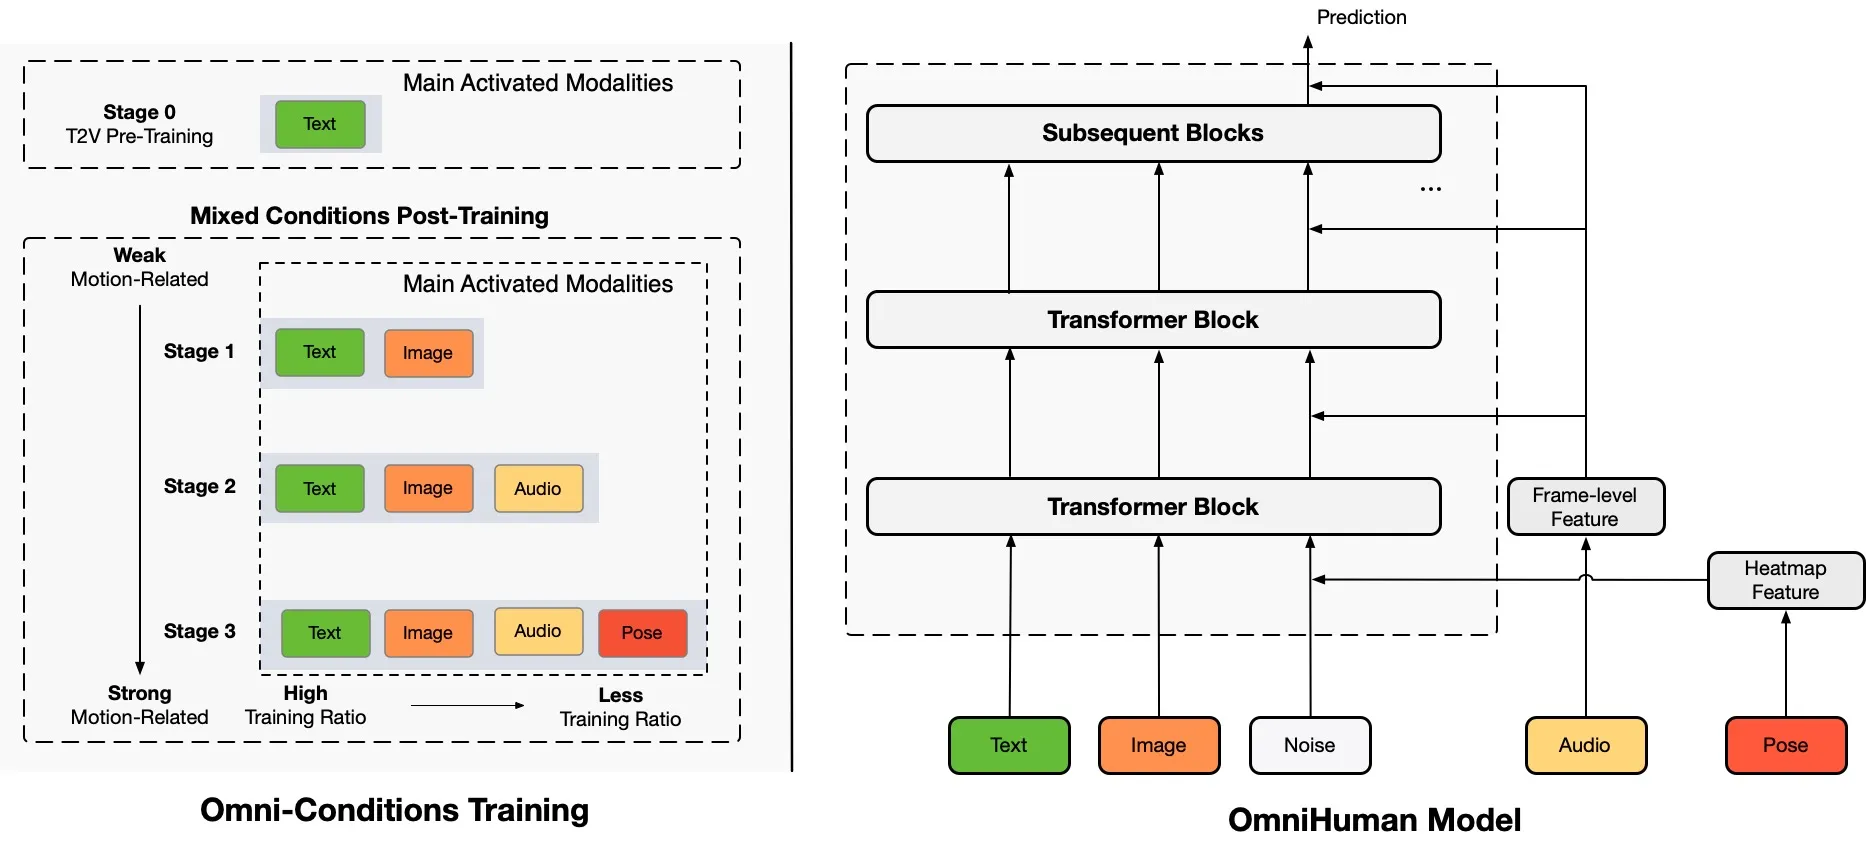
OmniHuman은 오디오驱动, 비디오驱动, 조합驱动 신호를 포함한 다양한驱动 방식을 지원하여 사용자가 입력 측면에서 더 큰 유연성을 갖도록 합니다. 또한 OmniHuman은 인간과 사물 간의 상호작용 및 도전적인 신체 자세를 처리할 수 있어 생성된 비디오의 사실감과 표현력을 더욱 강화합니다. OmniHuman 프레임워크의 설계 철학은 데이터 기반 동작 생성을 충분히 활용하여 궁극적으로 매우 사실적인 인간 비디오 생성을 실현하는 것입니다. 기존의 엔드투엔드 오디오驱动 방식과 비교했을 때, OmniHuman은 더 사실적인 비디오를 생성할 수 있을 뿐만 아니라 입력 측면에서도 더 큰 유연성을 제공합니다. 비디오 샘플은 ttfamily 프로젝트 페이지에서 확인할 수 있으며, 다양한 장면에서의 적용 효과를 보여줍니다.
OmniHuman 활용 시나리오
가상 스트리머: 라이브 스트리밍 플랫폼에서 OmniHuman은 가상 스트리머를 생성하여 실시간 인터랙션과 엔터테인먼트 콘텐츠를 제공할 수 있습니다.
교육 및 트레이닝: 가상 교사를 생성함으로써 OmniHuman은 온라인 교육에서 개인화된 학습 경험을 제공할 수 있습니다.
게임 개발: 게임에서 가상 캐릭터가 OmniHuman으로 생성되어 게임의 몰입감과 인터랙티브성을 향상시킬 수 있습니다.
OmniHuman 프로젝트 주소:https://omnihuman-lab.github.io









