
 脚本プランナー▸
 AIアプリ
 AIニュース

DreamBooth:パーソナライズされたテキストから画像生成技術
DreamBooth:パーソナライズされたテキストから画像生成技術紹介
DreamBoothはGoogle Researchとボストン大学が2022年に発表した個別化されたテキスト-to-イメージ技術です。少数のサンプルを使って事前学習済みの拡散モデルに特定のオブジェクト(人物、ペット、アイテム、特定スタイルなど)を記憶させ、さまざまなシーンやスタイルでそのオブジェクトの高品質な画像を生成できるようにすることを目指しています。最初はGoogleのImagenと共に発表され、その後StableDiffusionなどのモデルにも応用され、個別化生成の定番手法となりました。
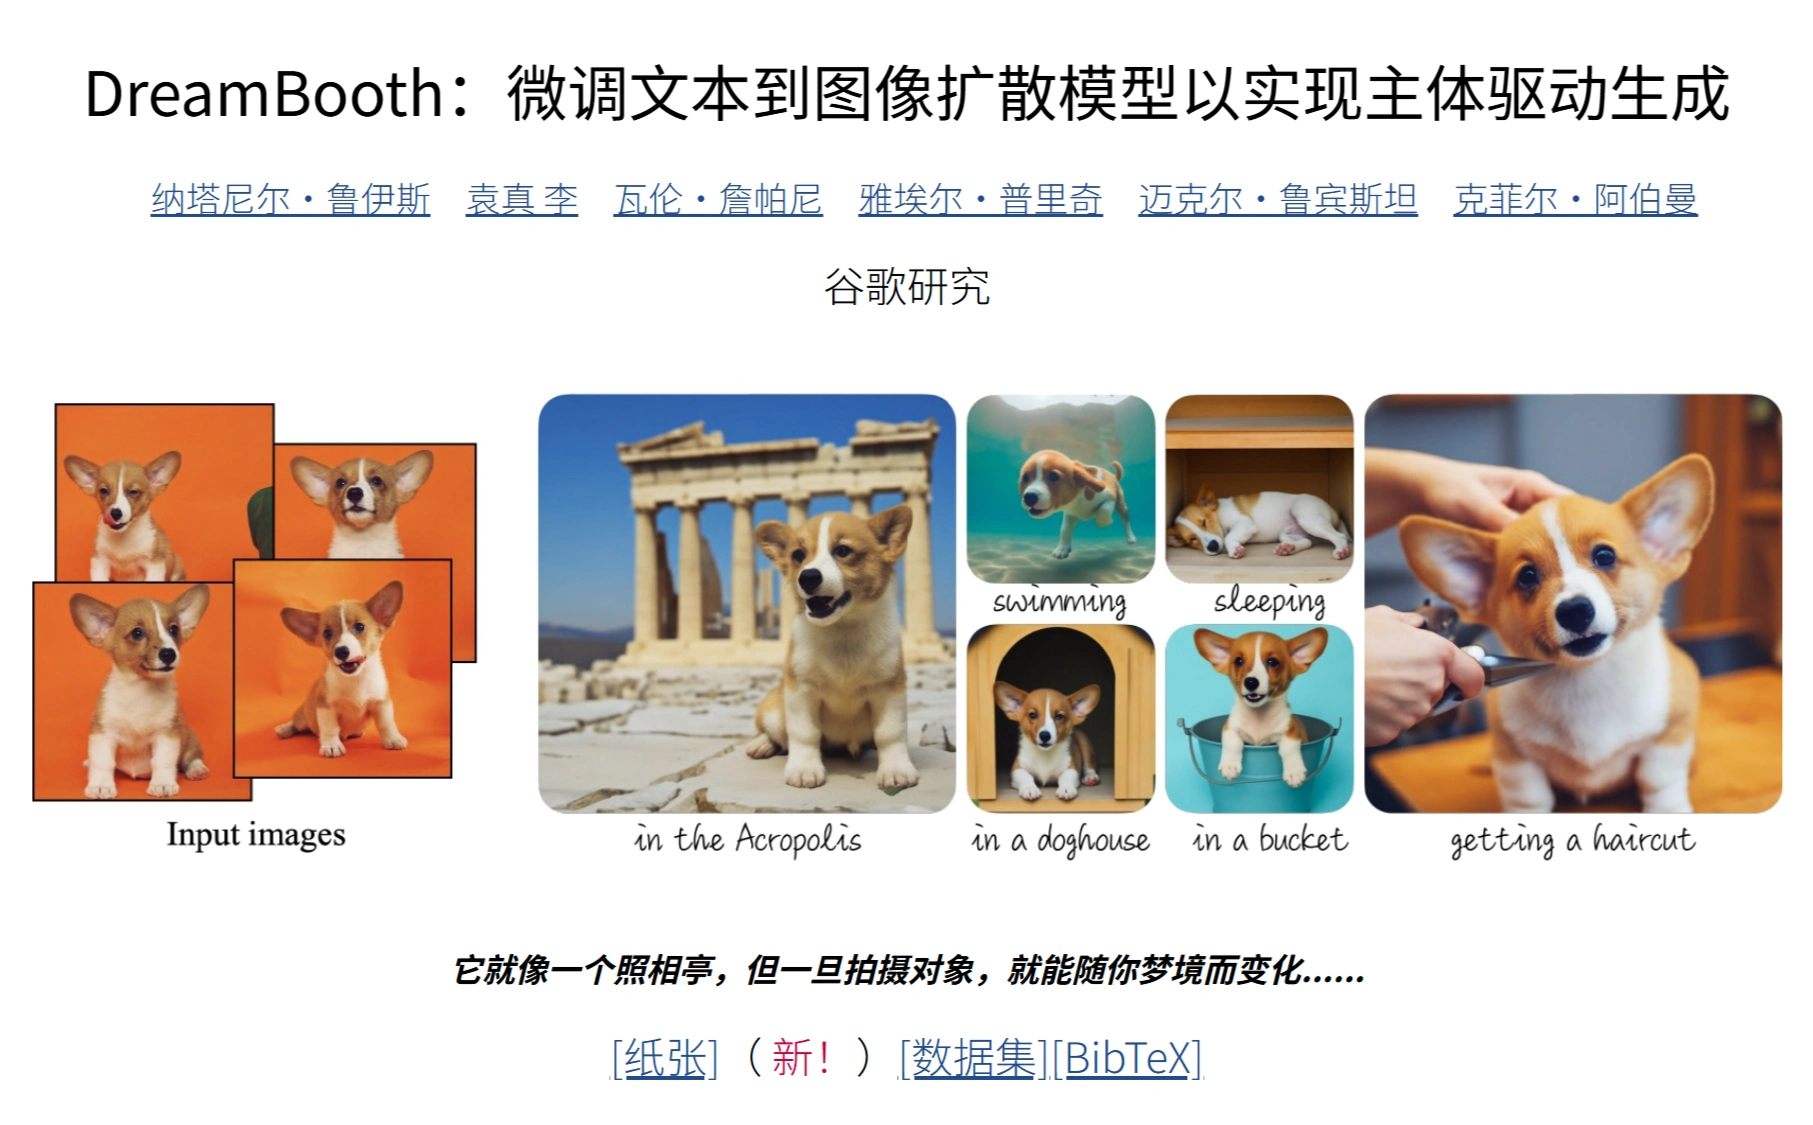
DreamBoothの仕組み
非常に少ない画像でファインチューニングを行います。通常は3〜5枚のオブジェクト画像を用意し、「固有のトークン+クラス名」を含むテキストプロンプト(例:「aphotoof[V]dog」)を組み合わせることで、新しいオブジェクトをモデルの意味空間に結びつけます。
学習時にはクラス固有の事前分布保持損失を加え、モデルが元のクラスの多様な表現を保てるようにします。これにより過学習や言語ドリフトを防ぎ、シーンを変えてもさまざまなオブジェクトを生成できます。
さらに超解像度のファインチューニングを行います。まず低解像度画像を生成し、SRモジュールで段階的に解像度を上げていきます。一般的な流れは64×64→256×256→1024×1024で、ディテールやテクスチャをよりリアルに仕上げます。
DreamBoothの使用手順
まずオブジェクトの高品質な画像を3〜5枚用意します。異なるアングルの方が望ましいです。
オブジェクトに珍しいトークンを付け、シンプルなクラス説明(例:aphotoofsksdog)を記述します。
学習率と参照画像セットを決めてファインチューニングを開始します。シングルGPUの場合、8〜24GBのVRAMが必要で、所要時間は1〜2時間程度です。
学習完了後、「sksdogwearingspacesuitonMars」のようなプロンプトを入力すれば、あなたのコーギーが火星にいる画像を生成できます。
DreamBoothの主な特徴
ごく少数のサンプルで出力を大きく変更できます。
StableDiffusionをはじめ、さまざまなテキスト-to-イメージ拡散モデルに組み込めます。
コミュニティには既存の重み、Colabチュートリアル、各種インタフェースのツールが揃っており、学習も利用も容易です。
DreamBoothのメリットと課題
メリット:
数枚の画像で済み、ペアになったテキストと画像は不要です。
柄、顔立ち、商品ロゴなど、個体固有のディテールを捉えます。
StableDiffusionの豊富な知識に支えられ、生成品質が高く、ディテールがリアルです。
課題:
VRAM要件が高く、全パラメータのファインチューニングには15〜24GB必要です。LoRAを使えば8〜12GBまで下げられます。
過学習しやすく、コントロールを誤るとモデルが学習対象しか認識しなくなり、同じクラスの別のものを生成する際に破綻することがあります。
LoRAが30〜60分で済むのに対し、DreamBoothの全ファインチューニングは1〜2時間かかり、学習に時間がかかります。
DreamBoothの一般的な利用シーン
人物やペットのバーチャルアバター作成。自分自身や犬猫をゲームや映画のシーンに登場させられます。
商品のカスタマイズ画像制作。製品写真をアップロードすれば、さまざまなスタイルの広告画像を一度に生成できます。
キャラクターデザイン。映画やゲームの会社であれば、同一キャラクターの異なるポーズや光源のカットを素早く作成できます。
注意点
学習には大量のVRAMを消費するため、一般的なGPUでは高額になります。クラウドGPUや最適化手法を使えばコストを抑えられます。
画像は3〜10枚用意するのが望ましく、異なるアングル、異なる背景、鮮明なものを使用すると、生成結果がより安定し、より似てきます。
つまりDreamBoothとは、大モデルに小さな個別オブジェクトを記憶させる手法であり、aiGC分野における代表的な個別化画像生成手法の一つで、アニメ制作にも適しています。













