
 脚本プランナー▸
 AIアプリ
 AIニュース
Step-Video-T2V:先進的なテキストから動画生成モデル
Step-Video-T2V:先進的なテキストから動画生成モデル紹介
Step-Video-T2Vは、ステップフンと吉利汽車が提携してオープンソース化した、先進的なテキストから映像生成モデルです。多くの優れた特性を備えており、映像生成分野において強力な実力を発揮します。
Step-Video-T2Vモデルのハイライト
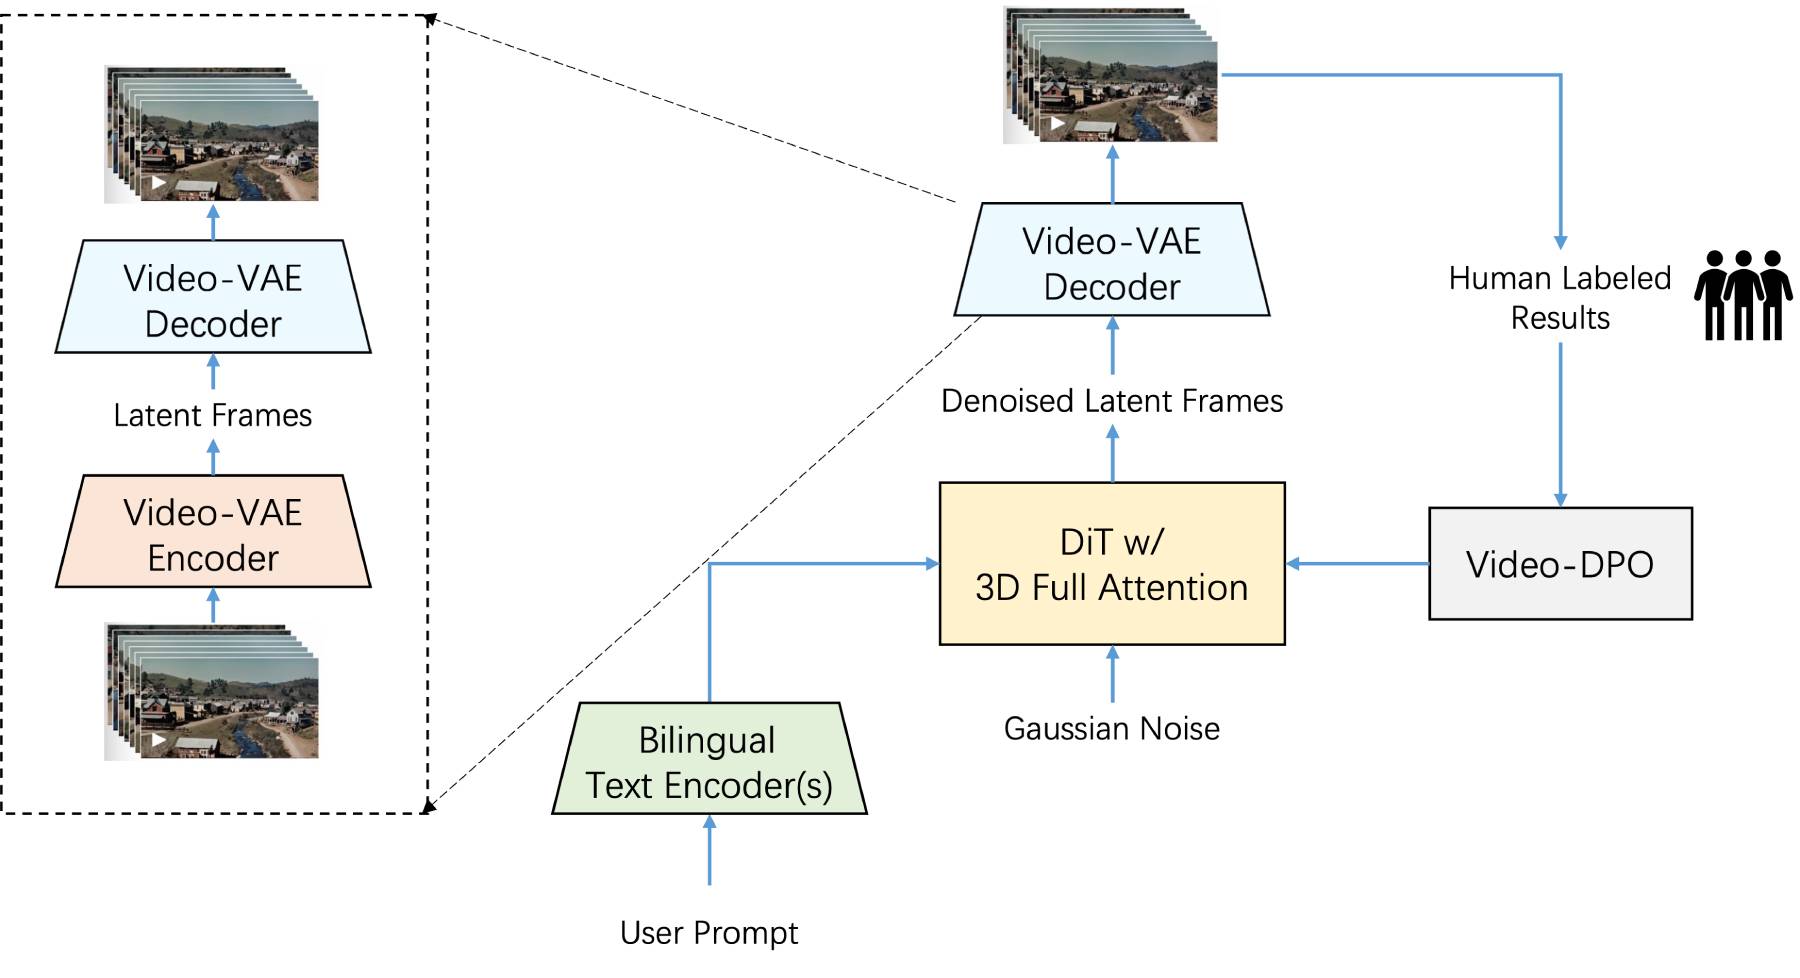
DiTモデルとフローマッチング学習手法を採用し、16×16倍の空間圧縮と8倍の時間圧縮を実現し、大規模ビデオ生成の効率を大幅に向上させました。
300億という巨大なパラメータ数を持ち、最大544x992という高解像度のビデオを生成可能です。
中国語と英語のプロンプト入力に対応しており、異なる言語環境のユーザーが利用できます。
Step-Video-T2Vの主な機能と特徴
大規模パラメータ:パラメータ数は300億に達し、モデルに極めて高い生成能力と正確性を与え、テキスト記述をより正確に理解し、高品質な映像へと変換することを可能にします。
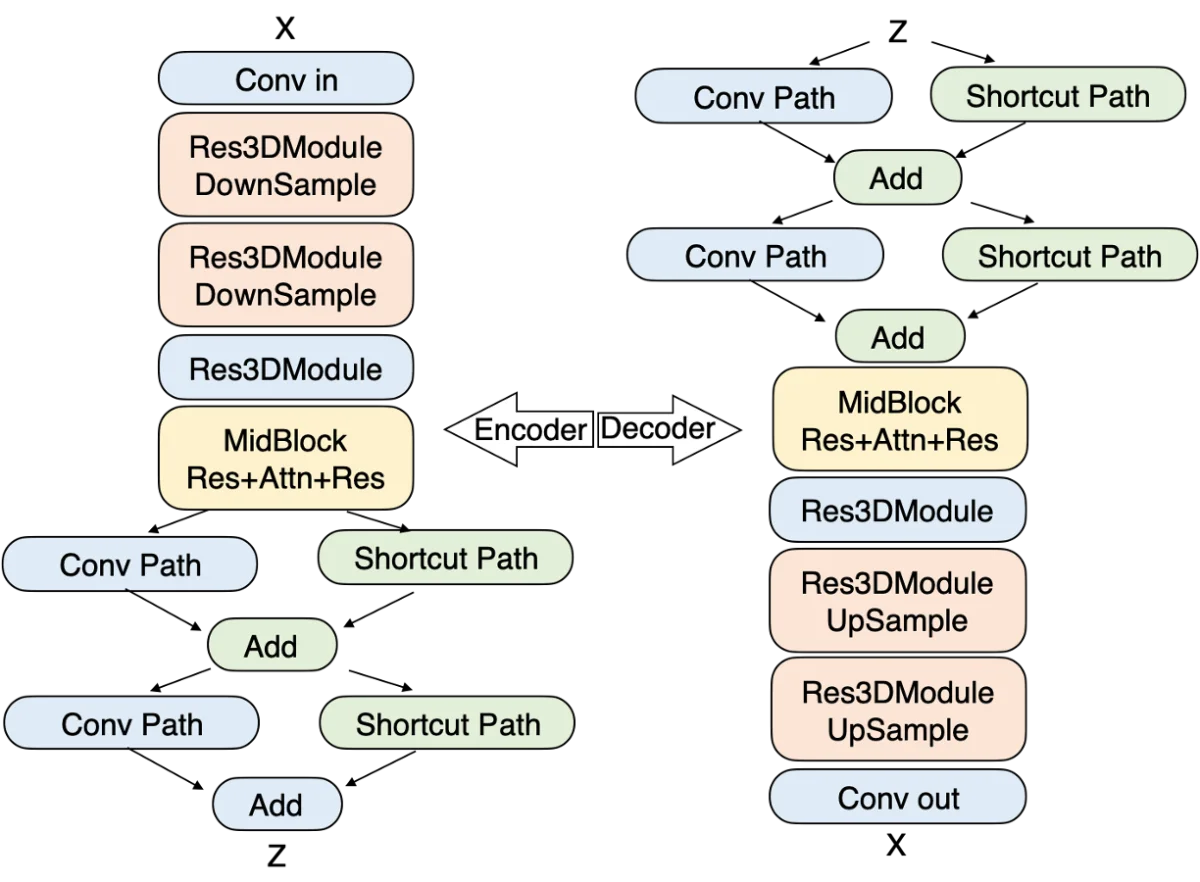
効率的な映像生成:最大204フレーム(544x992ピクセル)の高品質な映像生成をサポートし、多様化する創作ニーズに対応します。深層圧縮型変分自己符号化器(Video-VAE)を採用し、16×16の空間圧縮と8倍の時間圧縮を実現。映像品質を保ちながら、学習と推論のコストを効果的に削減しています。
バイリンガルテキストエンコーダ:中国語と英語の入力に対応し、テキスト記述を深く理解してそれに合致する映像コンテンツを生成できるため、異なる言語のユーザーが便利にモデルを利用できます。
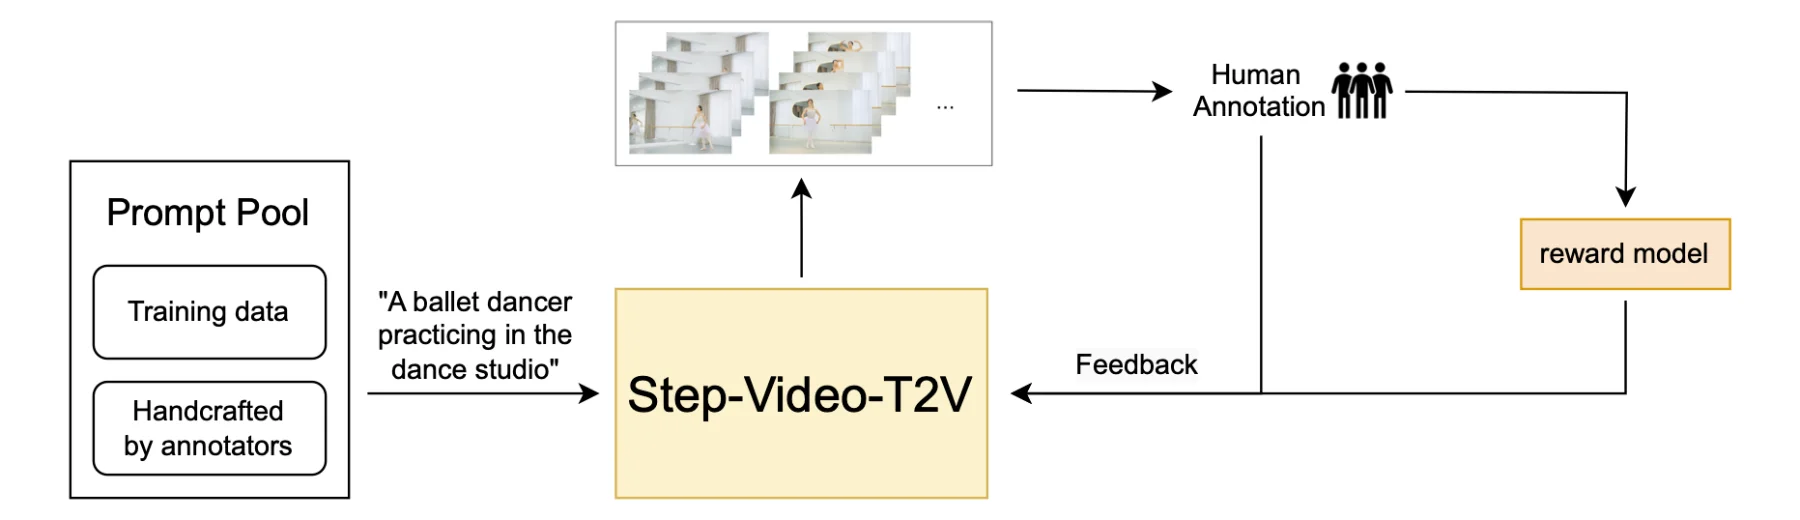
先進的なアーキテクチャ:3DフルアテンションDiTアーキテクチャを採用し、動的な解像度の変化に柔軟に対応し、安定性と高品質な映像生成を保証します。また、映像嗜好最適化(Direct Preference Optimization、DPO)を導入し、人間のフィードバック機構を通じて生成映像の品質と滑らかさをさらに向上させ、ユーザーの期待により合致したものにしています。
マルチモーダル融合:画像、音声、テキストの3つのモーダルからの理解能力を組み合わせることで、生成されるコンテンツの細部がよりリアルになります。例えば、生成される人物の表情がより生き生きとし、光と影の変化がより自然に、動的物体の表現がより滑らかでリアルになります。
柔軟な操作モード:基本版(50ステップ生成)とTurboバージョン(15ステップ蒸留加速)が用意されており、異なるユーザーがさまざまなシナリオで求める性能ニーズに応えます。実際の運用では、204フレームの映像生成には80GBのVRAMを搭載したGPUが約4基必要で、所要時間は約12分です。
Step-Video-T2Vの活用シーン
クリエイティブ映像制作:映像制作者が複雑なシーンや精緻なクリエイティブ映像コンテンツを生成するのを支援し、広告制作やショートビデオ制作などの領域に非常に適しています。
アニメーション・映画・テレビ制作:アニメーションや映画、テレビ業界で、高品質なバーチャルキャラクター、動的シーン、複雑な動作の生成に利用できます。
教育・研修:インタラクティブ性の高い教学映像を作成でき、教学プロセスにより生き生きとした面白さを加え、学生の参加意識と学習効果を高めます。
エンターテインメント産業:ゲームCG、映画予告編、その他のエンターテインメントコンテンツを自動生成でき、大幅な時間と人件費の節約になります。
文化伝播:特に中国風の美学において優れた性能を発揮し、水墨画や古風シーンなどのコンテンツを生成でき、伝統文化のデジタル伝播に寄与し、伝統文化を新しい時代に新たな活力を与えることができます。
Step-Video-T2Vの使用方法:
1. 依存関係のインストール:
必要なPythonライブラリと依存関係をインストールします。通常、pipやその他のパッケージ管理ツールでインストールできます。
pip install transformers torch torchvision torchaudio
2. 環境設定:
実行に必要なハードウェア環境を構築します。最低でも80GBのVRAMを搭載したNVIDIA GPUを4基用意することを推奨します。
モデルの重みファイルをダウンロードし、指定されたディレクトリに解凍します。
3. モデルのロード:
Hugging Face Transformersライブラリを使用して、事前学習済みのStep-Video-T2Vモデルをロードします。
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "stepfun-ai/Step-Video-T2V"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
4. 映像の生成:
テキストプロンプトを準備し、モデルが処理できる形式に変換します。
生成スクリプトを起動し、出力結果を待ちます。
input_text = "A red-haired woman performing on stage."
inputs = tokenizer(input_text, return_tensors="pt")
# Generate video frames (this is a simplified example; actual implementation may vary)
outputs = model.generate(**inputs, max_length=204)  # Adjust parameters as needed
# Save or display the generated video frames
5. 後処理:
生成された映像フレームに対して、完全な映像への連結や音声の追加など、後処理を行います。
リソースへのアクセス:
GitHubリポジトリ:https://github.com/stepfun-ai/Step-Video-T2V
Hugging Faceデモ:https://huggingface.co/stepfun-ai














