
 脚本プランナー▸
 AIアプリ
 AIニュース

JanusFlow:DeepSeek推出的マルチモーダルAIモデル
JanusFlow:DeepSeek推出的マルチモーダルAIモデル紹介
DeepSeekチームが発表した高度なマルチモーダル人工知能モデルで、視覚理解と生成タスクの統一を目指しています。自己回帰言語モデル(LLM)とRectified Flow技術を組み合わせることで、単一モデルで画像理解とテキストから画像生成を同時に処理する能力を実現しています。
コア機能
画像理解:画像内容を分析して関連説明を生成でき、視覚的質問応答、画像タグ付けなどのタスクをサポートします。
テキストから画像生成:テキスト記述に基づいて高品質な画像を生成し、クリエイティブデザインや広告などの分野に応用できます。
マルチモーダルタスクの統合:理解と生成タスクを一つのモデルに統合し、従来の方法で複数の独立したモデルを維持する必要があった複雑さを回避します。
エンドツーエンド学習:視覚エンコーダーを自己回帰言語モデルの理解フレームワークとRectified Flowに基づく生成フレームワークに直接融合させることで、エンドツーエンドの学習を実現しています。
技術的特徴
自己回帰言語モデルとRectified Flowの融合:自己回帰言語モデルとRectified Flow技術を融合させることで、JanusFlowは効率的な画像生成と理解能力を実現しています。Rectified Flowは常微分方程式(ODE)に基づく生成モデリング手法で、学習プロセスを簡素化し、生成品質を向上させます。
分離された視覚エンコーダー:JanusFlowは理解タスクと生成タスクにそれぞれ独立した視覚エンコーダーを設計し、タスク間の干渉を回避するとともに、表現アラインメント戦略により意味的一貫性を強化しています。
分類器なしガイダンス(CFG):画像生成プロセスにおいて、JanusFlowはCFG技術を使用して生成画像とテキスト条件のアラインメントを制御し、画像品質を向上させています。
パフォーマンス
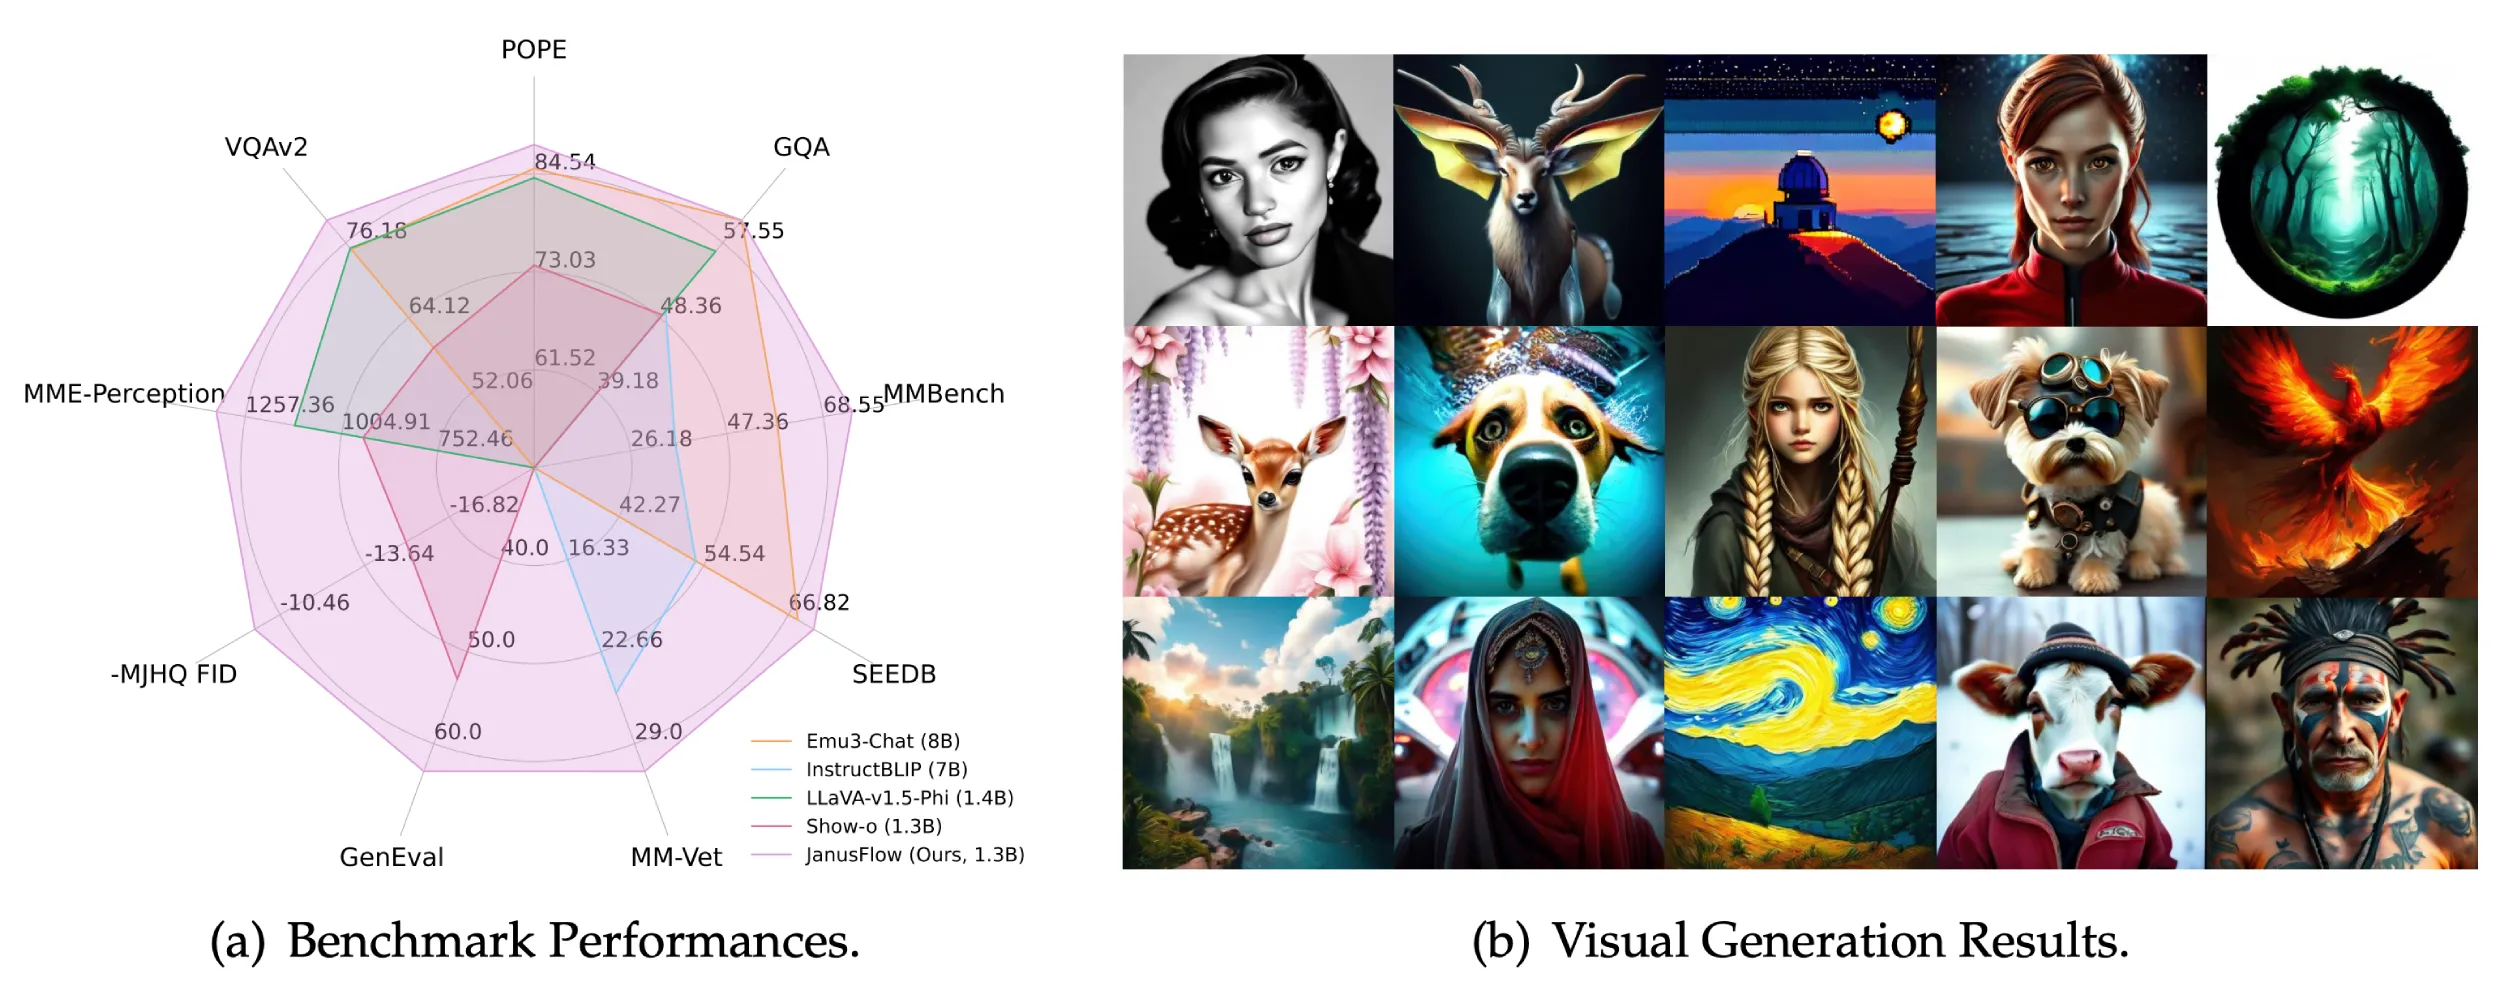
画像生成:GenEvalおよびDPG-Benchテストにおいて、JanusFlowはStable Diffusion v1.5やSDXLを上回るパフォーマンスを示し、生成画像の意味的正確性と視覚品質の両方で最先端レベルを達成しています29。
画像理解:MMBench、SeedBench、GQAなどの視覚理解タスクにおいて、JanusFlowのスコアはそれぞれ74.9、70.5、60.3で、同規模の複数の專門モデルを上回っています。
技術的優位性
JanusFlowの設計理念は、シンプルなアーキテクチャで複雑な機能を実現することにあります。事前学習済みの視覚エンコーダーと大規模言語モデルの組み合わせを活用することで、モデル全体のパフォーマンスと効率が向上しています。この革新的なアーキテクチャにより、JanusFlowはマルチモーダルai分野で最先端に位置し、幅広い応用の可能性を備えています。
学習戦略
適応段階:コンポーネントをランダムに初期化し予備学習を行い、新しいモジュールを事前学習済みモデルと効果的に協調させます。
統一事前学習:マルチモーダル理解、画像生成、純粋テキストデータを組み合わせて学習し、生成データの比率を徐々に増やしていきます。
教師あり微調整(SFT):指示調整データを使用してモデルをさらに微調整し、応答能力と生成品質を向上させます。
応用シナリオ
クリエイティブデザイン:テキスト記述に基づいて高品質な画像を生成し、広告、ゲーム開発などのシナリオをサポートします。
視覚的質問応答:教育、博物館案内などの分野で、画像に基づく intelligentな質問応答サービスを提供します。
マルチモーダルコンテンツ制作:テキストと画像を組み合わせて新しいメディアコンテンツを生成し、ソーシャルメディア、ニュース報道などに応用できます。
オープンソースとリソース
JanusFlowはオープンソースプロジェクトであり、関連リソースには以下が含まれます:
GitHubリポジトリ:https://github.com/deepseek-ai/Janus
モデルダウンロード:Hugging Face
オンライン体験:Demo
技術論文:arXiv
関連ニュース:















