
 脚本プランナー▸
 AIアプリ
 AIニュース

DeepSeek:深度求索が独自開発した大規模言語モデル
DeepSeek:深度求索が独自開発した大規模言語モデル紹介
DeepSeekは、有名なプライベートエクイティ大手である幻方量化傘下の人工知能会社である深度求索(DeepSeek)が自社開発した大規模言語モデルに基づく intelligent assistant です。最新のDeepSeek-R1-Lite-Previewモデルは、論理推論、数学的推論、リアルタイム問題解決において優れた性能を発揮します。128Kのコンテキスト長をサポートしています。
DeepSeekモデルの特徴:
DeepSeekのR1-Lite-Previewモデルは推論能力に特化しており、論理推論と数学的推論を行うことができます。
モデルは「思考の連鎖(Chain of Thought)」推論能力を示し、ユーザーはモデルの論理的ステップをリアルタイムで観察することができます。
DeepSeek-V2モデルは、AlignBenchやMT-Benchなどのベンチマークテストで優れた性能を発揮します。
DeepSeek Coderは複数のプログラミング言語をサポートし、1Bから33Bまでの多様なモデルサイズを提供します。
DeepSeekのモデルは最大128Kのコンテキスト長をサポートし、複雑なタスクに対応できます。
DeepSeekの使用シーン:
ビジネス分析:DeepSeek-R1は複雑なデータ分析タスクを処理でき、企業が市場トレンドの予測や意思決定支援を行うのをサポートします。
医療画像認識:医療分野において、DeepSeek-R1は医療画像の分析に使用でき、医師による迅速な診断を補助します。その推論モデルは重要な特徴を抽出し、画像認識の精度を向上させます。
金融リスク管理:金融業界において、DeepSeek-R1はリスク評価と管理に使用できます。
学術研究:DeepSeekモデルは、複雑な論理問題や数学的な難題の解決において優れた性能を発揮します。その長い思考の連鎖能力により、研究者は深い推論と検証を行うことができます。
プログラミングとコード生成:DeepSeek-R1はプログラミング分野で優れた性能を発揮し、開発者が高品質なコードを生成し、プログラミングにおける複雑な問題を解決するのを支援します。
DeepSeekのコア技術とトレーニング:
アーキテクチャと規模:DeepSeekは自己回帰型Transformerデコーダーアーキテクチャに基づき、70億パラメータと670億パラメータの2つのバージョンを提供し、マルチヘッドアテンション(MHA)とグループ化クエリアテンション(GQA)技術を活用してパフォーマンスを最適化しています。
データ事前トレーニング:2兆個の中英トークンを含む庞大なデータセットで事前トレーニングされており、これにより強力なバイリンガル処理能力がもたらされています。
パフォーマンス最適化:従来のコサイン学習率減衰とは異なる独自の学習率調整戦略を採用し、学習効率を向上させています。
DeepSeekの性能
ベンチマークテスト:TriviaQA、MMLU、GSM8K、HumanEvalなどの標準テストで優れた性能を発揮し、特に中国語による質問応答においてGPT-3を上回ります。
数学とプログラミング:ハンガリー高校数学試験で65点を獲得し、LeetCodeプログラミングテストでは同類モデルを上回る性能を示し、数学およびプログラミング分野における強力な応用可能性を示しています。
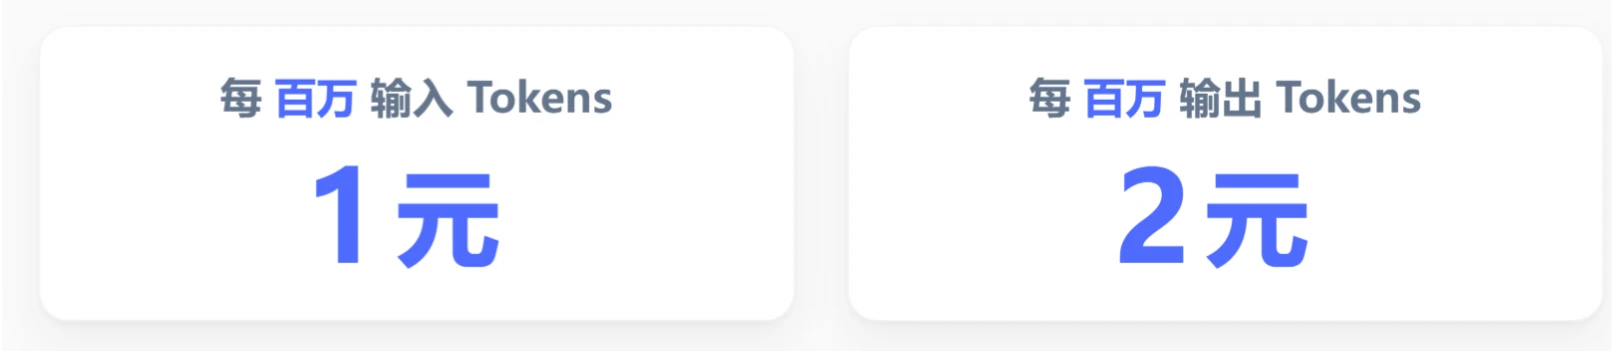
DeepSeek APIの料金
入力100万トークンあたり1元
出力100万トークンあたり2元
新しい推論モデルDeepSeek-R1-Liteがウェブ版に正式にリリースされました。「深度思考」モードをオンにして今すぐ体験してください。
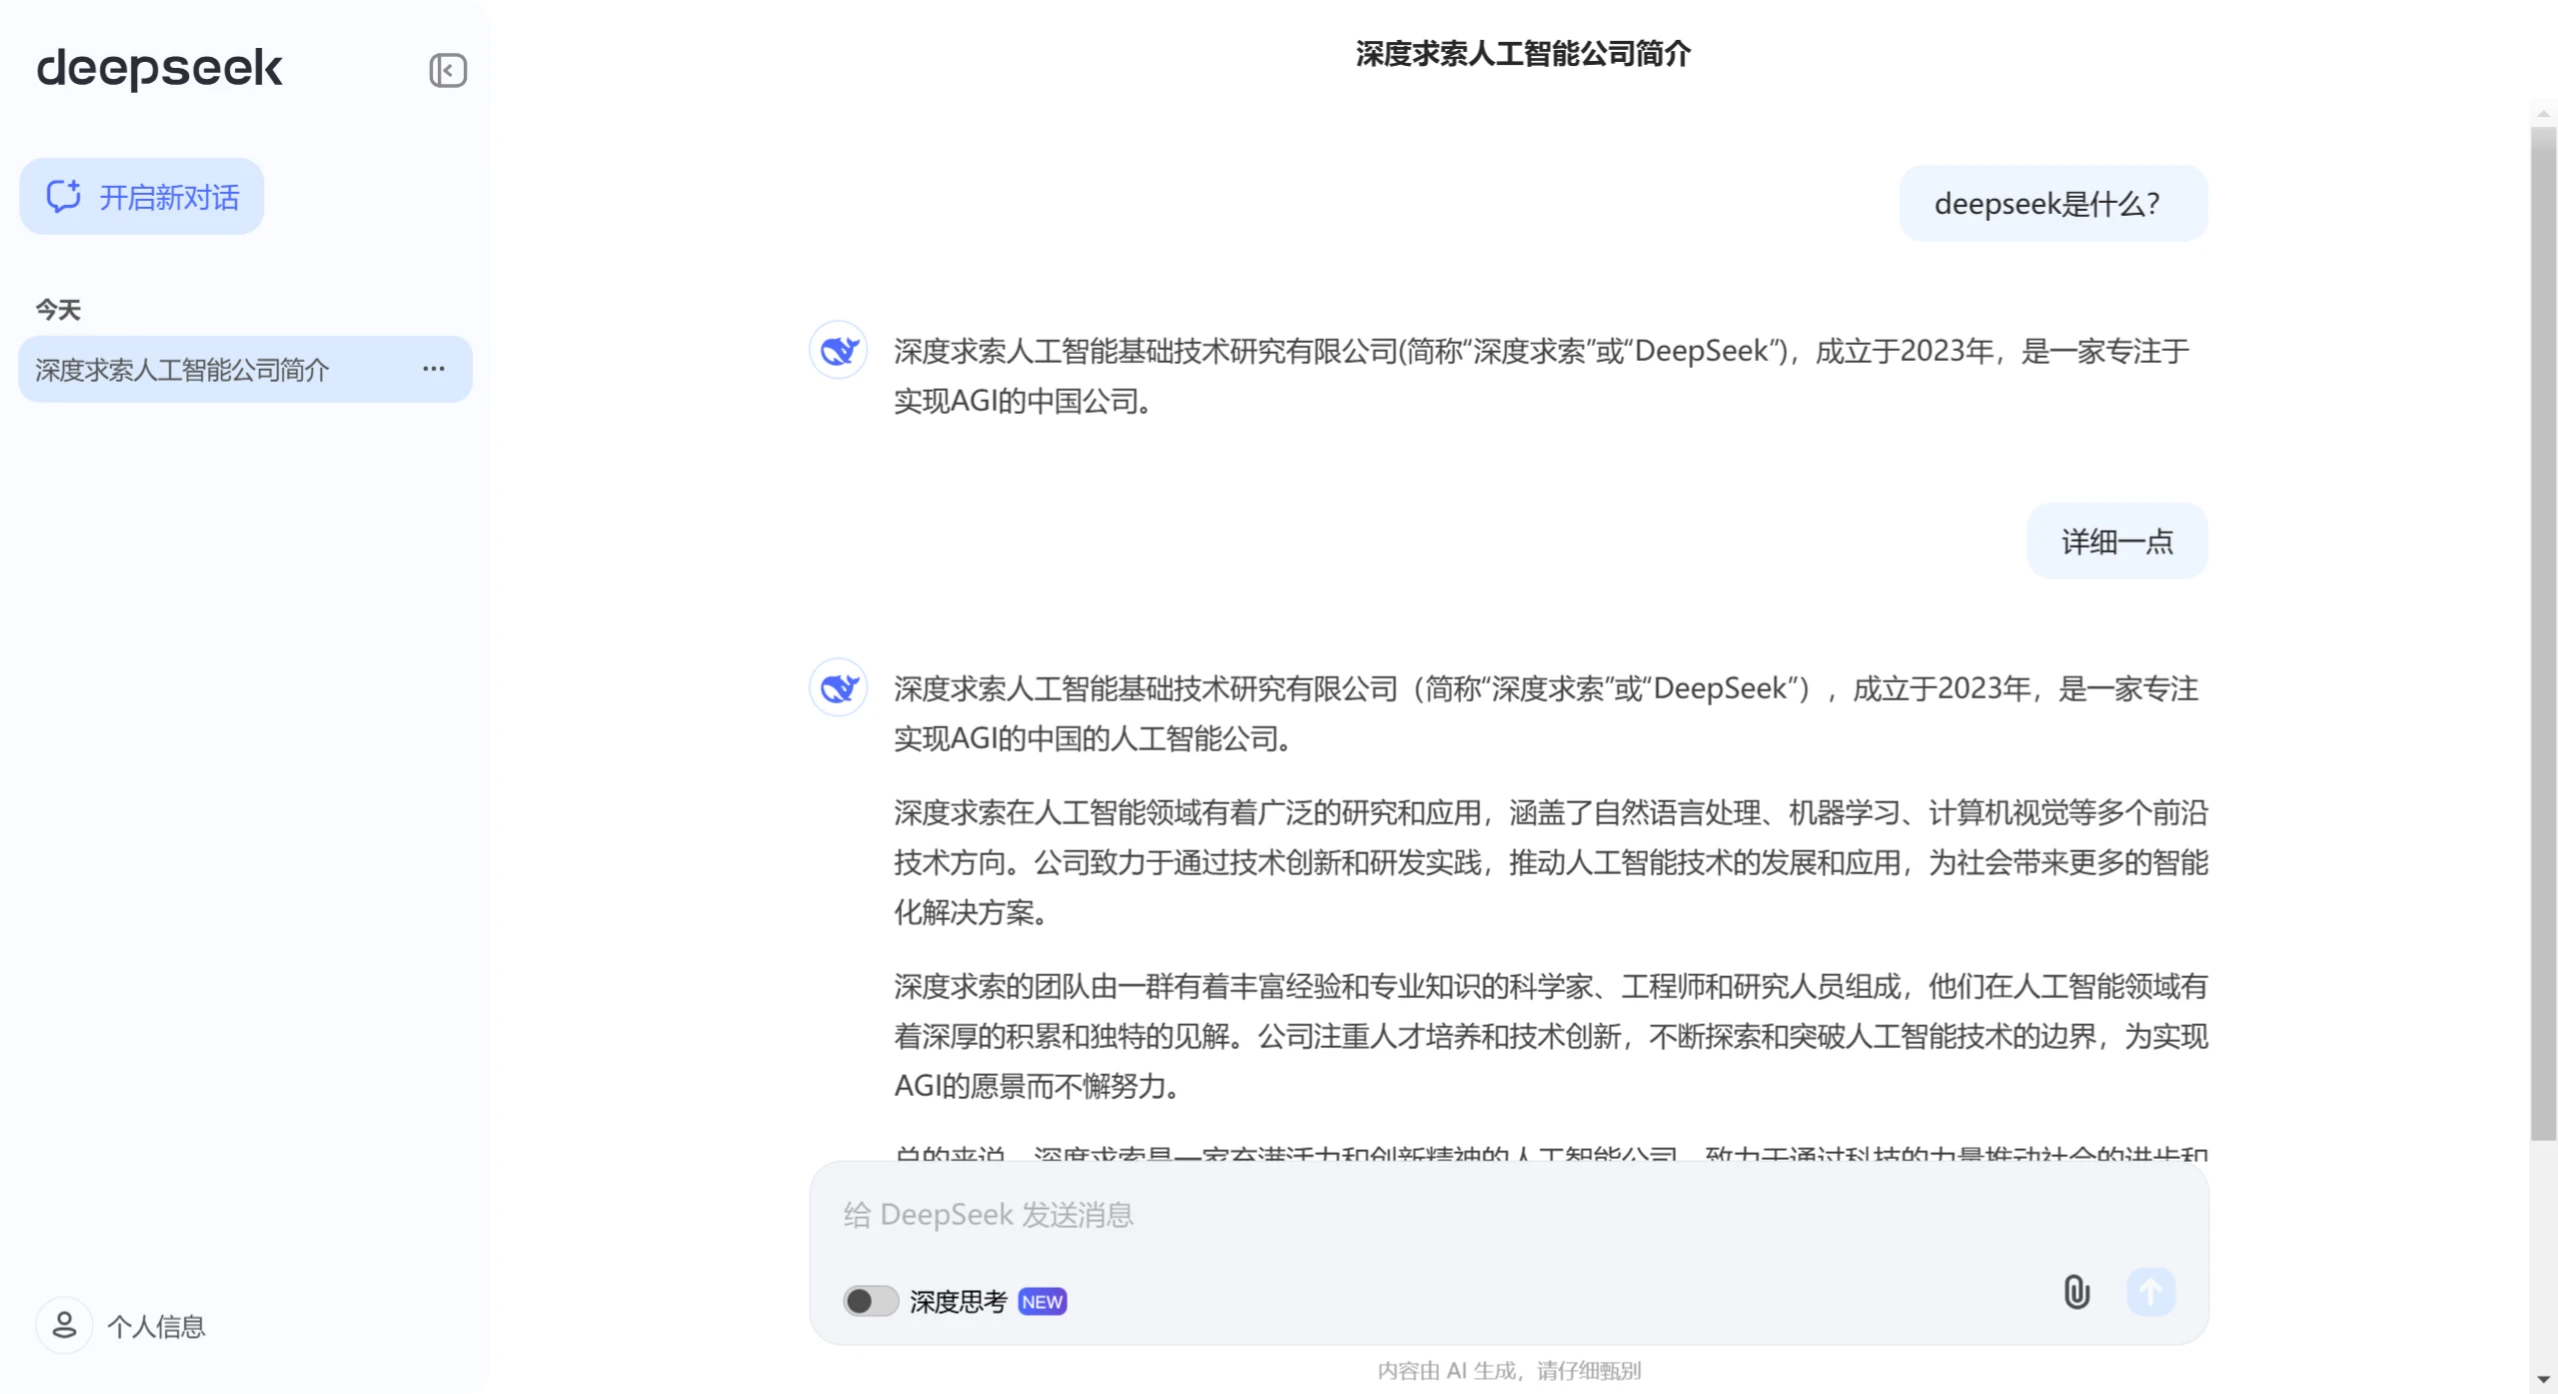
深度求索人工智能基础技术研究有限公司(略して「深度求索」または「DeepSeek」)は、2023年に設立された、AGIの実現に焦点を当てた中国企業です。
関連情報:
DeepSeek R2或在3月17日发布,更好的编码、多语言推理、更低成本















