
 脚本プランナー▸
 AIアプリ
 AIニュース
Moshi:オープンソースのリアルタイム音声変換モデル
Moshi:オープンソースのリアルタイム音声変換モデル紹介
Moshiは、マルチストリームのリアルタイム音声生成Transformerモデルであり、全二重音声対話をサポートしています。主な特徴として、音声入力と出力を同時に行う(全二重)ことや、重複音声や割り込み、感情表現などの非言語情報を含む複雑な対話シナリオを処理する能力が挙げられます。
これは、聞き取りと発話を同時に行うことができるということであり、従来の対話システムにおける遅延、非言語情報(感情など)の喪失、そして対話ターンの硬直した構造といった問題の解決を目指しています。
全二重通信:従来の対話システムはターン制です(一人が話し終えてからもう一人が話し始める)。Moshiはこの制限を突破し、全二重通信をサポートします。これは、Moshiがユーザーの発言中にターン制限なく音声応答を生成でき、重複音声や割り込み、迅速なフィードバックといった複雑な対話のダイナミクスを処理できることを意味します。
マルチストリーム処理:Moshiは複数のオーディオストリームを処理することで、聞き取りと音声生成を同時に実現します。このマルチストリームアーキテクチャにより、ユーザーとシステム間の音声インタラクションを中断させることなく柔軟に処理できます。
従来の音声対話システムと比較して、Moshiにはいくつかの顕著な利点があります。
リアルタイム応答:Moshiの応答速度は非常に速く、遅延はわずか160〜200ミリ秒で、自然な会話における反応速度に近いため、よりスムーズな対話体験を提供できます。
音声対音声処理:従来のシステムは通常、音声→テキスト→音声のプロセスに依存していますが、Moshiは音声入力を直接処理して音声出力を生成し、语调や感情などの非言語情報を保持します。
全二重対話:Moshiは厳格な対話ターンに依存せず、ユーザーとシステム音声を同時に処理できます。これは、重複音声や割り込みを処理でき、より人間の自然な会話に近い形式で行えることを意味します。
Moshiの主な特徴:
リアルタイム音声対話:Moshiは従来の音声→テキスト→音声のプロセスに頼るのではなく、音声入力から直接音声出力を生成します。音声データを直接処理することで、Moshiは语调、感情、重複音声、割り込みなどの非言語情報を保持し、より自然でスムーズな対話を保証します。
全二重通信:Moshiは聞き取りと発話を同時に行うことができ、厳格な対話ターンを必要とせず、ユーザーが話している間に音声応答を生成できます。重複音声や、いつでも挿入できる途切れないフィードバック(例えば「うん」や「なるほど」など)といった複雑な対話シナリオを処理できます。
低遅延:Moshiの設計遅延は非常に低く、理論的にはわずか160ミリ秒、実際には約200ミリ秒です。これは、Moshiがユーザー入力にほぼリアルタイムで応答でき、よりスムーズな対話体験を提供できることを意味します。
内面モノローグ法:Moshiは音声を生成する前にテキストトークンを予測し、これにより生成される音声の言語品質と一貫性が大幅に向上します。これは生成される音声をより明瞭にするだけでなく、ストリーミング環境におけるシステムの音声認識やテキスト読み上げ能力も向上させます。Moshiは「内面モノローグ」メカニズムを導入することで、ストリーミング音声認識(ASR)とテキスト読み上げ(TTS)機能を実現し、連続的な対話フローにおける言語と音声の同時処理をサポートしています。
複数のオーディオストリームの並列処理:Moshiはユーザーとシステムの音声ストリームを同時に処理できます。このマルチストリーム処理能力により、Moshiは自身の音声を生成するだけでなく、ユーザーの音声をリアルタイムで理解し応答することができます。
感情と音声ダイナミクスの処理:Moshiは中間テキストではなく音声を直接処理することで、感情豊かな音声を理解・生成し、感情表現や声の変化などの複雑な対話ダイナミクスを処理できます。
複雑な対話ダイナミクスのサポート:Moshiは自然な対話における複雑なダイナミクス、例えば割り込み、交互発話、間投詞、応答などを処理できます。従来のシステムは明確な対話ターン(別の人がターンする前に発言する)に依存していますが、Moshiはこの制限を排除し、より自然な対話を実現します。
Moshiのモデルアーキテクチャ
Moshiは主に3つの部分で構成されています。2.1兆トークンで学習された7B言語モデルであるHelium、意味情報と音響情報の両方をモデル化するニューラルオーディオコーデックであるMimi、そしてユーザーとMoshiの音声をそれぞれモデル化できる新しいマルチストリームアーキテクチャです。
これらのモジュールが連携して動作することで、流暢な全二重対話、感情表現、そして複雑な対話ダイナミクスの処理を実現します。
Heliumテキスト言語モデル
HeliumはMoshiの中核です。Transformerアーキテクチャ(GPTと同様)に基づく、70億パラメータを持つテキスト言語モデルです。HeliumはMoshiに強力な言語理解および生成能力を提供し、複雑なテキスト推論や対話タスクを処理できます。
学習データには2.1兆語の英語が含まれており、幅広い知識と言語能力を備えています。
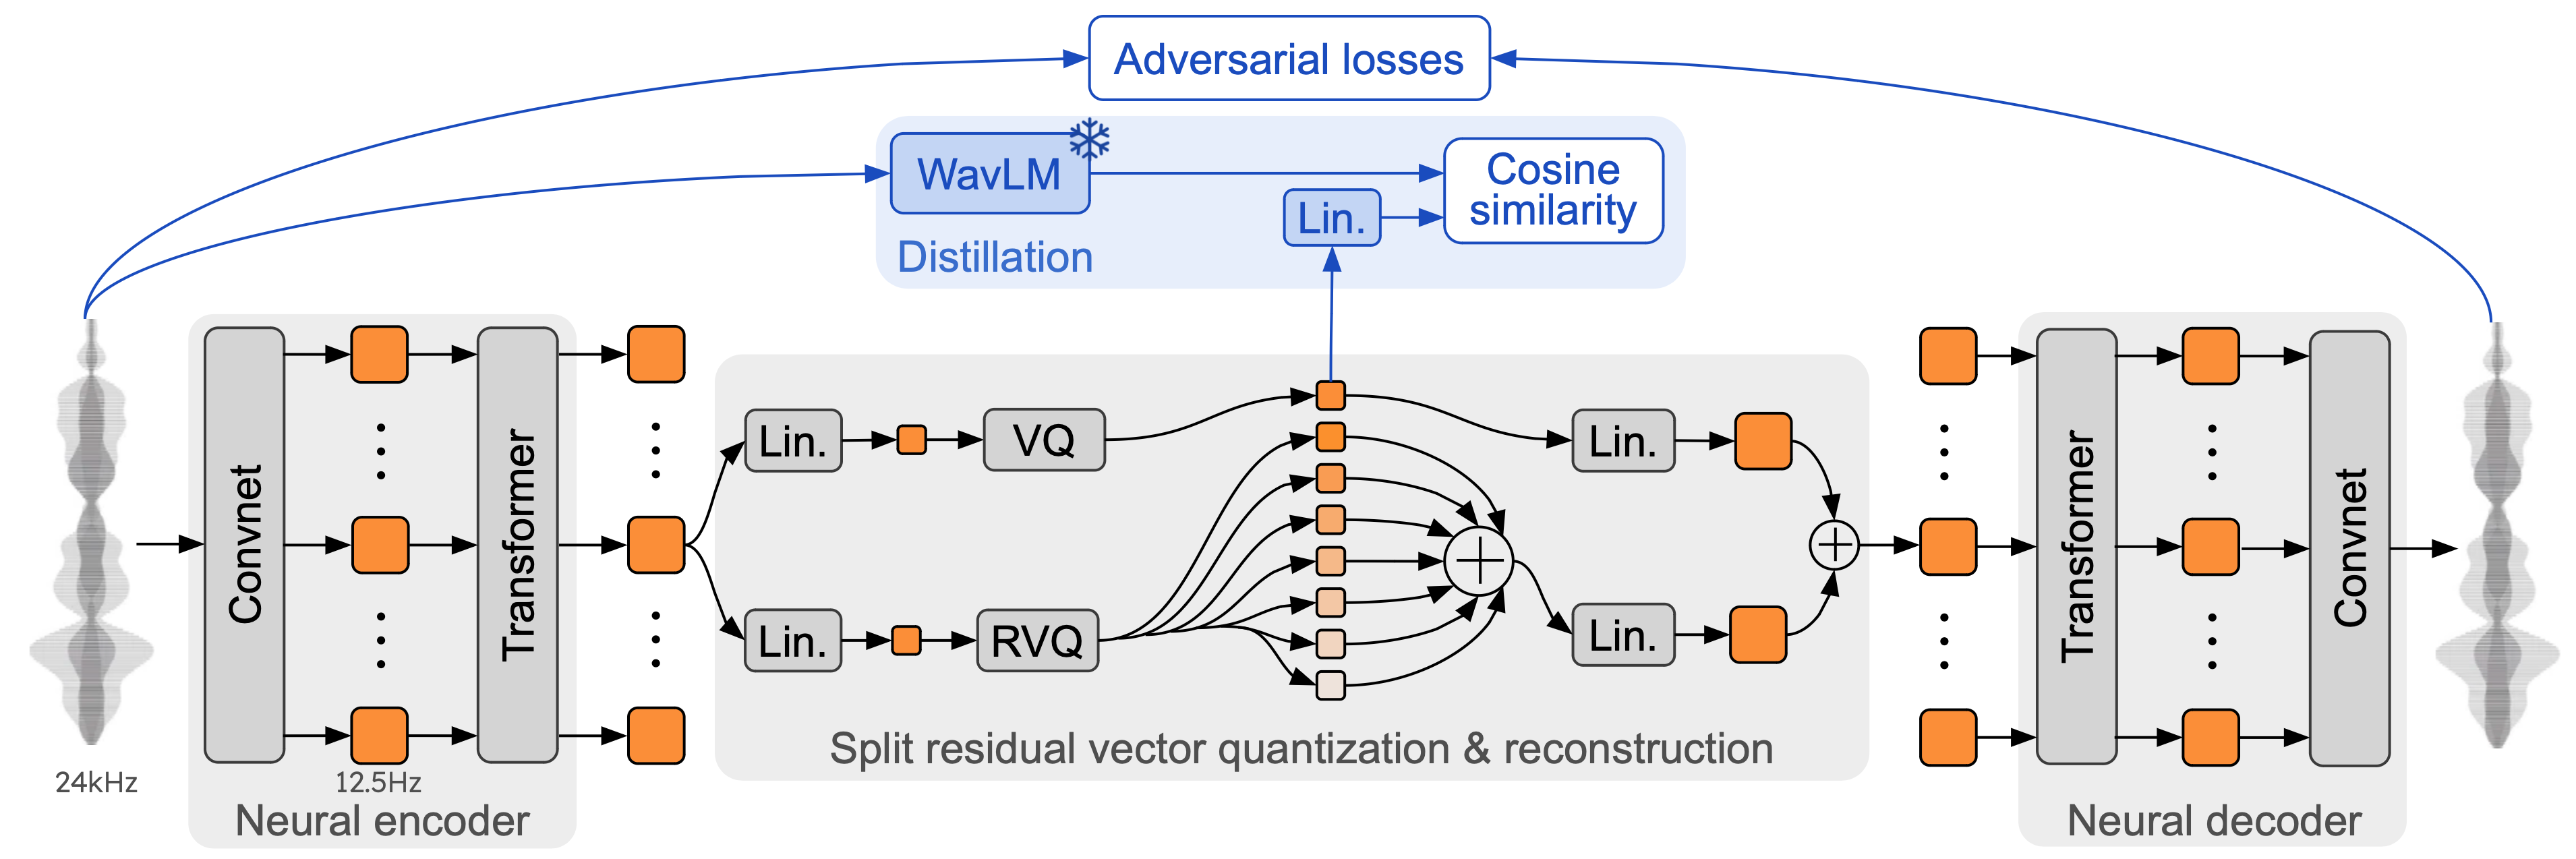
Mimiニューラルオーディオコーデック:MimiはMoshiの音声処理コンポーネントです。ニューラルネットワークオーディオコーデックであり、音声を離散的な音声トークンに変換し、逆に高品質な音声出力を生成する役割を担います。
Mimiは残差ベクトル量子化(RVQ)技術を使用して、音声データを離散的な音声および意味トークンにエンコードし、高い音声忠実度と言語一貫性を保証します。
意味トークンと音響トークンを組み合わせることで、Mimiは自然な音声を生成できるだけでなく、複雑な音声コンテキストや感情情報も処理できます。
内面モノローグ法:内面モノローグ法は、Moshiの音声生成における重要な技術であり、モデルが音声を生成する前に音声と同期したテキストトークンを予測できるようにします。この方法は、生成される音声の言語品質を向上させるだけでなく、Moshiがストリーミング環境下で音声認識とテキスト読み上げ機能を実現することも可能にします。
テキストと音声の同期生成:音声を生成する前に、Moshiはその音声出力に対応するテキストストリームを生成します。このテキストストリームが音声生成の基盤となり、音声生成をより正確にするとともに、複雑な対話シナリオの処理にも役立ちます。
ストリーミング互換性:この方法により、Moshiは音声を処理しながら、ストリーミング環境で効率的な音声認識とテキスト読み上げ(TTS)を実現できます。
このモデルアーキテクチャは、複数の並列オーディオストリームを処理し、音声とテキストをリアルタイムで生成するように設計されています。Moshiはユーザーの音声を処理しながらシステム音声を生成することができ、これにより途切れない自然な対話をサポートできます。
Moshiの詳細な技術的手法
1. 音声対音声生成アーキテクチャ
Moshiの中核的な革新は、音声対話を、従来のテキスト→音声→音声という複数コンポーネントのプロセスではなく、音声対音声の生成タスクとして捉えることです。従来の音声対話システムは、音声活動検出(VAD)、音声認識(ASR)、自然言語理解(NLU)、自然言語生成(NLG)、テキスト読み上げ(TTS)などの複数の独立したモジュールで構成されています。
Moshiは音声トークンを直接生成するため、理解と生成のプロセスにおいて中間テキスト表現に依存せず、感情、语调、非言語音などの情報の損失を回避します。
2. Heliumテキスト言語モデル
MoshiはHeliumテキスト言語モデルに基づいており、これは7Bパラメータを持つ大規模なテキスト生成モデルです。Heliumは2.1兆件の英語データで事前学習されており、強力な言語理解、推論、生成能力を備えています。これはMoshiの意味理解の基盤であり、オープンドメイン対話や質問応答を含む複雑な自然言語処理機能をサポートします。
Heliumの主な特徴:
自己回帰型Transformerアーキテクチャ:Moshiは、Transformerアーキテクチャに基づくテキスト言語モデルであるHeliumに基づいています。古典的なTransformerと同様に、Heliumは多層の注意機構と自己回帰モデリング手法を使用してテキスト入力を処理し、出力を生成します。このモデルは7Bパラメータを持ち、大規模コーパスの学習に十分対応できます。
RMS正規化:注意モジュール、フィードフォワードモジュール、出力層でRMS正規化を使用し、モデルの学習安定性を向上させます。
回転位置埋め込み(RoPE):長いコンテキストウィンドウ(4096トークン)を処理するために使用され、モデルが対話における長距離依存関係を捕捉できるようにします。
効率的なFlashAttention:最適化された注意計算により、長いシーケンス入力下でのモデル推論がより効率的になります。
3. Mimiニューラルオーディオコーデック
Mimiは、Moshiにおける音声処理用のニューラルオーディオコーデックです。そのタスクは、連続的な音声信号を離散的なオーディオトークンに変換することです。これらの離散的なオーディオトークンはテキストトークンに類似しており、音声内の詳細情報を表現できます。Mimiは残差ベクトル量子化(RVQ)技術を採用しており、低ビットレートで高品質なオーディオを保持し、リアルタイム音声生成と処理をサポートします。
Mimiの主要技術:
残差ベクトル量子化(RVQ):Mimiは多段階の残差ベクトル量子化を使用して、複雑なオーディオ信号を複数レベルのオーディオトークンに離散化します。このアプローチにより、各時間ステップで音声の意味情報と音響情報の両方を効率的にエンコードしつつ、音声再構築の品質を確保できます。
意味トークンと音響トークンの組み合わせ:Mimiが使用するオーディオトークンには、意味情報と音響情報の両方が含まれます。意味トークンは音声の内容(例えば話された特定の単語)を保持し、音響トークンは音色、感情、语调などの音声のオーディオ特徴を記述します。
ストリーミングエンコードとデコード:Mimiはストリーミングをサポートしており、リアルタイム対話における連続的な音声生成と認識を実現できます。これにより、Moshiの応答速度が自然な会話に非常に近くなります。
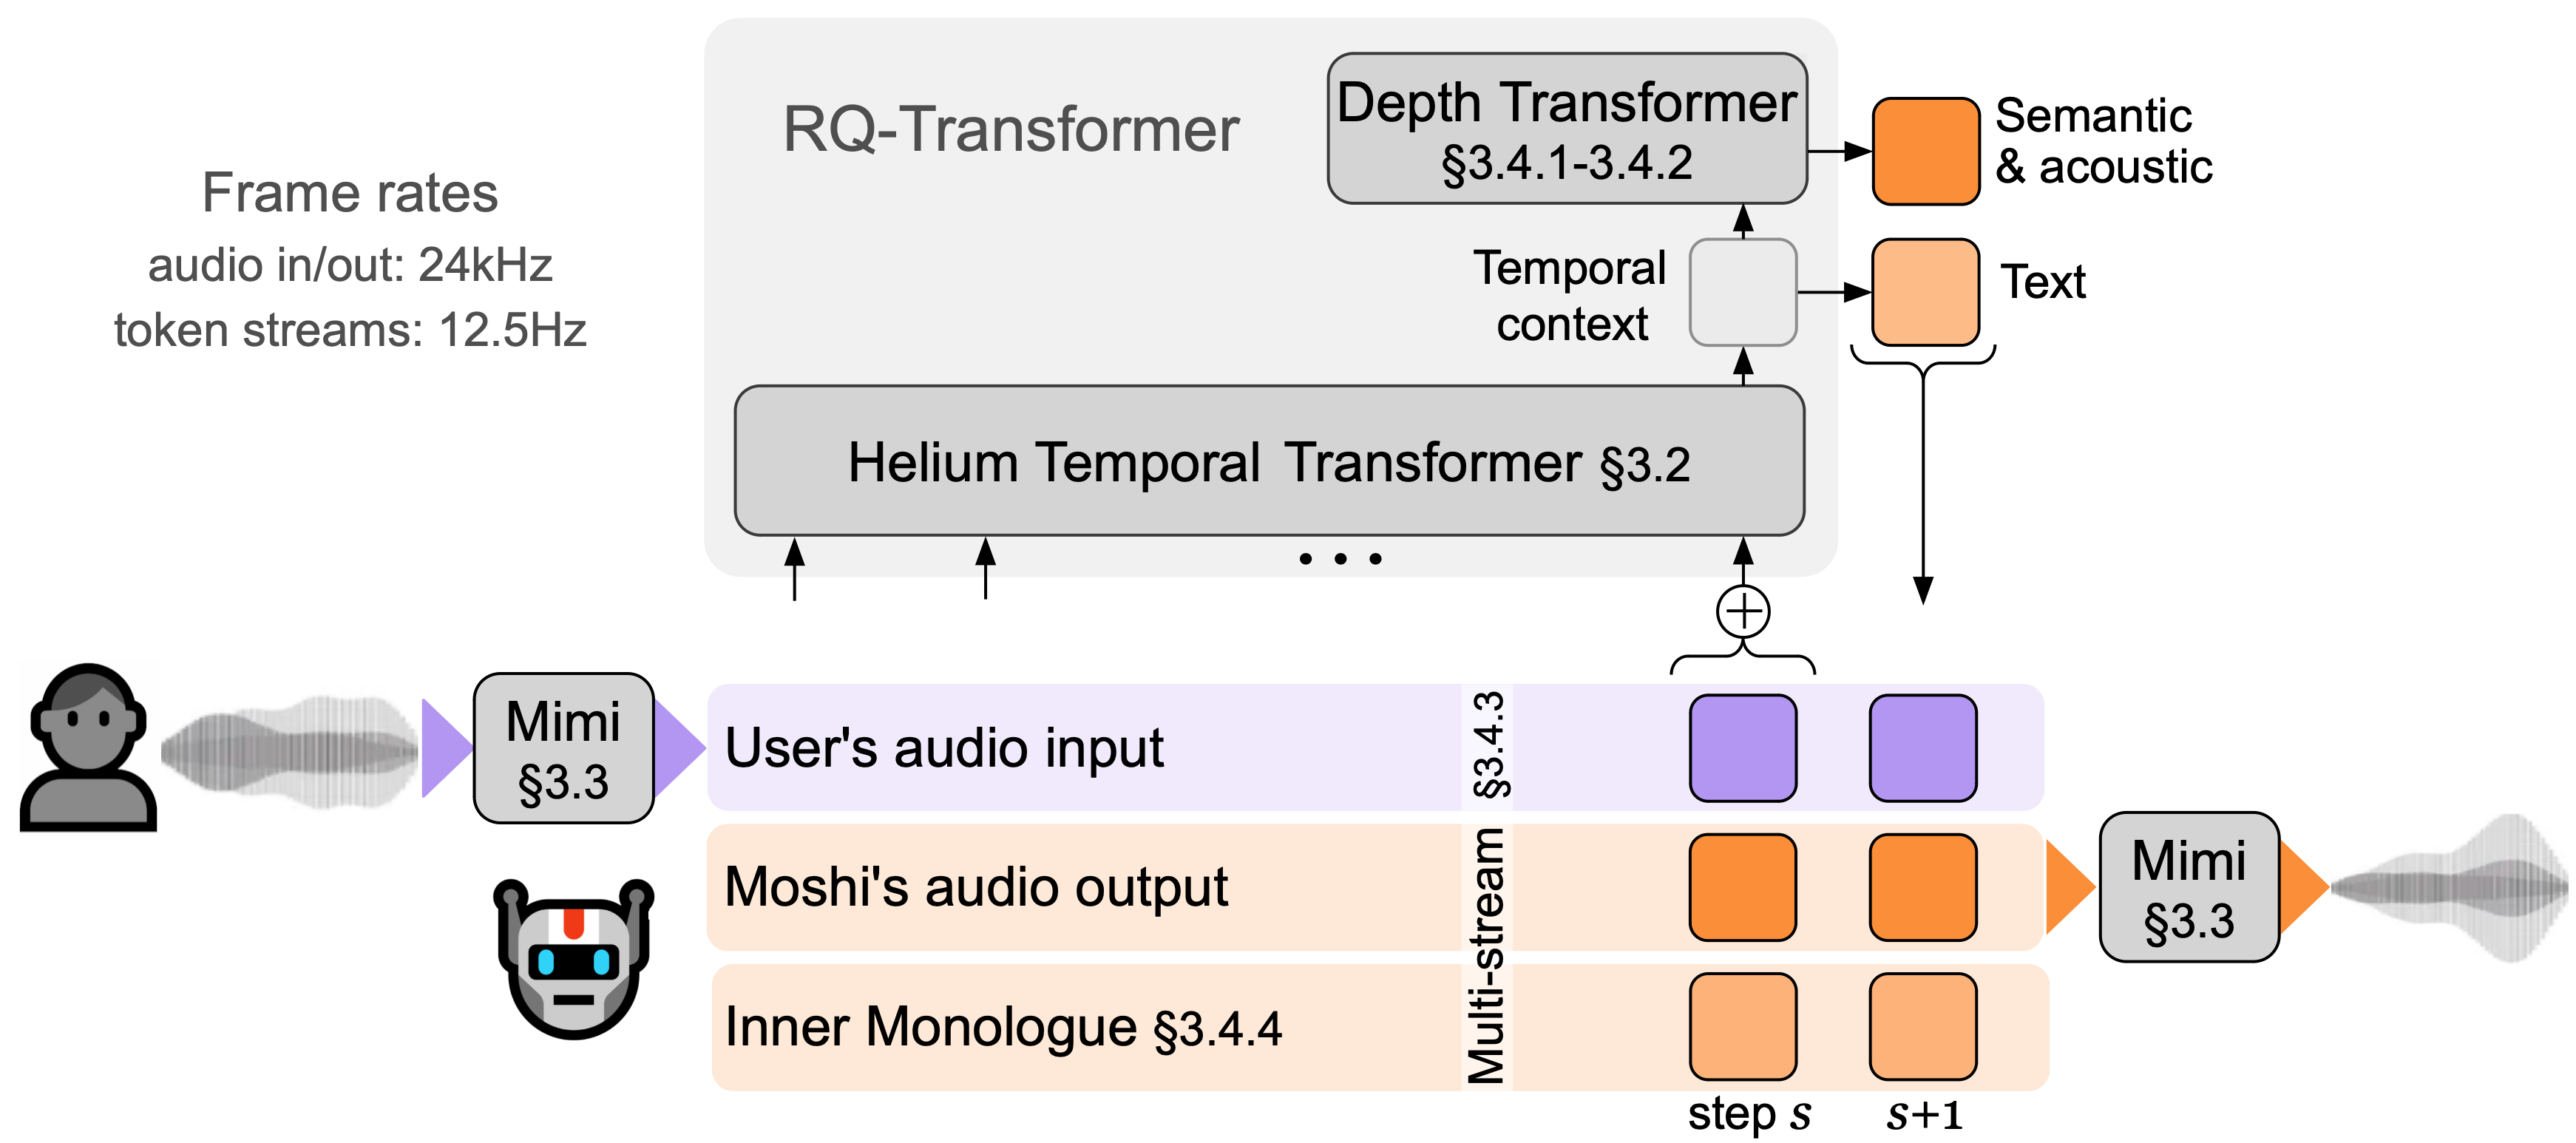
4. RQ-TransformerのアーキテクチャMoshiは多層ストリーム階層生成アーキテクチャを採用しており、複数のオーディオストリームを並列処理できます。Moshiはユーザーの音声ストリームとシステム自身の音声ストリームを同時に処理することで、対話における柔軟なインタラクションを実現し、話者間の割り込みや相槌、感嘆詞などの複雑な対話ダイナミクスを可能にします。
これは以前に提案された離散画像生成のためのアーキテクチャであり、Heliumのシーケンス長を増加させることなく、意味的および音響トークンの階層構造をモデル化できます。これは、毎秒のオーディオを7Bバックボーンモデルで12.5回通過させるだけで、L4またはM3 MacBook Pro上でリアルタイムに実行できることを意味します!MusicGenのトークン遅延と組み合わせることで、音声言語モデリングに最先端のパフォーマンスを提供します。
階層的自己回帰モデリング:MoshiはRQ-Transformer(Residual Quantizer Transformer)を使用してオーディオトークンを複数のレベルに分解し、階層的自己回帰モデリングによってオーディオを生成します。具体的には、モデルは大規模なTemporal Transformerをまず使用して時系列を処理し、その後、各タイムステップで小さなDepth Transformerを使用して複数のサブシーケンスを処理します。この設計により、長尺のオーディオシーケンス生成の効率が大幅に向上します。
マルチモーダルシーケンス生成:モデルはテキスト、意味トークン、オーディオトークンを含む複数のシーケンスを同時に生成し、内部モノローグメカニズムによって時間的に正確に整列させます。各タイムステップで生成される内容には、現在の音声だけでなく対応するテキストプレフィックスも含まれ、生成される音声内容の意味的論理性が向上します。
RQ-Transformerのアーキテクチャ
5、「内なる独白」メカニズム
Moshiの「内なる独白」メカニズムは、音声生成における重要な革新の一つです。このメカニズムを通じて、Moshiはオーディオを生成する前に、対応する時間的に整列されたテキストトークンを予測します。これにより、生成された音声の言語的一貫性が向上するだけでなく、リアルタイム音声認識(ASR)およびテキスト読み上げ(TTS)変換もサポートされます。
「内なる独白」メカニズムの特徴:
整列されたテキストとオーディオ生成:Moshiはまずテキストを予測してからオーディオを生成するため、生成される音声は文法と内容の点でより正確で流暢になります。
遅延メカニズム:テキストとオーディオの間に遅延を導入することで、MoshiはASRとTTSのタスクを別々に実行できます。例えば、最初にテキストを生成し、後からオーディオを生成する場合はモデルはTTSモード、それ以外の場合はASRモードになります。Moshiはこれら2つのモード間をシームレスに切り替えることができ、モデルが音声の生成と認識の両方を行うことを可能にします。
Moshi:遅延メカニズム
Moshi:TTSモード
6. マルチストリームモデリング
Moshiのアーキテクチャは複数のオーディオストリームの同時処理を可能にし、ユーザーの音声を監視すると同時にシステム自身の音声を生成することもできます。対話プロセス中、Moshiはオーディオの重複部分(割り込みや交互発話など)を動的に処理でき、話者のターンを事前に明示的に区切る必要がありません。この技術により、対話がより自然になります。
意味トークンと音響トークンの同期生成:Moshiは並列的な意味トークンとオーディオトークン生成メカニズムを使用し、これらのトークン間の依存関係を最適化するために時間遅延を導入します。ユーザーとシステムのオーディオストリームを正確にモデリングすることで、Moshiは複雑な対話シナリオに柔軟に対応できます。
デュアルストリームオーディオ処理:Moshiはユーザーとシステムの音声ストリームを同時に処理し、2つの自己回帰オーディオストリームを並列モデリングすることで全二重通信を実現します。この設計により、モデルは自然対話における重複音声や割り込みに対応できます。
意味とオーディオの遅延整列:意味トークンとオーディオトークンの間に遅延を導入することで、生成される音声内容の一貫性と効率性を保証します。遅延は対話のダイナミクスに応じて1〜2フレームとなります。
Moshi:マルチストリームモデリング
7. モデルの学習とファインチューニング
大規模事前学習:Moshiのテキスト言語モデル(Helium)は、2.1兆を超える英語トークンでの事前学習により、豊富な言語理解および生成能力を備えています。このモデルは大規模なテキストと音声データで学習されており、さまざまな複雑な対話シナリオを処理できます。
教師なしおよび教師ありの多段階学習:Moshiはまず大規模な教師なし音声データで事前学習され、その後、自然な対話を含むマルチストリームデータでポストトレーニングされ、実際の対話でのパフォーマンス向上のために指示ファインチューニングが行われます。
Heliumの事前学習:まず最初に、大規模なテキストデータセットでHeliumテキスト言語モデルを事前学習し、言語理解と推論能力を向上させます。
Moshiの事前学習:ラベルなしのオーディオデータセットでマルチストリームオーディオモデルを学習し、音声生成と意味理解の処理を学習します。
マルチストリームファインチューニング:Fisherデータセット(2チャンネルの音声対話データを含む)を使用してモデルをファインチューニングし、マルチストリーム音声入力の処理能力を向上させます。
指示ファインチューニング:最後に、生成された指示対話データを使用してファインチューニングを行い、自然な対話シナリオでのモデルのパフォーマンスを強化します。
データ拡張:学習プロセス中、Moshiは背景ノイズの追加やユーザーエコーのシミュレーションなどのデータ拡張技術を使用し、モデルがさまざまな音声環境で安定して動作し、堅牢性を強化します。
Moshiのパフォーマンス評価
1. 音声生成の品質と一貫性
音声の明瞭度:Moshiは音声生成において優れたパフォーマンスを示し、高品質で理解しやすい音声を生成できることが実験で示されています。生成プロセス中、特に長い対話において音声の一貫性を維持でき、これは複雑なコンテキストでの対話モデルにとって重要な性能指標です。
音声の自然性と一貫性:Mimiニューラルオーディオコーデックを使用することで、Moshiはハイファイ音声を生成し、システム音声の一貫性を維持できます。さらに、モデルは異なる対話コンテキストに基づいて適切な感情的なイントネーションを生成することができ、ユーザー体験の自然さを向上させます。
2. リアルタイム応答性能
低遅延:Moshiの遅延は理論的には160ミリ秒で、実際のテストでは約200ミリ秒です。これはMoshiがほぼリアルタイムでユーザーの入力に対応できることを示し、対話の流暢性とユーザーエクスペリエンスを大幅に向上させます。
全二重通信能力:Moshiはテストにおいて、音声の同時受信と生成能力を実証しました。この全二重機能により、重複音声や対話の割り込みを処理でき、自然な人間の対話に近い応答速度を示します。
3. 音声認識と対話理解
自動音声認識(ASR):内なる独白アプローチを通じて、Moshiはテキストと音声ストリームを組み合わせて音声認識の精度を大幅に向上させます。このモデルはユーザーの音声入力をキャプチャするだけでなく、最初にテキスト予測を生成することでシステムの応答精度を強化します。
対話理解と推論能力:MoshiはHelium言語モデルを使用してテキスト理解と推論を行うため、複雑な問題、オープンエンドな対話、知識質疑応答を処理する際に優れたパフォーマンスを発揮します。実験結果は、Moshiがコンテキストを効果的に理解し、合理的な回答を提供できることを示しています。
4. マルチストリーム音声処理の堅牢性
重複音声処理:Moshiは評価において、複数の音声ストリームが重複する対話などの複雑な対話シナリオを処理できます。これは、実際のアプリケーションにおけるマルチタスク処理にとって重要です。自然対話は通常、割り込みや重複音声を含むためです。
マルチコンテキスト対話処理:Moshiは複数のデータストリームで学習されており、単一ユーザーの音声ストリームから複数ユーザーとの同時対話まで、さまざまな状況で優れたパフォーマンスを発揮します。
5. 質疑応答と知識取得
Moshiは質疑応答と知識取得タスクにおいて、現在の他の音声対話システムよりも優れています。強力なテキスト理解能力とリアルタイム音声生成能力を備え、マルチラウンド質疑応答を構築でき、ユーザーの質問を正確に抽出して回答できます。
言語推論と常識質疑応答:このモデルは複雑な推論タスクを処理でき、常識質疑応答、読解、オープンエンド質疑応答など、自然言語処理(NLP)のさまざまな標準評価で優れたパフォーマンスを発揮します。
6. 音声感情とパーソナライズ生成
感情的音声生成:Moshiは評価において、感情的な音声を生成する能力を実証しました。対話のコンテキストに応じて、怒り、喜び、悲しみなど異なる感情を持つ音声出力を生成できます。
パーソナライズされた音声スタイル:学習中の指示ファインチューニングを通じて、Moshiはユーザーのニーズに応じて異なるスタイルや特定のキャラクターの音声を生成できます。このパーソナライズ機能により、特定の対話シナリオでより多様なパフォーマンスを発揮します。
7. 安全性と信頼性
安全な対話評価:Moshiは機密性や不適切なコンテンツを含む対話の処理において、優れた安全性を示します。不適切なコンテンツの生成を効果的に識別および回避でき、対話の安全性と倫理性を保証します。
堅牢性とノイズ環境への適応:ノイズや複雑な環境の評価において、Moshiは優れた堅牢性を示しています。ノイズ付加やエコー処理などのデータ拡張技術により、このモデルはさまざまな音声環境に対応し、ノイズ環境下でも高品質な出力を保証します。
八、総合テスト結果
Moshiの総合パフォーマンステストは、音声生成、対話理解、リアルタイム応答、複雑な対話処理などの面でリードする結果を示しました。特に、Moshiは重複対話、音声割り込み、感情生成などの処理において、従来の対話システムをはるかに上回るパフォーマンスを示しました。
技術レポート: https://kyutai.org/Moshi.pdf
GitHub: https://github.com/kyutai-labs/moshi
モデルダウンロード: https ://huggingface.co/collections/kyutai/moshi-v01-release-66eaeaf3302bef6bd9ad7acd
オンラインで試す: https://moshi.chat/
関連情報:














